
使用nodejs爬前程无忧前端技能排行(半半成品)
最近准备换工作,需要更新一下技能树。为做到有的放矢,想对招聘方的要求做个统计。正好之前了解过nodejs,所以做了个爬虫搜索数据。
具体步骤:
1. 先用fiddler分析请求需要的header和body。
2. 再用superagent构建上述数据发送客户端请求。
3. 最后对返回的数据使用cheerio整理。
折腾了几个晚上,只搞出了个架子,剩余工作等有时间再继续开发。
/*使用fiddler抓包,需要配置lan代理,且设置如下参数*/

process.env.https_proxy = "http://127.0.0.1:8888";

process.env.http_proxy = "http://127.0.0.1:8888";

process.env.NODE_TLS_REJECT_UNAUTHORIZED = "0";

/*使用到的模块*/

var request = require('superagent');    //发送客户端请求

require('superagent-proxy')(request);   //使用代理发送请求

var cheerio = require('cheerio');       //以jq类似的方法操作返回的字符,不需要用正则

require('superagent-charset')(request);//node不支持gbk,gb2312,this will add request.Request.prototype.charset.

var async = require('async');           //异步流控制模块

var fs = require('fs');

/*相关参数,通过fiddler抓包后复制过来*/

var ws = fs.createWriteStream('res.html',{flags:'w+'}); //a+追加的读写模式,w+覆盖

var loginUrl = "https://login.51job.com/login.php";

var searchUrl = "http://search.51job.com/jobsearch/search_result.php";

var queryStrings = "fromJs=1&jobarea=020000&keyword=%E5%89%8D%E7%AB%AF%E5%BC%80%E5%8F%91&keywordtype=2&lang=c&stype=2&postchannel=0000&fromType=1&confirmdate=9";

var loginForms = {

    lang: 'c',

    action: 'save',

    from_domain: 'i',

    loginname: '***',   //自己的用户名和密码

    password: '***',

    verifycode: '',

    isread: 'on'

};

var searchForms = {

    lang: 'c',

    stype: '2',

    postchannel: '0000',

    fromType: '1',

    line: '',

    confirmdate: '9',

    from: '',

    keywordtype: '2',

    keyword: '%E5%89%8D%E7%AB%AF%E5%BC%80%E5%8F%91',

    jobarea: '020000',

    industrytype: '',

    funtype: ''

};

var searchFormsString='lang=c&stype=2&postchannel=0000&fromType=1&line=&confirmdate=9&from=&keywordtype=2&keyword=%C7%B0%B6%CB%BF%AA%B7%A2&jobarea=020000&industrytype=&funtype=';

var proxy0 = process.env.https_proxy;

var proxy = process.env.http_proxy;

const agent = request.agent();          //agent()方法产生的实例会保存cookie供后续使用

request.post(loginUrl).proxy(proxy0).send(loginForms).end(function (err,res0) {

    agent.post(searchUrl)

        .proxy(proxy)                   //proxy()方法需紧跟在method方法之后调用,否则fiddler抓不到数据包

        .type('application/x-www-form-urlencoded')

        .query(queryStrings)        //使用字符串格式

        .send(searchFormsString)

        .charset('gbk')                //通过charset可知编码字符格式,不设置会有乱码

        .end(function (err, res) {

            /* 以下是处理返回数据的逻辑代码*/

            var $ = cheerio.load(res.text);   //res.text是返回的报文主体

            async.each($('.el.title').nextAll('.el'), function(v, callback) {

                //将多余的内容删除,保留岗位、公司链接

                $(v).prepend($(v).find('.t1 a'));

                $(v).find('.t1').remove();

                ws.write($.html(v), 'utf8');

            }, function(err) {

                console.log(err);

            });

            console.log('successful');

        })

});

//jquery内置document元素为root,cheerio需要通过load方法传入,然后用选择器查找指定元素,再执行相应操作。

// $.html(el);静态方法,返回el元素的outerHtml

//TODO

// 1.当前只请求到一页数据,还需构建所有页数的请求列表

// 2.向每条数据的岗位链接发送请求,获取技能关键字,存入文件中

// 3.node中io操作是异步的,且没有锁的概念,如何并发地向同一个文件正确地写入数据
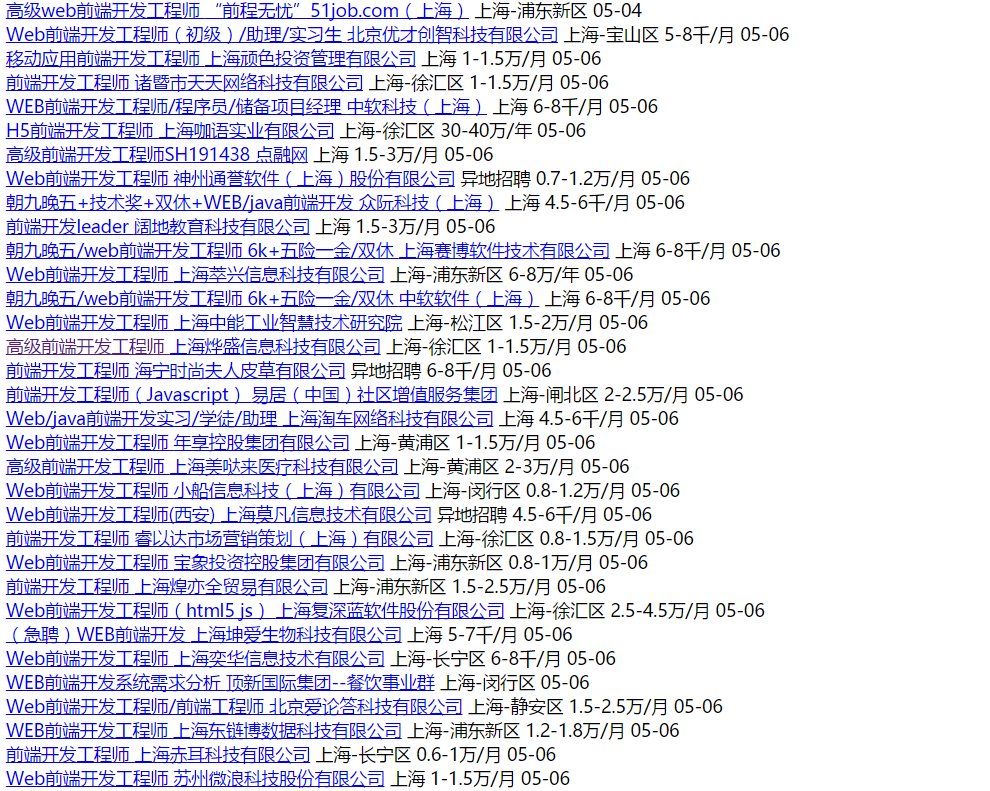
结果显示如下:
使用nodejs爬前程无忧前端技能排行(半半成品)的更多相关文章
- vue+node+mongoDB火车票H5(七)-- nodejs 爬12306查票接口
菜鸟一枚,业余一直想做个火车票查票的H5,前端页面什么的已经写好了,node+mongoDB 也写了一个车站的接口,但 接下来的爬12306获取车次信息数据一直卡住,网上的爬12306的大部分是pyt ...
- 爬取豆瓣电影排行top250
功能描述V1.0: 爬取豆瓣电影排行top250 功能分析: 使用的库 1.time 2.json 3.requests 4.BuautifulSoup 5.RequestException 上机实验 ...
- 【nodeJS爬虫】前端爬虫系列
写这篇 blog 其实一开始我是拒绝的,因为爬虫爬的就是cnblog博客园.搞不好编辑看到了就把我的账号给封了:). 言归正传,前端同学可能向来对爬虫不是很感冒,觉得爬虫需要用偏后端的语言,诸如 ph ...
- 京东前端:PhantomJS 和NodeJS在网站前端监控平台的最佳实践
1. 为什么需要一个前端监控系统 通常在一个大型的 Web 项目中有很多监控系统,比如后端的服务 API 监控,接口存活.调用.延迟等监控,这些一般都用来监控后台接口数据层面的信息.而且对于大型网站系 ...
- 使用nodejs爬取拉勾苏州和上海的.NET职位信息
最近开始找工作,本人苏州,面了几家都没有结果很是伤心.在拉勾上按照城市苏州关键字.NET来搜索一共才80来个职位,再用薪水一过滤,基本上没几个能投了.再加上最近苏州的房价蹭蹭的长,房贷压力也是非常大, ...
- Web前端技能
入门必备的技能: 第1项技能:HTML超文本标记语言: 技能要点: HTML文件的结构 HTML文件的编写方法 HTML基本标记 文字与段落标记 框架 使用表单 ...
- 前端技能汇总 Frontend Knowledge Structure
Frontend Knowledge Structure 项目起源 还记得@jayli 的这幅前端知识结构图么. 图片的形式具有诸多的不便.缺失源图的我们,无法为此图贡献些什么,随着时间的迁移,或许有 ...
- 从事web前端两年半后的迷茫
做了两年半的重构,突然有种迷茫的感觉,好像瓶颈了,不知道自己该怎么继续走下去,以前刚毕业的时候,总觉得自己有好多的东西要学在前端方面,所以有那个促使自己去学习的动力,每当没工作任务的时候,自己总是去主 ...
- 使用nodejs爬取和讯网高管增减持数据
为了抓取和讯网高管增减持的数据,首先得分析一下数据的来源: 网址: http://stockdata.stock.hexun.com/ggzjc/history.shtml 使用chrome开发者工具 ...
随机推荐
- AngularJS1.X学习笔记2-数据绑定
上一篇从整体上认识了Angular,从现在开始更加深入的学习Angular的特性.本次学习的是数据绑定.应该所有的MVC框架都会用到数据绑定,比如我所知道的ThinkPHP.struts等,只有实现了 ...
- 华为C语言编程规范笔记1
入职之前,公司培训,做了点笔记~
- java开发中经典的三大框架SSH
首先我们要明白什么是框架为什么用?相信一开始学习编程的时候都会听到什么.什么框架之类的:首先框架是一个软件半成品,都会预先实现一些通用功能,使用框架直接应用这些通用功能而不用重新实现,所以大多数企业都 ...
- 爬虫入门系列(一):快速理解HTTP协议
4月份给自己挖一个爬虫系列的坑,主要涉及HTTP 协议.正则表达式.爬虫框架 Scrapy.消息队列.数据库等内容. 爬虫的基本原理是模拟浏览器进行 HTTP 请求,理解 HTTP 协议是写爬虫的必备 ...
- Java中ArrayList,Vector,LinkedList,HashMap,HashTable,HashSet对比及总结
1.所有的集合的父类都是Collection的接口 2.Set List Map 区别 A 在Set里面:无法添加元素的顺序,所以Set里面的元素不能重复 B 在List中:有索引号,类似于数组, ...
- 程序设计 之 C#实现《拼图游戏》
功能描述: 1.用户自定义上传图片 2.游戏难度选择:简单(3*3).一般(5*5).困难(9*9)三个级别 3.纪录完成步数 模块: 1.拼图类 2.配置类 3.游戏菜单窗口 4.游戏运行窗口 -- ...
- kafka分布式消息队列介绍以及集群安装
简介 首先简单说下对kafka的理解: 1.kafka是一个分布式的消息缓存系统: 2.kafka集群中的服务器节点都被称作broker 3.kafka的客户端分为:一是producer(消息生产者) ...
- File类遍历目录及文件
1. 构造函数 File(String args0)//使用一个表示文件或目录的路径的字符串创建一个File对象 File(URL args0)//使用一个URL对象创建File对象 File(Fil ...
- qq面板(仿版,未完待续中。。。。)---2017-04-24
主要实现效果: 1.点击对话,显示对话:点击联系人,显示联系人 2.在联系人界面: 实现好友列表的展开与折叠:(图12) 实现鼠标移到好友列表上的背景颜色的变化:(图3) 选中的好友背景颜色改变(图4 ...
- stl_组件
2.1.STL中: 2.1.1.包含常用的数据结构. 2.1.2.包含常用的基本算法.结构和算法其实就是一些接口. 2.1.3.提供了一套可扩展的框架. 2.2.六大组件: 2.2.1.容器组件(基本 ...