
rancher2 HA部署注意事项
参考:
https://rancher.com/docs/rancher/v2.x/en/installation/ha-server-install/
https://www.cnblogs.com/rancher-maomao/p/8445111.html
部署要点:
域名解析准备:
域名解析至三个IP作轮询解析,类似下方:
rancher.qq.com 192.168.1.1
racher.qq.com 192.168.1.2
racher.qq.com 192.168.1.3
系统版本:
建议使用Ubuntu 16.04版本,CentOS7没有配置成功,需要修改的地方太多了;
Docker版本:
RKE在Github上的readme中已有说明,Kubernetes1.10.1需要Docker 1.13.1;
主机名:
如果是克隆的系统一定要修改主机名,hostname主机名必须不同!
主机文件:
/etc/hosts要配置正确,一定要有127.0.0.1 localhost 这一项。Hosts文件中包含所有主机节点的IP和名称列表。使用vi进行编辑,不能使用中文全角的空格;
SELinux:
必须关闭!Ubuntu 16.04默认未安装,无需设置。CentOS7下可修改配置文件/etc/sysconfig/selinux,设置SELINUX=disabled ,重启后永久关闭。
IPV4转发:
必须开启!Ubuntu 16.04下默认已启用,无需设置。
防火墙:
Ubuntu默认未启用UFW防火墙,无需设置。也可手工关闭:sudo ufw disable
禁用SWAP:
一定要禁用swap,否则kubelet组件无法运行,永久禁用swap可以直接修改/etc/fstab文件,注释掉swap项。swapoff -a 只是临时禁用,下次关机重启又恢复原样;
启用Cgroup:
修改配置文件/etc/default/grub,启用cgroup内存限额功能,配置两个参数:
GRUB_CMDLINE_LINUX_DEFAULT="cgroup_enable=memory swapaccount=1"
GRUB_CMDLINE_LINUX="cgroup_enable=memory swapaccount=1"
注意:要执行sudo update-grub 更新grub,然后重启系统后生效。
SSH免密登录:
ssh-keygen 全部回车
ssh-copy-id 用户名@IP
用户名为非root用户,执行命令时不要加sudo,本机也要。
RKE部署用户:
1、RKE部署用户是cluster.yml配置文件中的用户,也就是上述能ssh免密登录到其他机器的用户;
2、如果使用普通用户进行RKE安装,要将普通用户(如user01)加入到docker组,命令:sudo usermod -aG docker user01 注意:重启系统以后才能生效,只重启Docker服务是不行的!重启后,user01用户也可以直接使用docker run命令。
4、在Ubuntu上使用apt安装完docker后,会自动创建docker用户组,无需手工创建docker组,只需要将部署RKE的用户(如user01)加入到docker组即可,查看是否存在docker组、以及user01用户是否在docker组中,可以直接查看/etc/group文件;
5、修改配置文件/etc/ssh/sshd_config,将PermitRootLogin prohibit-password 改为PermitRootLogin yes ,允许root远程ssh登录;
取消注释#AuthorizedKeysFile %h/.ssh/authorized_keys ,允许记录授权秘钥文件;
RKE下载
https://github.com/rancher/rke/releases
rke_linux-amd64这个版本
yml文件下载
我下载的是公用证书,自签名类似,关键是下面几步
https://raw.githubusercontent.com/rancher/rancher/e9d29b3f3b9673421961c68adf0516807d1317eb/rke-templates/3-node-certificate-recognizedca.yml
下载之后,改名成自己喜欢的名称
注意需要配置的地方:
节点配置
nodes:

  - address: 1.1.1.1

	user: root

	role: [controlplane,etcd,worker]

	ssh_key_path: ~/.ssh/id_rsa

  - address: 2.2.2.2

	user: root

	role: [controlplane,etcd,worker]

	ssh_key_path: ~/.ssh/id_rsa

  - address: 3.3.3.3

	user: root

	role: [controlplane,etcd,worker]

	ssh_key_path: ~/.ssh/id_rsa
address 为自己的IP
用户名为可以免密登录的用户名。
以下为关键的证书配置
一般证书名为两个:
fullchain.pem与privkey.pem
自签名是三个,类似,具体位置见官方文档

cat FILENAME | base64 -w0
这个文件名是刚才证书的文件名,使用证书的文件生成base64 字符串,输入yml文档中
apiVersion: v1

kind: Secret

metadata:

  name: cattle-keys-ingress

  namespace: cattle-system

type: Opaque

data:

  tls.crt:
  tls.key:
注意这里的格式,在输入之前先备份,base64字条串为新起来行,顶行或crt:后面有空格
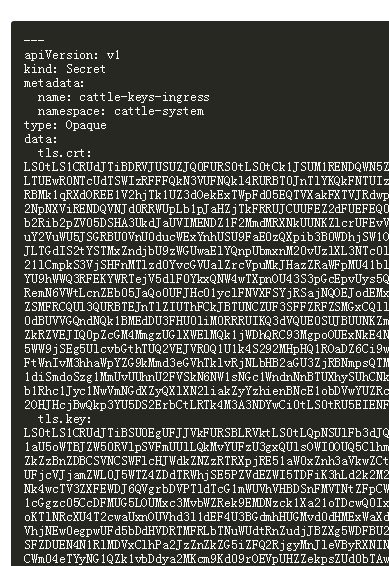
FQDN配置
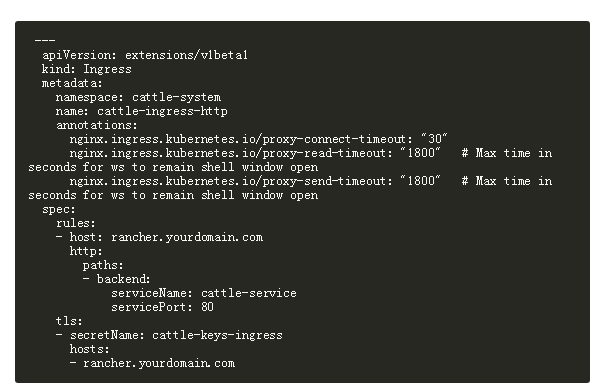
需要修改两处:
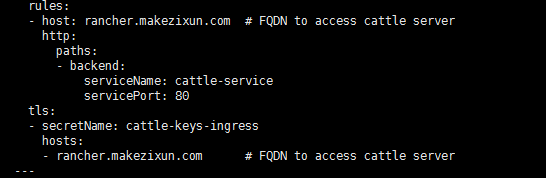
到些处,所有准备工作已经完成
./rke_linux-amd64 up --config rancher-cluster.yml 正式配置
不报错就成功
全部成功后,使用配置的域名访问,其它与单机安装一样。配置的域名就是FQDN。
rancher2 HA部署注意事项的更多相关文章
- Hadoop 学习笔记 (九) hadoop2.2.0 生产环境部署 HDFS HA部署方法
step1:将安装包hadoop-2.2.0.tar.gz存放到某一个目录下,并解压 step2:修改解压后的目录中的文件夹/etc/hadoop下的xml配置文件(如果文件不存在,则自己创建) 包括 ...
- ASP.NET生成WORD文档,服务器部署注意事项
网上转的,留查备用,我服务器装的office2007所以修改的是Microsoft Office word97 - 2003 文档这一个. ASP.NET生成WORD文档服务器部署注意事项 1.Asp ...
- wildfly8.1部署注意事项
wildfly8.1部署注意事项 jboss 最近新项目上线,本人部署过程中总结了以下几点比较关键的地方,看是否对大家有用处 服务器改成支持外网访问 在standalone.xml文件中找到 ...
- Harbor HA部署-使用Ceph RADOS后端
1. 前言 Harbor 1.4.0版本开始提供了HA部署方式,和非HA的主要区别就是把有状态的服务分离出来,使用外部集群,而不是运行在本地的容器上.而无状态的服务则可以部署在多个节点上,通过配置上层 ...
- [大数据] hadoop高可用(HA)部署(未完)
一.HA部署架构 如上图所示,我们可以将其分为三个部分: 1.NN和DN组成Hadoop业务组件.浅绿色部分. 2.中间深蓝色部分,为Journal Node,其为一个集群,用于提供高可用的共享文件存 ...
- k8s学习笔记(2)- Rancher2.x部署springboot应用及高可用、扩容
前言:上一篇介绍基于k3s环境,使用kubectl部署springboot简单项目应用,本篇介绍基于rancher2.x部署应用程序 1.上篇已部署一个springboot应用,我们可以通过ranch ...
- spark standalone zookeeper HA部署方式
虽然spark master挂掉的几率很低,不过还是被我遇到了一次.以前在spark standalone的文章中也介绍过standalone的ha,现在详细说下部署流程,其实也比较简单. 一.机器 ...
- Mesos编译步骤及部署注意事项(Ubuntu)
注意事项: 编译过程如果有错误提示少什么库,则相应的安装库即可在编译中出现 g++: internal compiler error: Killed (program cc1plus)的错误是因为内存 ...
- Hadoop HA部署
因为公司旧系统的Hadoop版本是2.2,所以在部署新系统时使用了旧系统. 但是在部署ResourceManager auto failover时发现其他nodemanager总是向0.0.0.0请求 ...
随机推荐
- C#内存管理和垃圾回收机制
数据类型 垃圾回收机制 一.数据类型 C#中的数据类型分为值类型 (Value type) 和引用类型(reference type), 值 类 型: 所有的值类型都集成自 System.Value ...
- Node.js之process模块
注意⚠️:process为nodejs内置对象,不需要实例化,改模块用来与当前进程进行互动,可以通过全局变量process访问,它是一个EventEmitter对象的实例. process对象提供一系 ...
- scrapy中deferred的回调
def _next_request_from_scheduler(self, spider):#在引擎中处理一个请求 slot = self.slot request = slot.scheduler ...
- leetcode987
public class Solution { private Dictionary<int, List<KeyValuePair<int,int>>> dic = ...
- node.js 爬虫动态代理ip
参考文章: https://andyliwr.github.io/2017/12/05/nodejs_spider_ip/ https://segmentfault.com/q/10100000081 ...
- 浅谈transient关键字
1,用途 当一个对象实现了Serilizable接口,这个对象就可以被序列化.而有时候我们可能要求:当对象被序列化时(写入字节序列到目标文件)时,有些属性需要序列化,而其他属性不需要被序列化,打个比方 ...
- Hadoop 基本原理
Hadoop 有2大核心HDFS (Hadoop Distributed File System)分布式文件系统 , MapRedurce 归约计算 HDFS 把文件按块存储, NameNode ...
- 代码直连指定ip的dubbo服务
http://blog.csdn.net/buqutianya/article/details/69229384
- cx_Oracle.DatabaseError: DPI-1047
ODPI-C Installation¶ Overview Oracle Client and Database Versions Linux Oracle Instant Client Zip Or ...
- 2:if 语句
if 语句 语法形式: 第一种,只有两个分支: if 表达式: something else: something 第二种,有多个分支: if 表达式1: do something 1 elif 表达 ...