
Spark MLlib线性回归代码实现及结果展示
线性回归(Linear Regression)是利用称为线性回归方程的最小平方函数对一个或多个自变量和因变量之间关系进行建模的一种回归分析。
这种函数是一个或多个称为回归系数的模型参数的线性组合。只有一个自变量的情况称为一元线性回归,大于一个自变量情况的叫做多元线性回归。
代码实现:
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.DataFrame
import org.apache.spark.ml.feature.VectorAssembler
import org.apache.spark.ml.regression.LinearRegression
/**
* Created by zhen on 2018/3/10.
*/
object LinearRegression {
def main(args: Array[String]) {
//设置环境
val spark = SparkSession.builder ().appName ("LinearRegressionTest").master ("local[2]").getOrCreate()
val sc = spark.sparkContext
val sqlContext = spark.sqlContext
//准备训练集合
val raw_data = sc.textFile("src/sparkMLlib/man.txt")
val map_data = raw_data.map{x=>
val mid = x.replaceAll(","," ,")
val split_list = mid.substring(0,mid.length-1).split(",")
for(x <- 0 until split_list.length){
if(split_list(x).trim.equals("")) split_list(x) = "0.0" else split_list(x) = split_list(x).trim
}
( split_list(1).toDouble,split_list(2).toDouble,split_list(3).toDouble,split_list(4).toDouble,
split_list(5).toDouble,split_list(6).toDouble,split_list(7).toDouble,split_list(8).toDouble,
split_list(9).toDouble,split_list(10).toDouble,split_list(11).toDouble)
}
val mid = map_data.sample(false,0.6,0)//随机取样,训练模型
val df = sqlContext.createDataFrame(mid)
val colArray = Array("c1", "c2", "c3", "c4", "c5", "c6", "c7", "c8", "c9", "c10", "c11")
val data = df.toDF("c1", "c2", "c3", "c4", "c5", "c6", "c7", "c8", "c9", "c10", "c11")
val assembler = new VectorAssembler().setInputCols(colArray).setOutputCol("features")
val vecDF = assembler.transform(data)
//准备预测集合
val map_data_for_predict = map_data
val df_for_predict = sqlContext.createDataFrame(map_data_for_predict)
val data_for_predict = df_for_predict.toDF("c1", "c2", "c3", "c4", "c5", "c6", "c7", "c8", "c9", "c10", "c11")
val colArray_for_predict = Array("c1", "c2", "c3", "c4", "c5", "c6", "c7", "c8", "c9", "c10", "c11")
val assembler_for_predict = new VectorAssembler().setInputCols(colArray_for_predict).setOutputCol("features")
val vecDF_for_predict: DataFrame = assembler_for_predict.transform(data_for_predict)
// 建立模型,进行预测
// 设置线性回归参数
val lr1 = new LinearRegression()
val lr2 = lr1.setFeaturesCol("features").setLabelCol("c5").setFitIntercept(true)
// RegParam:正则化
val lr3 = lr2.setMaxIter(10).setRegParam(0.3).setElasticNetParam(0.8)
// 将训练集合代入模型进行训练
val lrModel = lr3.fit(vecDF)
// 输出模型全部参数
lrModel.extractParamMap()
//coefficients 系数 intercept 截距
println(s"Coefficients: ${lrModel.coefficients} Intercept: ${lrModel.intercept}")
// 模型进行评价
val trainingSummary = lrModel.summary
trainingSummary.residuals.show()
println(s"均方根差: ${trainingSummary.rootMeanSquaredError}")//RMSE:均方根差
println(s"判定系数: ${trainingSummary.r2}")//r2:判定系数,也称为拟合优度,越接近1越好
val predictions = lrModel.transform(vecDF_for_predict)
val predict_result = predictions.selectExpr("features","c5", "round(prediction,1) as prediction")
predict_result.rdd.saveAsTextFile("src/sparkMLlib/manResult")
sc.stop()
}
}
性能评估:

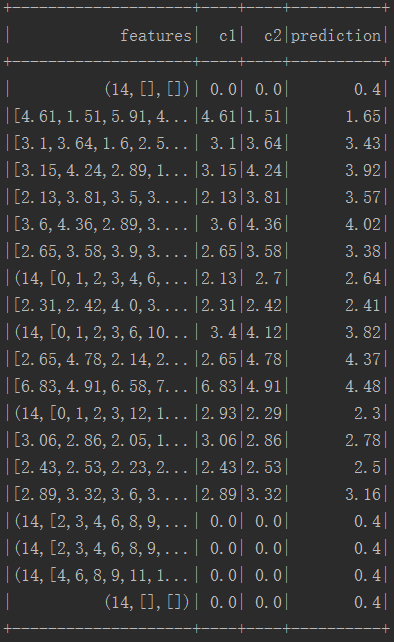
结果:
Spark MLlib线性回归代码实现及结果展示的更多相关文章
- Spark MLlib 示例代码阅读
阅读前提:有一定的机器学习基础, 本文重点面向的是应用,至于机器学习的相关复杂理论和优化理论,还是多多看论文,初学者推荐Ng的公开课 /* * Licensed to the Apache Softw ...
- Spark MLlib回归算法------线性回归、逻辑回归、SVM和ALS
Spark MLlib回归算法------线性回归.逻辑回归.SVM和ALS 1.线性回归: (1)模型的建立: 回归正则化方法(Lasso,Ridge和ElasticNet)在高维和数据集变量之间多 ...
- Spark MLlib之线性回归源代码分析
1.理论基础 线性回归(Linear Regression)问题属于监督学习(Supervised Learning)范畴,又称分类(Classification)或归纳学习(Inductive Le ...
- Spark mllib 随机森林算法的简单应用(附代码)
此前用自己实现的随机森林算法,应用在titanic生还者预测的数据集上.事实上,有很多开源的算法包供我们使用.无论是本地的机器学习算法包sklearn 还是分布式的spark mllib,都是非常不错 ...
- Spark Mllib里如何生成KMeans的训练样本数据、生成线性回归的训练样本数据、生成逻辑回归的训练样本数据和其他数据生成
不多说,直接上干货! 具体,见 Spark Mllib机器学习(算法.源码及实战详解)的第2章 Spark数据操作
- Spark入门实战系列--8.Spark MLlib(上)--机器学习及SparkMLlib简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .机器学习概念 1.1 机器学习的定义 在维基百科上对机器学习提出以下几种定义: l“机器学 ...
- Spark MLlib 机器学习
本章导读 机器学习(machine learning, ML)是一门涉及概率论.统计学.逼近论.凸分析.算法复杂度理论等多领域的交叉学科.ML专注于研究计算机模拟或实现人类的学习行为,以获取新知识.新 ...
- 《Spark MLlib机器学习实践》内容简介、目录
http://product.dangdang.com/23829918.html Spark作为新兴的.应用范围最为广泛的大数据处理开源框架引起了广泛的关注,它吸引了大量程序设计和开发人员进行相 ...
- Spark入门实战系列--8.Spark MLlib(下)--机器学习库SparkMLlib实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .MLlib实例 1.1 聚类实例 1.1.1 算法说明 聚类(Cluster analys ...
随机推荐
- Web中的积累:外观模式 Facade
摘要: 原创出处: http://www.cnblogs.com/Alandre/ 泥沙砖瓦浆木匠 希望转载,保留摘要,谢谢! 壹 前言 目测好久没写文章了,距离上一篇文章也有二十多天.我是怎么了?哈 ...
- 搭建企业级PPTP服务器
本文收录在企业项目实战系列 一.VPN 介绍 1.介绍 虚拟私人网络(英语:Virtual Private Network,缩写为VPN)是一种常用于连接中.大型企业或团体与团体间的私人网络的通讯方法 ...
- MySQL/MariaDB表表达式(3):视图
视图是表表达式的一种,所以它也是虚拟表.对视图操作的时候会通过语句动态的从表中临时获取数据. 1.创建.修改视图 CREATE [OR REPLACE] [ALGORITHM = {UNDEFINED ...
- advanced installer重新打包教程
一.简介 本次利用Advanced Installer软件里的Repackager重封装工具进行测试制作MSI安装包,还开可以利用Advanced Installerr制作MSI安装包 原理为执行两次 ...
- RNN入门(4)利用LSTM实现整数加法运算
本文将介绍LSTM模型在实现整数加法方面的应用. 我们以0-255之间的整数加法为例,生成的结果在0到510之间.为了能利用深度学习模型模拟整数的加法运算,我们需要将输入的两个加数和输出的结果 ...
- 结构型---桥接模式(Bridge Pattern)
定义 桥接模式即将抽象部分与实现部分脱耦,使它们可以独立变化.桥接模式的目的就是使两者分离,根据面向对象的封装变化的原则,我们可以把实现部分的变化封装到另外一个类中,这样的一个思路也就是桥接模式的实现 ...
- SET XACT_ABORT ON [SQL SERVER] 设置事务全部回滚
SET XACT_ABORT ON 设置事务回滚的默认是OFF. 当为ON时,如果你存储中的某个地方出了问题,整个事务中的语句都会回滚为OFF时,只回滚错误的地方
- ubuntu 16.04服务器 搭建php LAMP环境
1.安装Apache 下载目录: sudo apt update 安装程序: sudo apt install apache2 检查是否安装成功: sudo systemctl status apac ...
- python - unittest 单元测试学习
单元测试 单元测试是用来对一个模块.一个函数或者一个类进行正确性检验的测试工作 比如对Python中的abs 的测试 输入正数: 比如 1, 2, 3, 返回值不变 输入负数: 比如 -1, -2, ...
- 【Tomcat】Tomcat工作原理
Tomcat 总体结构 Tomcat 的结构很复杂,但是 Tomcat 也非常的模块化,找到了 Tomcat 最核心的模块,您就抓住了 Tomcat 的“七寸”.下面是 Tomcat 的总体结构图: ...