
记我的第一个python爬虫
捣鼓了两天,终于完成了一个小小的爬虫代码。现在才发现,曾经以为那么厉害的爬虫,在自己手里实现的时候,也不过如此。但是心里还是很高兴的。
其实一开始我是看的慕课上面的爬虫教学视屏,对着视屏的代码一行行的敲,两天的学习之后,终于看完了,代码也敲完了。视频中老师说,让我们来运行一下 看看效果,然后就看到爬取的结果一点点的出来了。我也对着自己的程序运行了一下,一堆看不懂的错误,上网查了之后一点点都改掉了。终于没有错误了。一运行,what???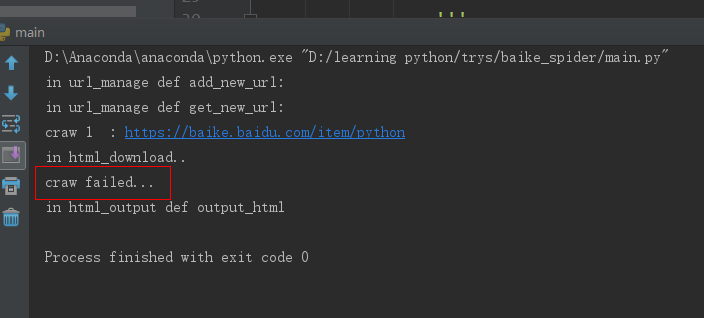
合着就爬取了一个?还是我给的根网址。这种情况最让人难受,语法错误有没有,也能运行,就是不安你说的做。不听话。
我发现他只执行到 download()函数就停止了,于是进入这个函数查看,是不是有错误,先看一下主函数,部分程序如下:
 html_cont = self.downloader.download(new_url)  #下载这个页面

                new_urls,new_data = self.parser.parse(new_url,html_cont)  #解析得到新的url和数据

                self.urls.add_new_urls(new_urls)

                self.output.collect_data(new_data)

                if count == 100:   #只允许爬取1000个链接网页

                    break;

                count = count+1

            except:

                print "craw failed..."

        self.output.output_html()   #输出爬取信息
在download()函数里面是这个:
import urllib2

class HTML_download(object):

    def download(self, url):

        print 'in html_download..'

        if url is None:

            return None

        response = urllib2.urlopen(url)

        if response.getcode(url) != 200:  #说明访问失败,一般返回200说明访问成功

            return None

        else:

            return response.read()
他打印完 print 函数就停止了,跳到了异常处理里面,所以我认为是这个里面的问题。但是代码又都是按照视屏中敲的,能有什么问题呢?
好吧,既然问题找不到,那咱们就咱把这部分单独拿出来实现一下,看看行不行,于是有了下面的代码:
#!Anaconda/anaconda/python

#coding: utf-8

from bs4 import BeautifulSoup

import re

import urllib2

import urlparse

URL = "https://baike.baidu.com/item/Python/407313?fr=aladdin"

count = 1  #计算共有多少爬取结果

response = urllib2.urlopen(URL)  #打开一个网页

soup = BeautifulSoup(response,'html.parser',from_encoding='utf-8') #创建 beautifulsoup 对象

#<a target="_blank" href="/item/%E6%BA%90%E4%BB%A3%E7%A0%81/3969" data-lemmaid="3969">源代码</a>

print "get all the URL...."

links = soup.find_all('a',href=re.compile(r"/item/"))

for link in links:

    count+= 1

    new_url = link['href']

    new_full_url = urlparse.urljoin(URL, new_url)  #与完整网页链接结合,构成完整网页,不然输出的是不完整的网页链接

    print link.name,new_full_url,link.get_text()

print '共 %d 个爬取结果'%(count)
虽然很短,但是能爬取相关网页。
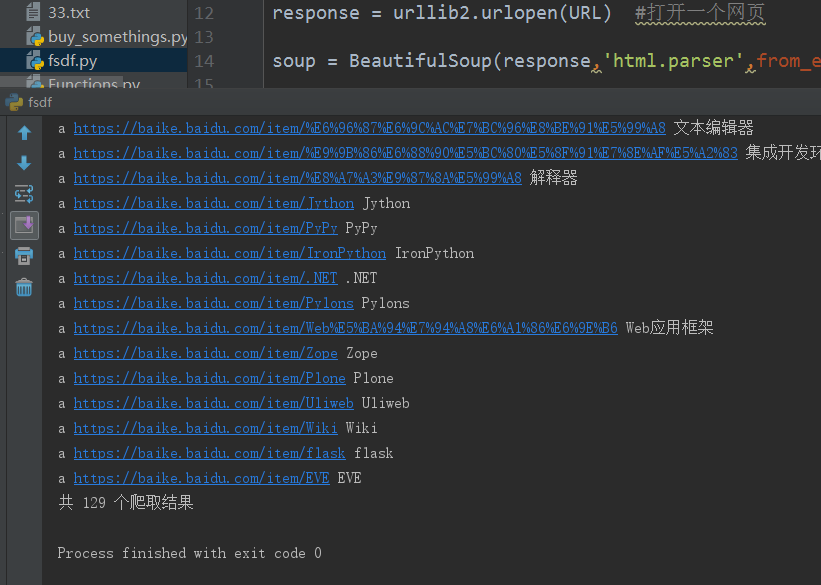
看来还是能爬取的,说明download()函数没有问题 ,那么问题就只能出现在下面几个函数里面了,还有可能就是可能是函数间的参数传递不对。导致程序异常停止。
后来发现,原来问题出在这里:
if response.getcode() != :
在getcode()函数里面并不需要参数,上面一个程序里面传入了参数url
自此,我的原爬虫程序就能执行了,虽然途中也遇到 了一些其他的问题,但是也都一一解决了。
记我的第一个python爬虫的更多相关文章
- 一个python爬虫小程序
起因 深夜忽然想下载一点电子书来扩充一下kindle,就想起来python学得太浅,什么“装饰器”啊.“多线程”啊都没有学到. 想到廖雪峰大神的python教程很经典.很著名.就想找找有木有pdf版的 ...
- 一个Python爬虫工程师学习养成记
大数据的时代,网络爬虫已经成为了获取数据的一个重要手段. 但要学习好爬虫并没有那么简单.首先知识点和方向实在是太多了,它关系到了计算机网络.编程基础.前端开发.后端开发.App 开发与逆向.网络安全. ...
- 我的第一个Python爬虫——谈心得
2019年3月27日,继开学到现在以来,开了软件工程和信息系统设计,想来想去也没什么好的题目,干脆就想弄一个实用点的,于是产生了做“学生服务系统”想法.相信各大高校应该都有本校APP或超级课程表之类的 ...
- 我的第一个 python 爬虫脚本
#!/usr/bin/env python# coding=utf-8import urllib2from bs4 import BeautifulSoup #res = urllib.urlopen ...
- 写一个python 爬虫爬取百度电影并存入mysql中
目标是利用python爬取百度搜索的电影 在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接 首先我们先在mysql中建表 create table liubo4( id in ...
- 第一个python爬虫程序
1.安装Python环境 官网https://www.python.org/下载与操作系统匹配的安装程序,安装并配置环境变量 2.IntelliJ Idea安装Python插件 我用的idea,在工具 ...
- 我的第一个python爬虫
我的第一个爬虫,哈哈,纯面向过程 实现目标: 1.抓取本地conf文件,其中的URL地址,然后抓取视频名称以及对应的下载URL 2.抓取URL会单独写在本地路径下,以便复制粘贴下载 废话补多少,代码实 ...
- 一个python爬虫工具类
写了一个爬虫工具类. # -*- coding: utf-8 -*- # @Time : 2018/8/7 16:29 # @Author : cxa # @File : utils.py # @So ...
- 我的第一个python爬虫程序
程序用来爬取糗事百科上的图片的,程序设有超时功能,具有异常处理能力 下面直接上源码: #-*-coding:utf-8-*- ''' Created on 2016年10月20日 @author: a ...
随机推荐
- 源码分析四(HashMap与HashTable的区别 )
这一节看一下HashMap与HashTable这两个类的区别,工作一段时间的程序员都知道, hashmap是非线程安全的,而且key值和value值允许为null,而hashtable是非线程安全的, ...
- phpcms v9 get的强大之处(列表页调用点击数)
{pc:get sql="select * from v9_art as g left join v9_art_data as p on p.id=g.id and g.catid=12 o ...
- apache+tomcat集群部署笔记
前提条件 安装gcc,gcc-c++两个编译器 yum install gcc yum install gcc-c++ 接下来开始安装集群相关环境: 1.下载apr,apr-util,pcre,apa ...
- ASP.NET 动态创建文本框 TextBox (add TextBox to page dynamically)
下面的函数每执行一次就生成一个TextBox(其实是<input type="Text">) var i=0; function changeIt() ...
- ASP.NET Web API 使用Swagger使用笔记
https://www.cnblogs.com/lhbshg/p/8711604.html 最近换了工作,其中Webapi这块没有文档,之前有了解过Swagger借此机会好好整理下常用的地方分享给有需 ...
- linux系统如何操作隐藏文件
在linux下,以点"."开头命名的文件在系统中被视为隐藏文件.因此,如果想隐藏某个文件或目录,一种简单的办法就是把文件名命名为点开头. 对于目录backcron,可以这样操作隐藏 ...
- js当中null和{}区别
{}是一个不完全空的对象,因为他的原型链上还有Object呢,而null就是完全空的对象,啥也没有,原型链也没有,所以null instanceof Object === false;[]就更不用说了 ...
- 《MySQL》一次MySQL慢查询导致的故障
本文转载自 http://www.jb51.net/article/70955.htm 我们知道分析MySQL语句查询性能的方法除了使用EXPLAIN 输出执行计划,还可以让MySQL记录下查询超过指 ...
- rabbitmq queue_declare arguments参数注释
版权声明:本文为博主原创文章,未经博主允许不得转载. https://blog.csdn.net/qq_26656329/article/details/77891793说明官方文档 在创建queue ...
- 计算完成率 SQL
计算完成率 SQL ,), ,) ) AS XX_完成率