
写一个python 爬虫爬取百度电影并存入mysql中
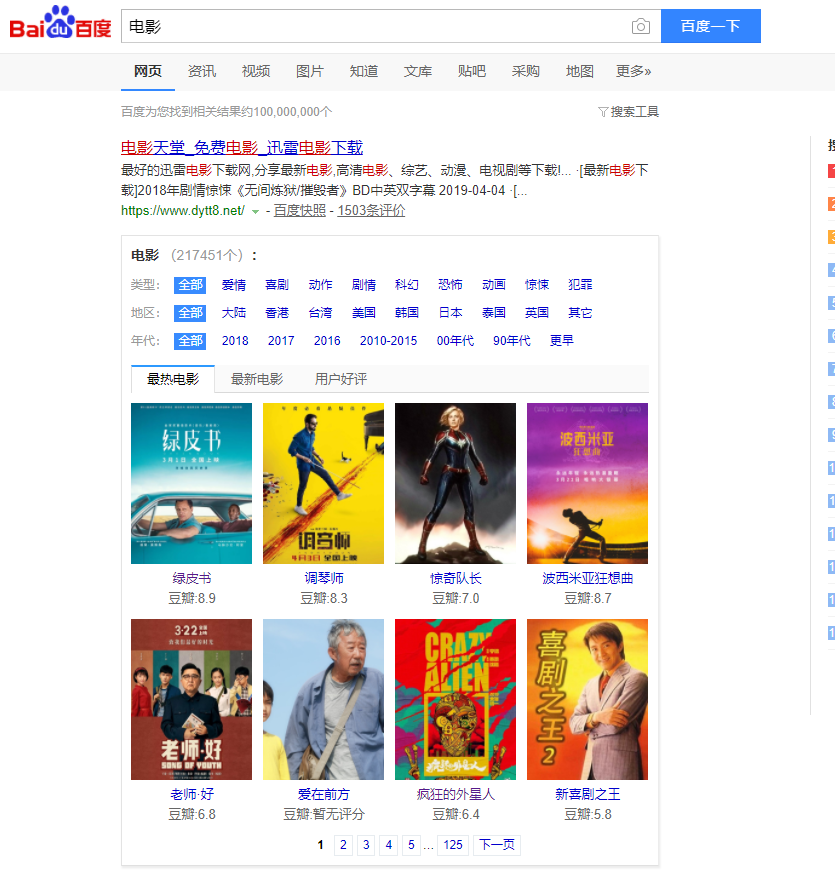
目标是利用python爬取百度搜索的电影
在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接
首先我们先在mysql中建表
create table liubo4(

id int not null auto_increment,

score  VARCHAR(50) DEFAULT 0,

name   VARCHAR(50) DEFAULT 0,

Pic    VARCHAR(200) DEFAULT 0,

dianyingurl VARCHAR(200) DEFAULT 0,

leixing  VARCHAR(50) DEFAULT 0,

niandai  VARCHAR(50) DEFAULT 0,

diqu     VARCHAR(50) DEFAULT 0,

PRIMARY KEY (id))
其中 图片地址列和电影地址列的 字段名要设置长一点 否则插入时不够,最好为每一列设置默认值。
我们在切换页数时会发现,浏览器地址栏中是没有变化的,这就使得无法直接用地址栏的url变化和xpath来获取标签进行爬取。
那么我们就用另外一种-----解析json字符串。
首先打开f12
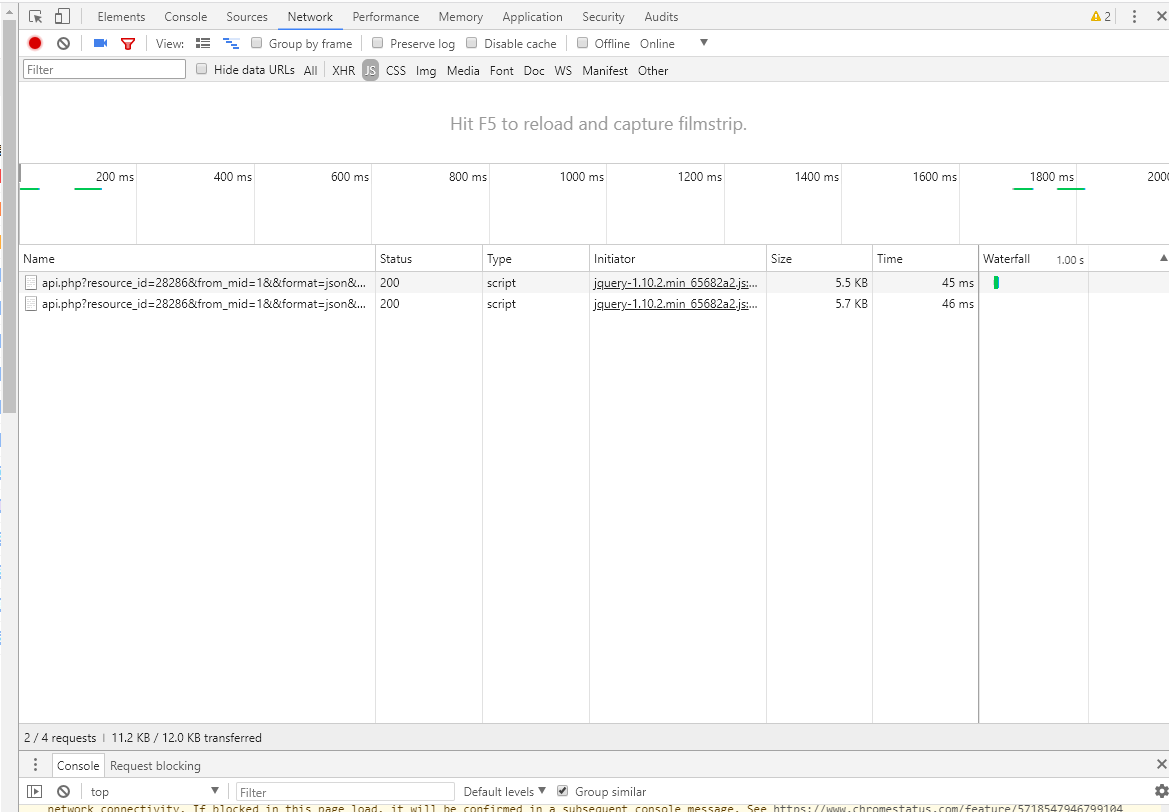


我们在切换页数时,会出现两个记录。
点开1.2两个行的行踪记录,能看到他们的Request URL
仔细看会发现这两个request的url主要不同在在于:第二页比第一页的pn多了8,那么我们就可以根据这个规律,在python中利用for 循环来请求125页的爬取。
找到了页面的规律,我们再去寻找具体的标签。
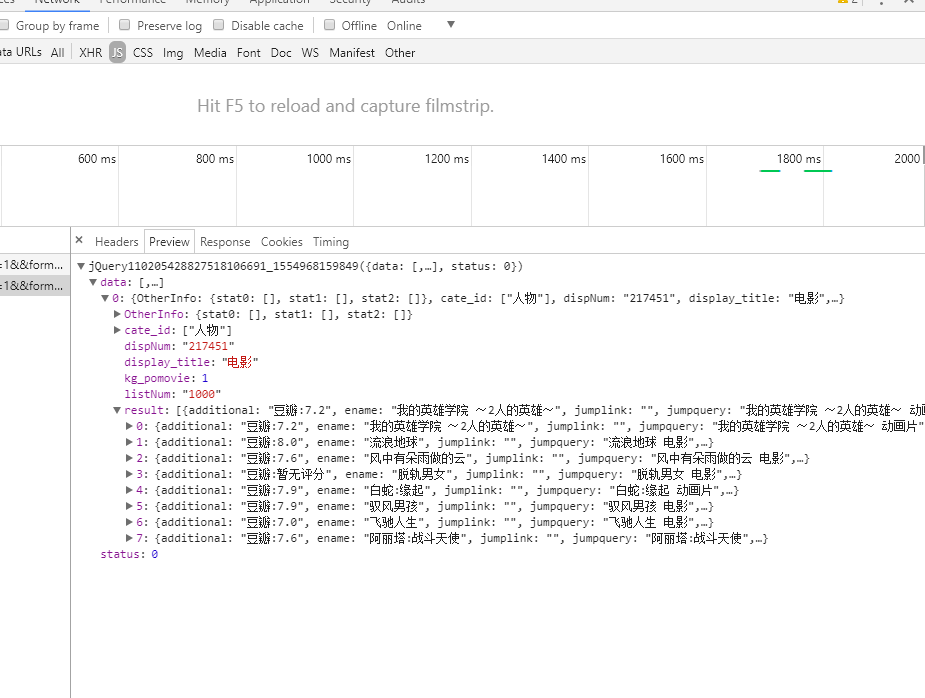
我们可以看到我们需要的 评分 名字 都被分别存放在 1.[data]-[result]-[additional] 2.[data]-[result]-[ename] 之中 。 而且每一页八部电影,分别被存在在result中的排序0-7。
那么图片url和电影url在哪呢 我们直接打开request url
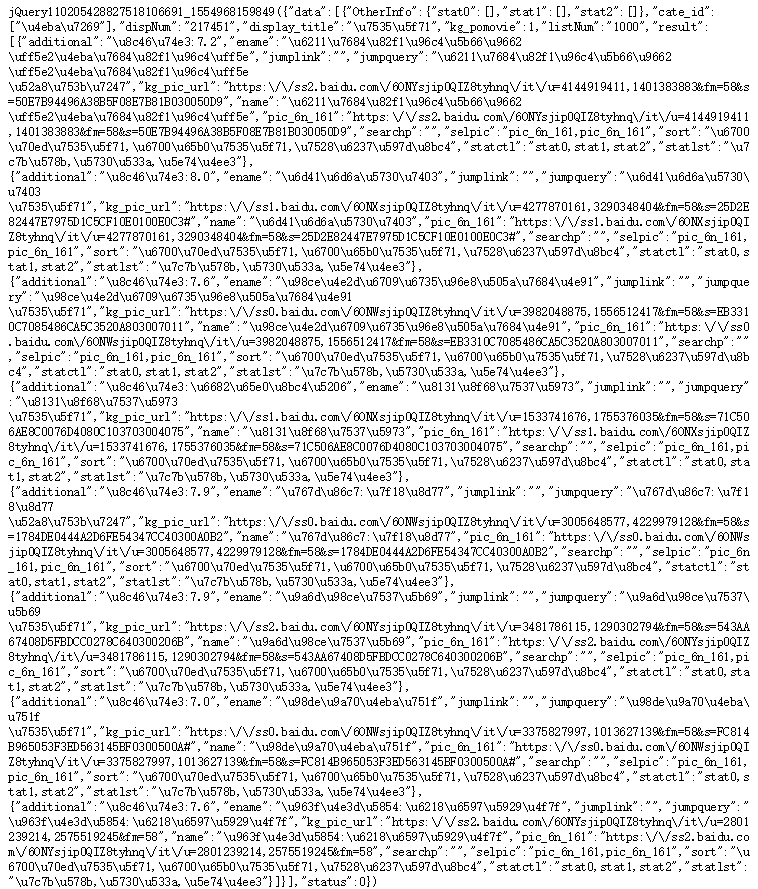
在json字符串中 我们可以找到 picurl 而电影名字点开一部电影可以发现前部分的域名都是一样的 再加上不同的电影名字。
代码
import requests

import json

import re

import os

import pickle

import pymysql

db = pymysql.connect('localhost', 'root', '', 'languid')连接mysql

urlbase = "https://sp0.baidu.com/8aQDcjqpAAV3otqbppnN2DJv/api.php?resource_id=28286&from_mid=1&&format=json&ie=utf-8&oe=utf-8&query=%E7%94%B5%E5%BD%B1&sort_key=16&sort_type=1&stat0=&stat1=&stat2=&stat3=&pn="

urllist =[]

for i in range(1,125):

        url = urlbase+str(8*i)

        urllist.append(url)

listxixi=[]

for uri in urllist:

        headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36)"}

        response = requests.get(uri,headers=headers).text

        json_str = json.loads(response) 解析json字符串

        aa=json_str['data'][0]['result'][0]['additional']

        bb=json_str['data'][0]['result'][0]['ename']

        cc=json_str['data'][0]['result'][0]['kg_pic_url']

        dd='https://www.baidu.com/s?rsv_idx=1&tn=44004473_1_oem_dg&wd='+json_str['data'][0]['result'][0]['ename']

        listxixi.append([aa, bb, cc, dd])

cursor =db.cursor()

sql = "insert into liubo4(name,score,Pic,dianyingurl) Values(%s,%s,%s,%s)"#这里使用格式化字符串,用占位符

cursor.executemany(sql ,listxixi)

db.commit()

db.close()
这里使用insert语句中的 executemany 批量插入到mysql中 。首先要创建一个list 然后再插入mysql。
然后用第二种遍历commit 逐条提交
import requests

import json

import re

import os

import pickle

import pymysql

db = pymysql.connect('localhost', 'root', '', 'languid')

urlbase = "https://sp0.baidu.com/8aQDcjqpAAV3otqbppnN2DJv/api.php?resource_id=28286&from_mid=1&&format=json&ie=utf-8&oe=utf-8&query=%E7%94%B5%E5%BD%B1&sort_key=16&sort_type=1&stat0=&stat1=&stat2=&stat3=&pn="

urllist =[]

for i in range(1,124):

        url = urlbase+str(8*i)

        urllist.append(url)

for uri in urllist:

        headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36)"}

        response = requests.get(uri,headers=headers).text

        json_str = json.loads(response)

        aa=json_str['data'][0]['result'][0]['additional']

        bb=json_str['data'][0]['result'][0]['ename']

        cc=json_str['data'][0]['result'][0]['kg_pic_url']

        dd='https://www.baidu.com/s?rsv_idx=1&tn=44004473_1_oem_dg&wd='+json_str['data'][0]['result'][0]['ename']

        cursor = db.cursor()

        sql = "insert into liubo3(score,name,Pic,dianyingurl,leixing,niandai,diqu) VALUES ('%s','%s','%s','%s','犯罪','大陆','2016')" %(aa,bb,cc,dd)

        cursor.execute(sql)

        db.commit()
这里的标签中的类型、地区、年代是直接写死的 ,暂且没有找到好的办法去寻找规律。
附上一个用beautifulsoup简单爬取标签的代码
import requests

from bs4 import BeautifulSoup

import pymysql

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36)"}

url='https://www.baidu.com/s?ie=utf-8&f=8&rsv_bp=1&rsv_idx=1&tn=44004473_1_oem_dg&wd=%E7%94%B5%E5%BD%B1&rsv_pq=c30325e3000821d1&rsv_t=a23ejDCMhrNpbUK9fSZYvGt62pChqFxtcBIduHebPB%2BFDC%2BPosF8jTkgd1ZiL4KWiuTzBg5rtwY&rqlang=cn&rsv_enter=1&rsv_sug3=5&rsv_sug1=4&rsv_sug7=100'

req = requests.get(url, headers=headers)

soup = BeautifulSoup(req.text,'lxml')

#xml = soup.find_all('p',class_='op_exactqa_tag_stat0')

#ddd = soup.find_all ('p',class_='op_exactqa_tag_stat1')

ccc = soup.find_all('p',class_='op_exactqa_tag_stat2')

leixin =[]

for name in ccc:

    niandai=name.get_text()

    db = pymysql.connect('localhost', 'root', '', 'languid')

    cursor = db.cursor()

    sql = "insert into liubo2(niandai)VALUES ('%s')"%(niandai)

    cursor.execute(sql)

    db.commit()
但是爬取到表中是整个list传入到表格,还没有学习透彻。
在整个爬虫制作过程中,学习网上爬取豆瓣电影的xpath办法失败了。
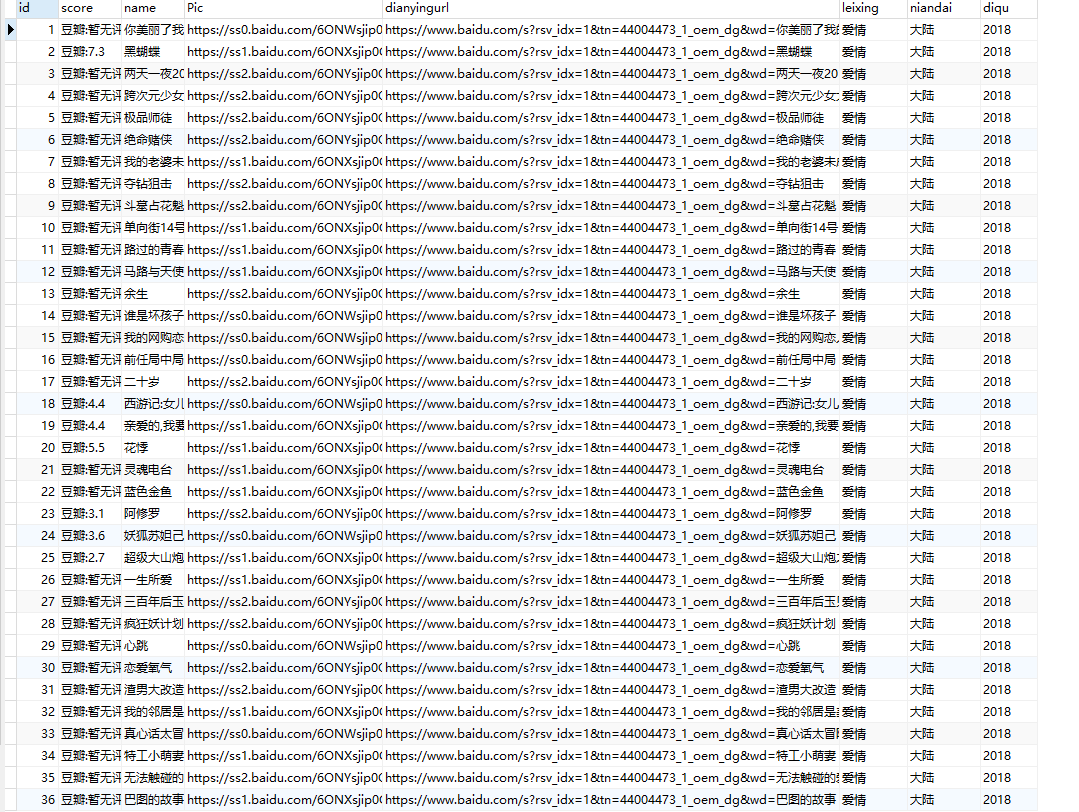
存入到mysql中的构架。
将爬取到的数据写入txt或者csv中
with open('wozuishuai5.txt', 'a+') as f:

                                         f.write('\n'+aa+'\n'+bb+'\n'+cc+'\n'+dd)
写一个python 爬虫爬取百度电影并存入mysql中的更多相关文章
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- python 爬虫&爬取豆瓣电影top250
爬取豆瓣电影top250from urllib.request import * #导入所有的request,urllib相当于一个文件夹,用到它里面的方法requestfrom lxml impor ...
- Python爬虫爬取豆瓣电影之数据提取值xpath和lxml模块
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统.谷歌浏览器 目的:爬取豆瓣电影排行榜中电影的title.链接地址.图片.评价人数.评分等 网址:https:// ...
- python爬虫—爬取百度百科数据
爬虫框架:开发平台 centos6.7 根据慕课网爬虫教程编写代码 片区百度百科url,标题,内容 分为4个模块:html_downloader.py 下载器 html_outputer.py 爬取数 ...
- Python爬虫爬取百度贴吧的帖子
同样是参考网上教程,编写爬取贴吧帖子的内容,同时把爬取的帖子保存到本地文档: #!/usr/bin/python#_*_coding:utf-8_*_import urllibimport urlli ...
- Python爬虫爬取百度贴吧的图片
根据输入的贴吧地址,爬取想要该贴吧的图片,保存到本地文件夹,仅供参考: #!/usr/bin/python#_*_coding:utf-8_*_import urllibimport urllib2i ...
- python爬虫-爬取豆瓣电影数据
#!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:27# 文件 :spider_05.py# IDE :PyChar ...
- Python爬虫爬取百度翻译之数据提取方法json
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统 说明:本例为实现输入中文翻译为英文的小程序,适合Python爬虫的初学者一起学习,感兴趣的可以做英文翻译为中文的 ...
随机推荐
- Vue 实现左边导航栏且右边显示具体内容(element-ui)
最终效果图: 现在开始进入正题: 1.安装element-ui npm i element-ui -S CDN 目前可以通过 unpkg.com/element-ui 获取到最新版本的资源,在页面上引 ...
- golang类型断言
一.介绍 类型断言,由于接口是一般类型,不知道具体类型,如果要转成具体类型,就需要使用类型断言 例子: package main import "fmt" func main(){ ...
- git常用命令二、:git stash
Git stash 储藏工作现场(当你不得不新建分支,或者切换分支,但是当前工作区的修改并不想提交) git stash Saved working directory and index state ...
- IntelliJ IDEA2017 激活方法 最新的激活注册方式方法,破解,密钥
IntelliJ IDEA2017 激活方法(亲测可用): 搭建自己的授权服务器,对大佬来说也很简单,我作为菜鸟就不说了,网上有教程. 我主要说第二种,现在,直接写入注册码,是不能成功激活的(如果你成 ...
- 微信退款验证证书时报错:length too long
由于springboot文件加载时,默认会加载resources目录下的文件,而微信的证书刚好在它之下,加载时就会报这个错误.解决办法: 在pom.xml文件中,添加如下代码: <plugin& ...
- 【一本通1329:【例8.2】细胞&&洛谷P1451 求细胞数量】
1329:[例8.2]细胞 [题目描述] 一矩形阵列由数字0到9组成,数字1到9代表细胞,细胞的定义为沿细胞数字上下左右还是细胞数字则为同一细胞,求给定矩形阵列的细胞个数.如: 阵列 4 10 023 ...
- python第十三天,函数的嵌套定义,global,nonlocal关键字的使用,闭包及闭包的运算场景,装饰器
今日内容 1. 函数的嵌套定义 2.global,nonlocal关键字 3.闭包及闭包的运用场景 4.装饰器 函数的嵌套定义 1. 概念:在一个函数内部定义另一个函数 2 .为什么要有函数的嵌套定义 ...
- numba学习教程
一.对于python的基础介绍 Python是一种高效的动态编程语言,广泛用于科学,工程和数据分析应用程序..影响python普及的因素有很多,包括干净,富有表现力的语法和标准数据结构,全面的“电池包 ...
- CMakeList.txt(1):cmake error
cmake_symlink_library: System Error: Operation not supported 1/创建链接不成功,要确认当前帐户下是否有权限在编译的目录中有创建链接的权限 ...
- SQL随记(六)
1.关于dbms_sql包的一些执行语句 cursor_name := DBMS_SQL.OPEN_CURSOR; --打开游标: DBMS_SQL.PARSE(cursor_name, var_dd ...