
Intellij IDEA连接Spark集群
1. 首先安装Scala插件,File->Settings->Plugins,搜索出Scla插件,点击Install安装;
2. File->New Project->maven,新建一个Maven项目,填写GroupId和ArtifactId;
3. 编辑pom.xml文件,添加项目所需要的依赖:
    <properties>

        <scala.version>2.10.5</scala.version>

        <hadoop.version>2.6.5</hadoop.version>

    </properties>

    <repositories>

        <repository>

            <id>scala-tools.org</id>

            <name>Scala-Tools Maven2 Repository</name>

            <url>http://scala-tools.org/repo-releases</url>

        </repository>

    </repositories>

    <dependencies>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-core_2.10</artifactId>

            <version>1.6.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-sql_2.10</artifactId>

            <version>1.6.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-streaming_2.10</artifactId>

            <version>1.6.0</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-client</artifactId>

            <version>${hadoop.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-common</artifactId>

            <version>${hadoop.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-hdfs</artifactId>

            <version>${hadoop.version}</version>

        </dependency>

    </dependencies>
4. File->Project Structure->Libraries,选择和Spark运行环境一致的Scala版本:
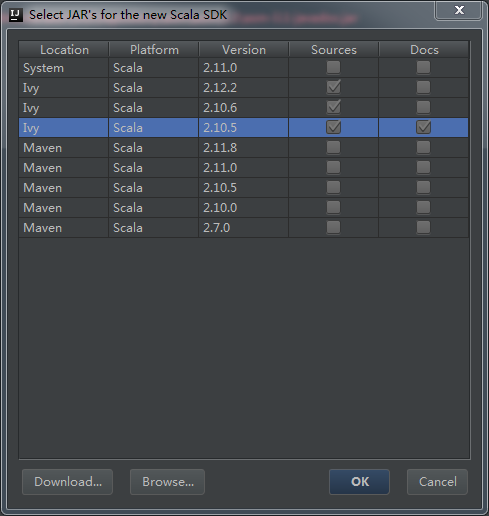
5. File->Project Structure->Modules,在src/main/下面增加一个scala文件夹,并且设置成source文件夹;
6. 在scala文件夹下面新建一个scala文件SparkPi:
import scala.math.random
import org.apache.spark._

object SparkPi {
  def main(args: Array[String]) {
    val conf = new SparkConf().setAppName("Spark Pi").setMaster("spark://master:7077").setJars(Seq("E:\\Intellij\\Projects\\SparkExample\\SparkExample.jar"))
    val spark = new SparkContext(conf)
    val slices = if (args.length > 0) args(0).toInt else 2
    println("Time:" + spark.startTime)
    val n = math.min(1000L * slices, Int.MaxValue).toInt // avoid overflow
    val count = spark.parallelize(1 until n, slices).map { i =>
      val x = random * 2 - 1
      val y = random * 2 - 1
      if (x*x + y*y < 1) 1 else 0
    }.reduce(_ + _)
    println("Pi is roughly " + 4.0 * count / n)
    spark.stop()
  }
}
7. File->Project Structure->Artifacts,新建一个Jar->From modules with dependencies...,选择Main Class:

设置Output directory,删掉不必要的jar:

7. Build->Build Artifacts...,生成jar,然后再运行,成功!

Intellij IDEA连接Spark集群的更多相关文章
- Spark系列—01 Spark集群的安装
一.概述 关于Spark是什么.为什么学习Spark等等,在这就不说了,直接看这个:http://spark.apache.org, 我就直接说一下Spark的一些优势: 1.快 与Hadoop的Ma ...
- IntelliJ IDEA编写的spark程序在远程spark集群上运行
准备工作 需要有三台主机,其中一台主机充当master,另外两台主机分别为slave01,slave02,并且要求三台主机处于同一个局域网下 通过命令:ifconfig 可以查看主机的IP地址,如下图 ...
- windows下通过idea连接hadoop和spark集群
###windows下链接hadoop集群 1.假如在linux机器上已经搭建好hadoop集群 2.在windows上把hadoop的压缩包解压到一个没有空格的目录下,比如是D盘根目录 3.配置环境 ...
- Spark集群测试
1. Spark Shell测试 Spark Shell是一个特别适合快速开发Spark原型程序的工具,可以帮助我们熟悉Scala语言.即使你对Scala不熟悉,仍然可以使用这一工具.Spark Sh ...
- Spark集群模式概述
作者:foreyou出处:http://www.foreyou.net/2015/06/22/spark-cluster-mode-overview/声明:本文采用以下协议进行授权: 署名-非商用|C ...
- zhihu spark集群,书籍,论文
spark集群中的节点可以只处理自身独立数据库里的数据,然后汇总吗? 修改 我将spark搭建在两台机器上,其中一台既是master又是slave,另一台是slave,两台机器上均装有独立的mongo ...
- Spark集群术语
Spark集群术语解析 1. Application Application是用户在Spark上构建(编写)的程序,包含driver program 和executors(分布在集群中多个节点上运行的 ...
- Spark集群模式&Spark程序提交
Spark集群模式&Spark程序提交 1. 集群管理器 Spark当前支持三种集群管理方式 Standalone-Spark自带的一种集群管理方式,易于构建集群. Apache Mesos- ...
- spark集群搭建整理之解决亿级人群标签问题
最近在做一个人群标签的项目,也就是根据客户的一些交易行为自动给客户打标签,而这些标签更有利于我们做商品推荐,目前打上标签的数据已达5亿+, 用户量大概1亿+,项目需求就是根据各种组合条件寻找标签和人群 ...
随机推荐
- 【Android】开源项目汇总-备用
from://http://www.eoeandroid.com/home.php?mod=space&uid=765778&do=blog&id=47674 Android开 ...
- 关于struts2种的action运行两次,或多次,或反复运行的bug
今天在做项目的时候发现一个bug,就是action会莫名其妙的运行两次.网上搜了非常多帖子,关于这个问题也得到了一些处理方法,可是没有我想要的,造成运行两次活多次的问题呢,有非常多种原因,我在这里仅仅 ...
- 解决eclipse中web项目出现Project facet Java version 1.8 is not supported.的问题
项目的jdk和tomcat的jdk版本不同,将eclipse-preference-server-runtime environments点击你要用的tomcat点击edit-jre选择和你项目对应的 ...
- ios成长之每日一遍(day 5)
iOS 屏幕方向那点事儿http://zhenby.com/blog/2013/08/20/talk-ios-orientation/ 针对当前的屏幕方向进行对应的代码布局 BIDViewContro ...
- 《Linux系统编程(第2版)》
<Linux系统编程(第2版)> 基本信息 作者: (美)Robert Love 译者: 祝洪凯 李妹芳 付途 出版社:人民邮电出版社 ISBN:9787115346353 上架时间:20 ...
- Log stash学习笔记(一)
Logstash是一款开源的数据收集引擎,具备实时管道处理能力.简单来说,logstash作为数据源与数据存储分析工具之间的桥梁,结合 ElasticSearch以及Kibana,能够极大方便数据的处 ...
- python-opencv旋转图像,保持图像不被裁减
python-opencv旋转图像,保持图像不被裁减 import cv2 from math import * def remote(img,degree): #degree左转 img = c ...
- 配置SSD-caffe测试时出现“Check failed: error == cudaSuccess (10 vs. 0) invalid device ordinal”解决方案
这是由于GPU数量不匹配造成的,如果训练自己的数据,那么我们只需要将solver.prototxt文件中的device_id项改为自己的GPU块数,一块就是0,两块就是1,以此类推. 但是SSD配置时 ...
- 【转】PHP笔试题2010年
From : http://www.51projob.com/a/PHP/20120905/602.html 下午,还有一场比较大的面试等着我[虽然接到pps的录用电话,可是心里还是想去verycd试 ...
- kafka-python的gevent模式和kafka的兼容性
使用gevent会杀死kafka的consumer线程:据查:kafka-python对gevent的支持不是太好,可以使用pykafka:但是可以kafka-python可以结合eventlet使用 ...