
IntelliJ IDEA编写的spark程序在远程spark集群上运行
准备工作
需要有三台主机,其中一台主机充当master,另外两台主机分别为slave01,slave02,并且要求三台主机处于同一个局域网下
通过命令:ifconfig
可以查看主机的IP地址,如下图所示
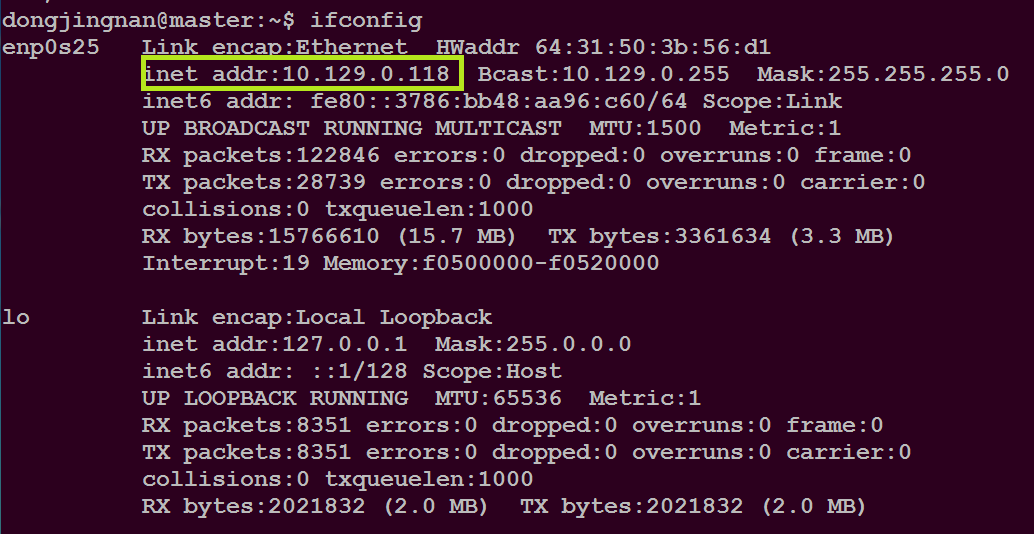
本集群的三台机器的IP地址如下
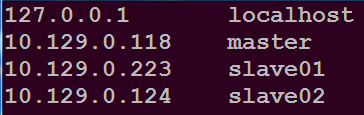
10.129.0.118 master
10.129.0.223 slave01
10.129.0.124 slave02
通过命令:ping IP地址
可以查看与另一台主机的连通性
如下所示
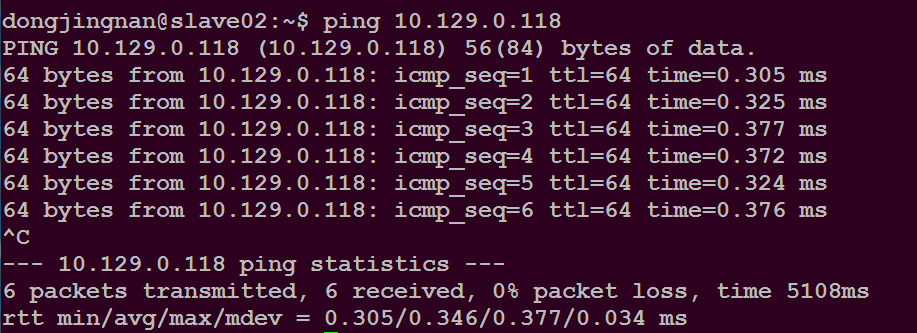
注意:在shell命令下通过CTRL+C 可以结束命令的执行
三台主机的用户名均为dongjingnan
修改三台主机的/etc/hosts

在文件开头添加如下内容
配置ssh无密码登录本机和集群
在master主机上执行如下命令



将master主机上的公钥发给slave01,slave02

在slave01和slave02上都执行如下命令


可以通过命令:ssh 主机名
登录指定主机,如下所示
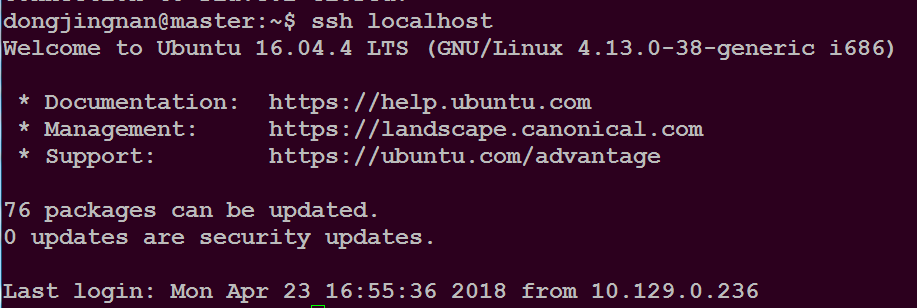
通过命令:exit //退出
JDK和hadoop的配置和安装

如果无法安装可以通过命令:sudo apt-get update //更新软件库
执行命令:sudo vim ~/.bashrc
在~/.bashrc中添加如下内容
export JAVA_HOME=/usr/lib/jvm/default-java
执行命令:source ~/.bashrc
使~/.bashrc文件修改生效
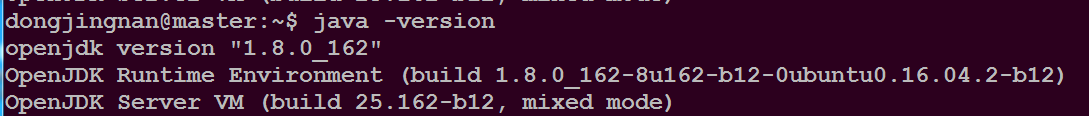
执行命令:java -version
查看jdk版本号,如下图所示
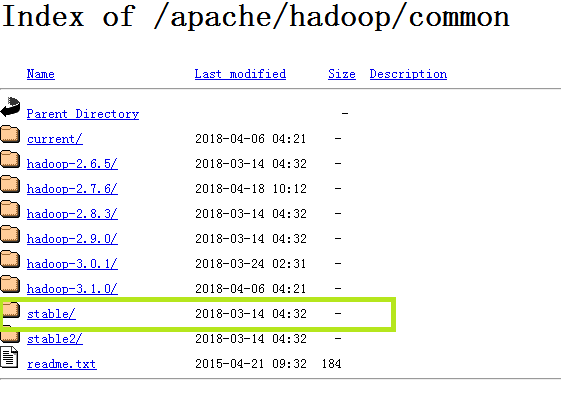
通过网站https://mirrors.cnnic.cn/apache/hadoop/common/
下载hadoop的最新稳定的版本
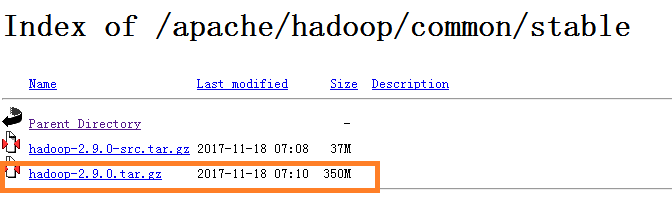
在用户主目录下执行命令$ sudo tar -zxvf ~/Downloads/hadoop-2.9.0.tar.gz -C /usr/local
在用户主目录下执行命令$ cd /usr/local/
在 /usr/local/ 目录下执行命令$ sudo mv ./hadoop-2.9.0 ./hadoop
在 /usr/local/ 目录下执行命令$ sudo chown -R dongjingnan ./hadoop //将dongjingnan替换成你的用户名
编辑 ~/.bahrc 文件,在里面添加如下内容
export HADOOP_HOME=/usr/local/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
保存之后,执行命令: source ~/.bashrc
切换到目录/usr/local/hadoop/etc/hadoop 并查看该目录下的文件
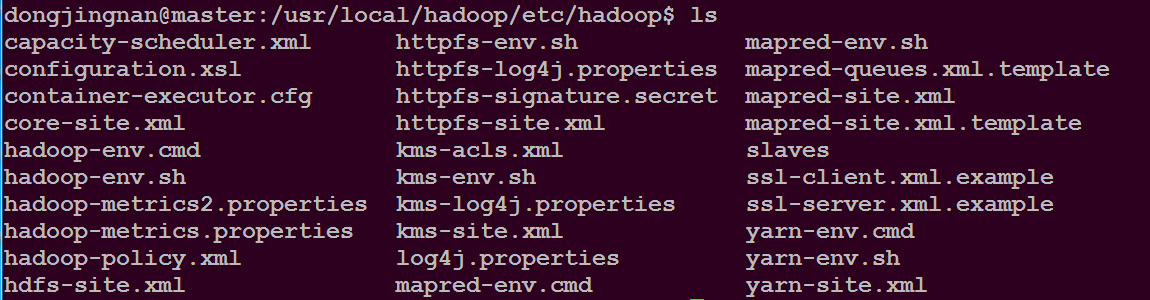
执行命令$ sudo vim slaves
将里面的内容替换成
slave01
slave02
保存后,执行命令$ sudo vim core-site.xml
修改成如下内容
<configuration>
<property>
<name>hadoop.tmp.dir</name>
<value>file:/usr/local/hadoop/tmp</value>
<description>Abase for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS</name>
<value>hdfs://master:9000</value>
</property>
</configuration>
保存后,执行命令$ sudo vim hdfs-site.xml
<configuration>
<property>
<name>dfs.replication</name>
<value>3</value>
</property>
</configuration>
保存后,执行命令$ sudo cp mapred-site.xml.template mapred-site.xml
执行命令$ sudo vim mapred-site.xml
添加如下内容
<configuration>
<porperty>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
</configuration>
保存后,执行命令$ sudo vim yarn-site.xml
<configuration>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<name>yarn.resourcemanage.hostname</name>
<value>master</value>
</property>
<property>
<name>yarn.nodemanager.resource.memory-mb</name>
<value>2048</value>
</property>
</configuration>
保存后,将master上的/usr/local/hadoop目录复制到各个节点上
在用户的主目录执行命令$ sudo tar -zcf ~/hadoop.master.tar.gz /usr/local/hadoop
在用户的主目录执行命令$ scp ~/hadoop.master.tar.gz slave01:/home/dongjingnan
在用户的主目录执行命令$ scp ~/hadoop.master.tar.gz slave02:/home/dongjingnan
执行命令$ ssh slave01
在slave01的主目录执行命令$ sudo tar -zxvf ~/hadoop.master.tar.gz /usr/local
在slave01的主目录执行命令$ sudo chown -R dongjingnan /usr/local/hadoop
执行命令$ exit
在master主目录执行命令$ ssh slave02
在slave02的主目录执行命令$ sudo tar -zxvf ~/hadoop.master.tar.gz /usr/local
在slave02的主目录执行命令$ sudo chown -R dongjingnan /usr/local/hadoop
执行命令$ exit
在master主目录执行如下命令$ sudo vim /usr/local/hadoop/etc/hadoop/hdfs-site.xml
添加一个属性
<property>
<name>dfs.namenode.name.dir</name>
<value>file:/usr/local/hadoop/tmp/dfs/name</value>
</property>
保存后,在master主目录下执行如下命令$ sudo vim yarn-site.xml
删除yarn.nodemanager.resource.memory-mb属性
保存后退出
在master主目录下执行命令$ hadoop namenode -format
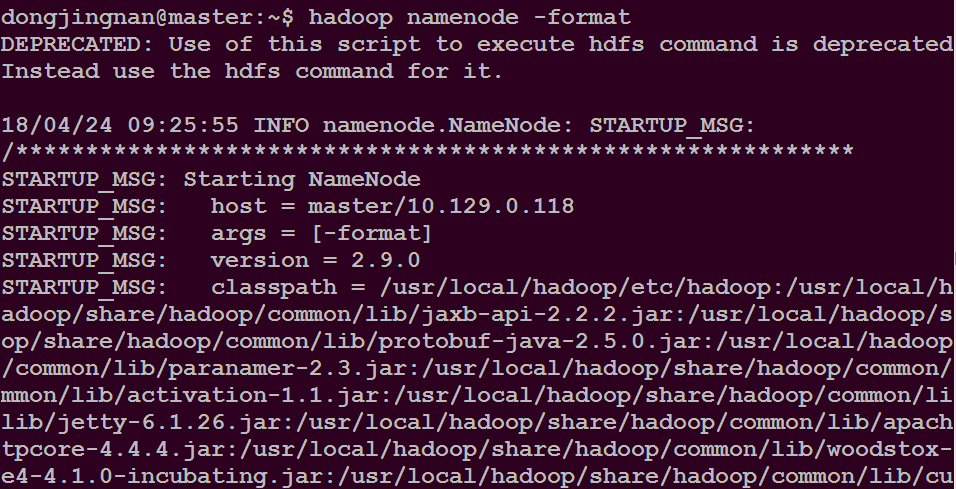
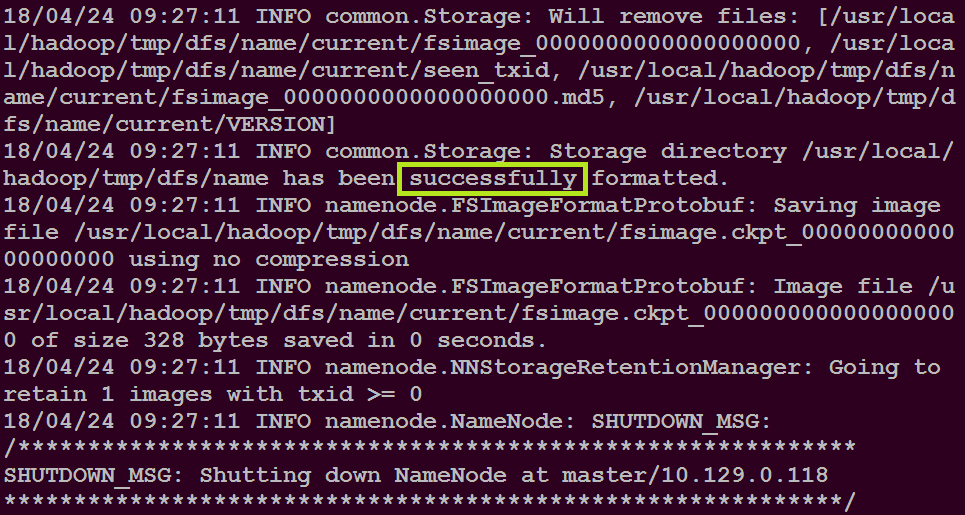
在master主目录下执行命令$ start-all.sh
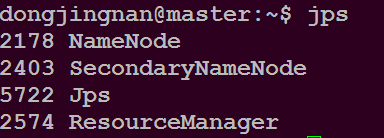
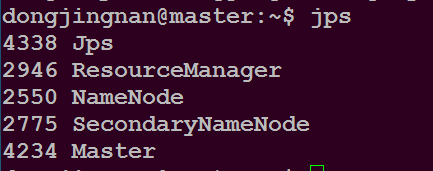
在master主目录下执行命令$ jps
可以看到如下进程
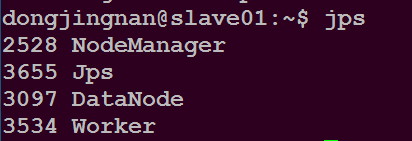
在slave01主目录下执行命令$ jps
可以看到如下进程
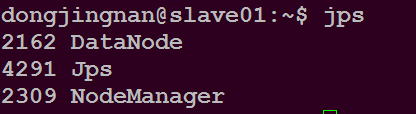
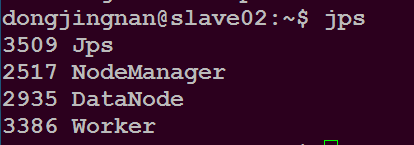
在slave02主目录下执行命令$ jps
可以看到如下进程
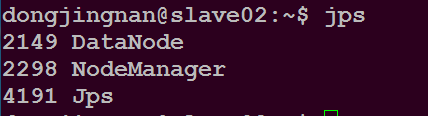
到此,hadoop集群安装完毕
hadoop集群启动时可能出现的问题
问题描述:slave01和slave02都没有出现DataNode进程
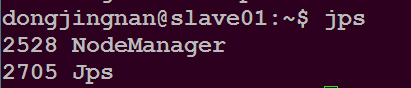
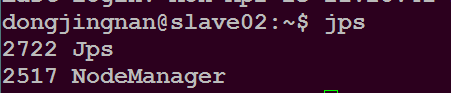
解决办法:每次启动集群前删除slave01和slave02节点上/usr/local/hadoop/tmp/dfs/目录下的data文件夹,然后新建一个data空的文件夹
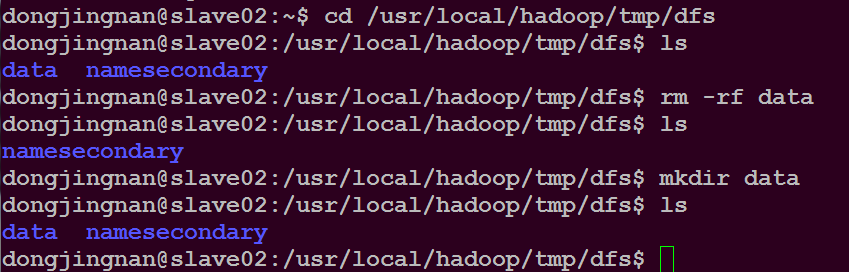
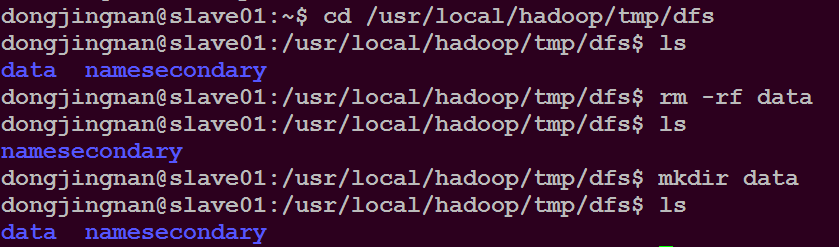
再重新格式化namenode节点,就可以解决了。
在master节点执行命令$ stop-all.sh
可以关闭hadoop集群
接下来进行spark集群的安装
在火狐浏览器输入网址http://spark.apache.org/downloads.html 可以下载spark软件包
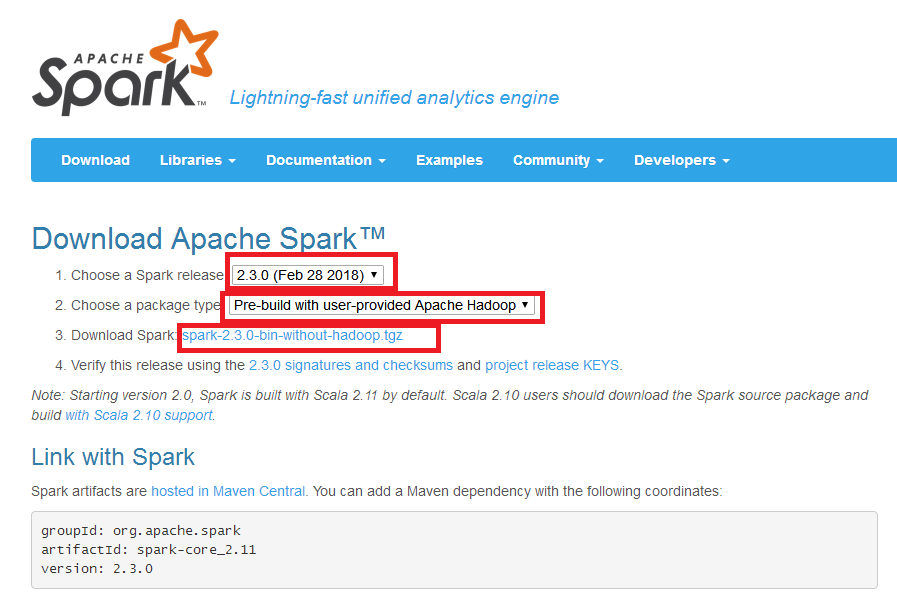
在master主目录下执行命令$ sudo tar -zxvf ~/Downloads/spark-2.3.0-bin-without-hadoop.tgz -C /usr/local
在master主目录下执行命令$ sudo mv /usr/local/spark-2.3.0-bin-without-hadoop /usr/local/spark
在master主目录下执行命令$ sudo chown -R dongjingnan /usr/local/spark
修改~/.bashrc文件
添加如下内容

执行命令$ source ~/.bashrc
执行命令$ cd /usr/local/spark/conf
执行命令$ cp slaves.template slaves
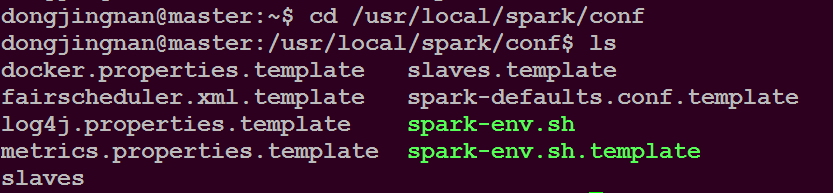
执行命令$ sudo vim slaves
添加如下内容
slave01
slave02
执行命令$ cp spark-env,.sh.template spark-env.sh
执行命令$ sudo vim spark-env.sh

添加如下内容

SPARK_MASTER_IP设置为你自己的master的IP地址
保存后,执行如下命令$
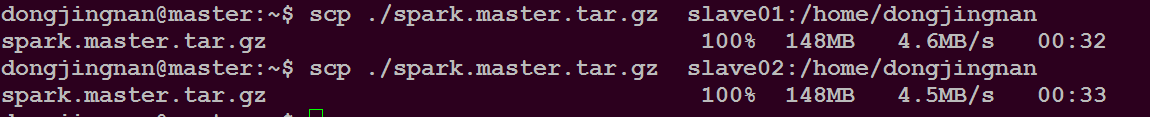
将/usr/local/目录下的spark文件夹打包后发送到slave01和slave02
如下所示

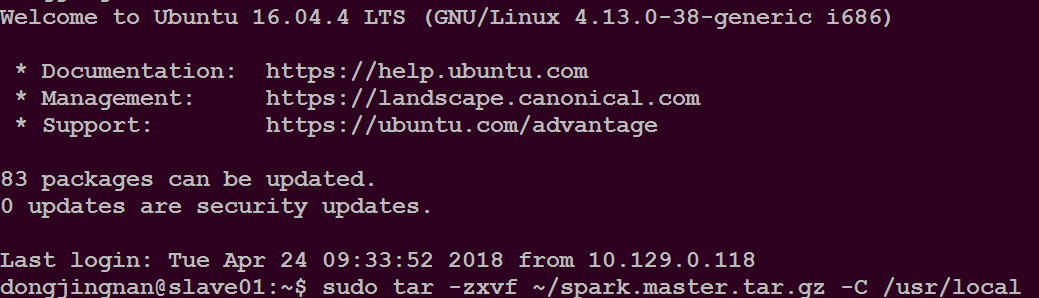
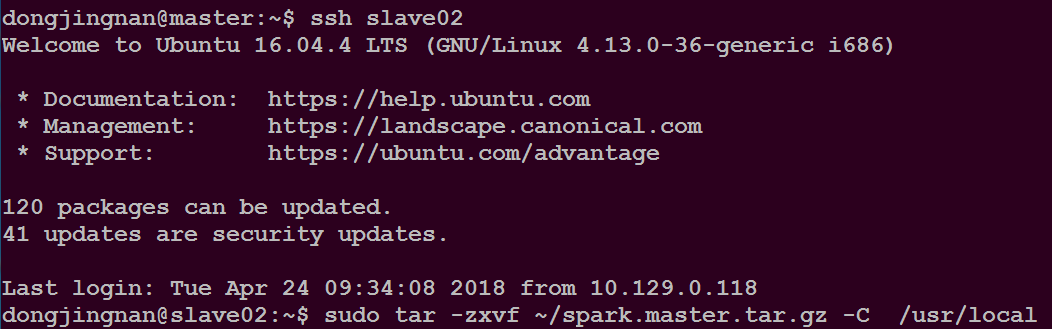
将slave01和slave02节点上的spark.master.tar.gz解压到/usr/local/目录下,并授权给slave01和slave02的用户名


启动hadoop集群
执行命令$ start-all.sh
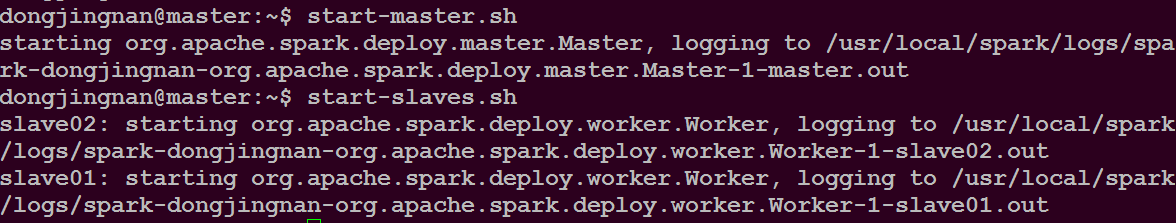
启动spark集群
执行命令$ start-master.sh
执行命令$ start-slaves.sh
如下图所示
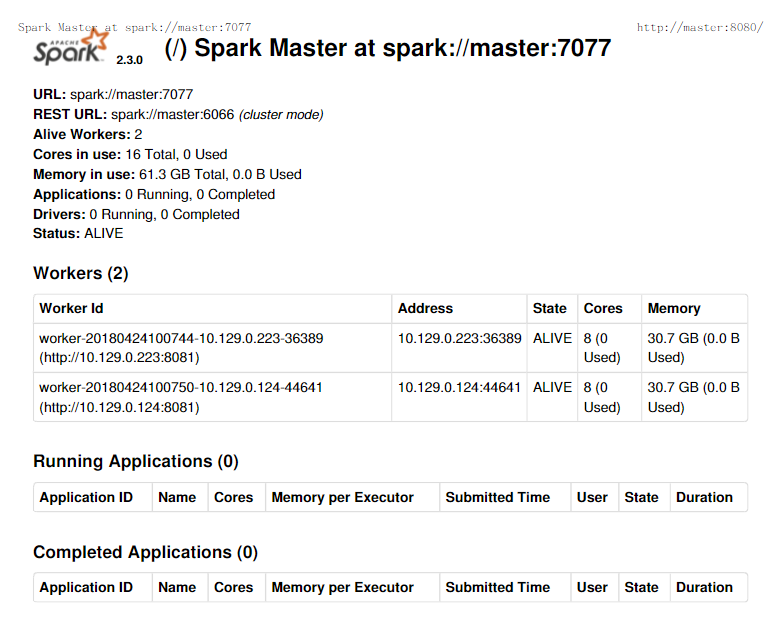
在master主机登录网址http://master:8080 可以看到如下内容
关闭spark集群
执行命令$ stop-slaves.sh
执行命令$ stop-master.sh
在集群中运行应用程序JAR包
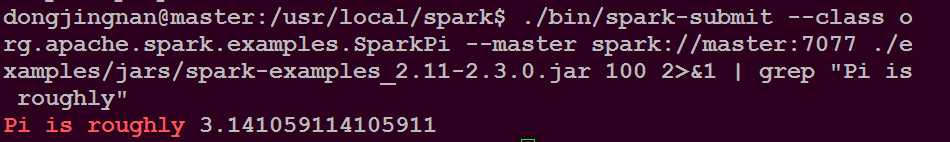
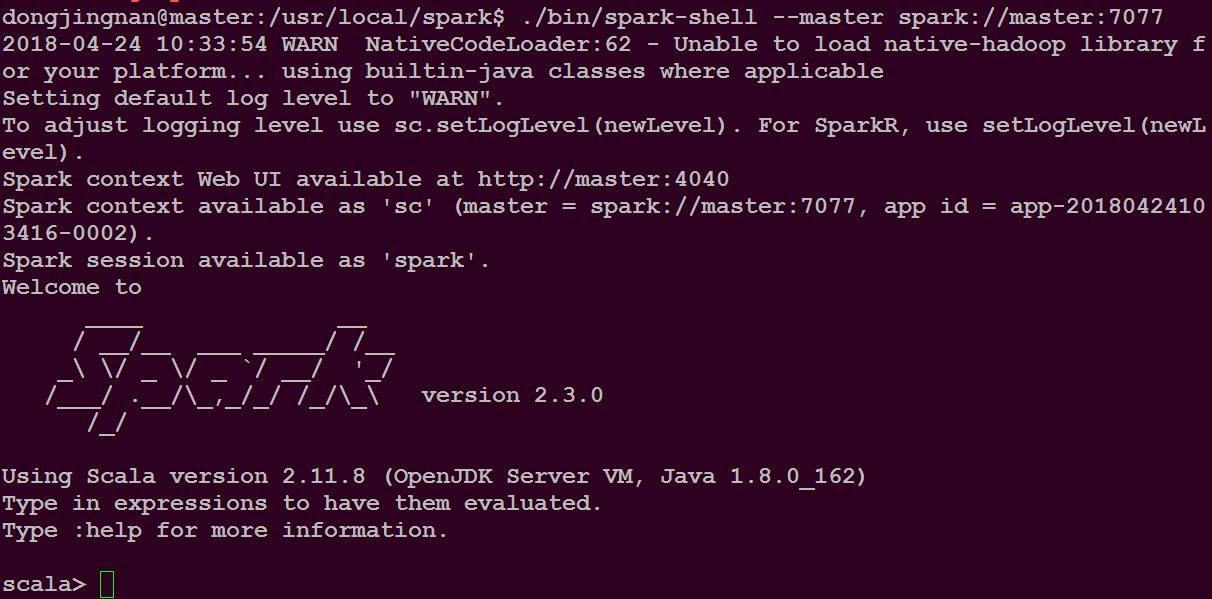
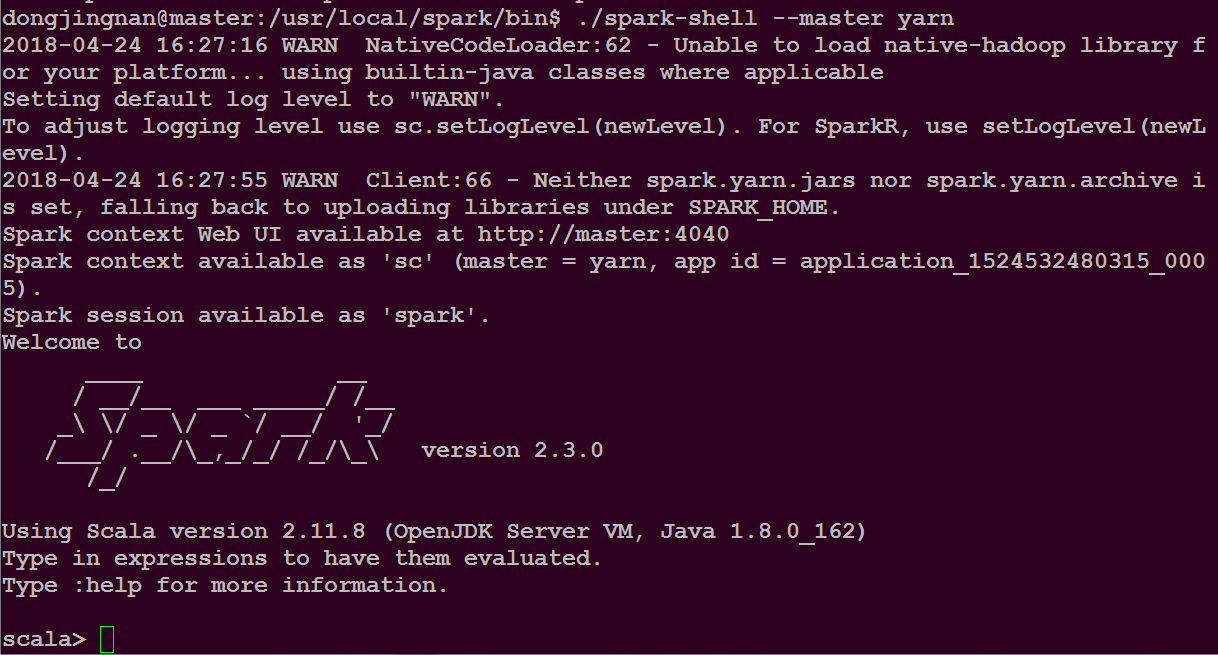
在集群中运行spark-shell
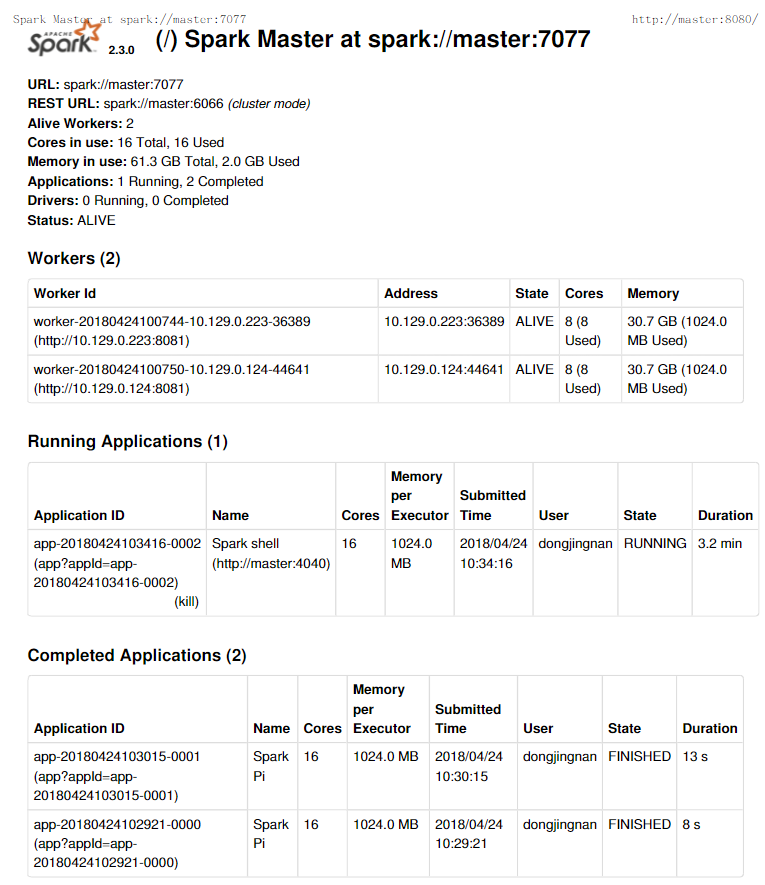
用户在master主机上的火狐浏览器登录网址http://master:8080/ 查看应用的运行情况
向hadoop yarn 集群管理器提交应用
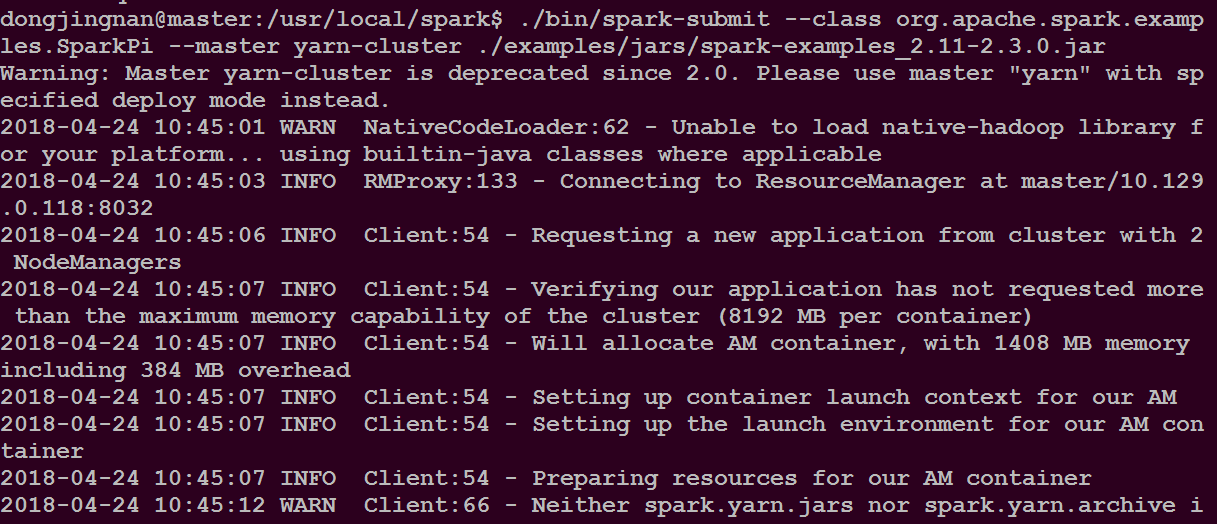
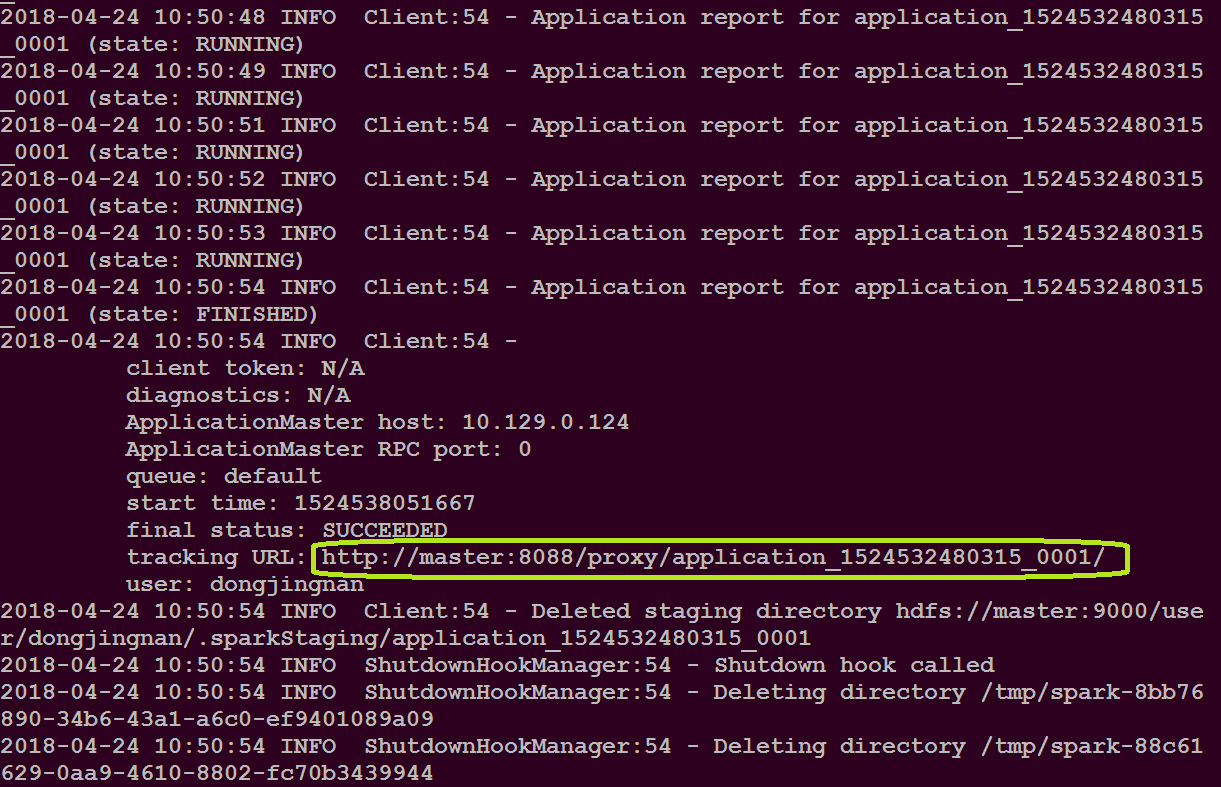
在master主机登录上图绿色圈住的网址,查看应用的运行情况
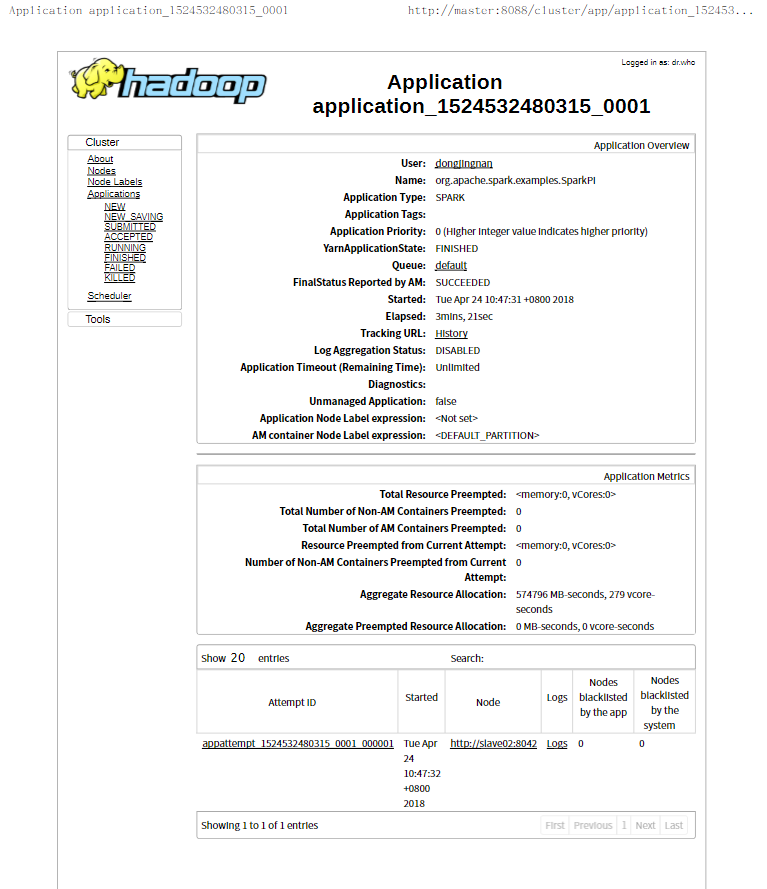
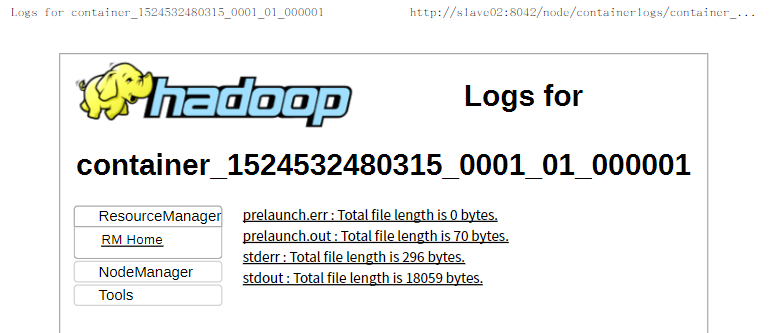
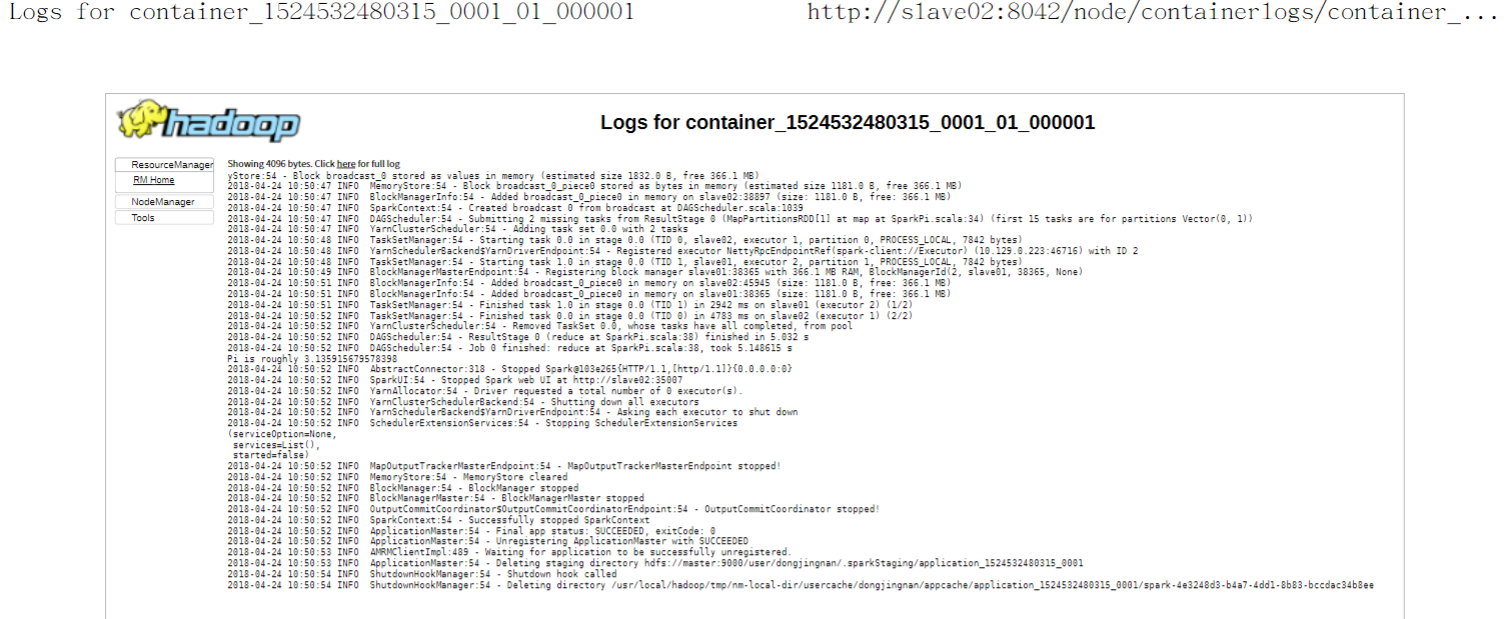
为了进行下面的程序,请把所需的文件上传到hdfs中,以备后面使用,另外每次关机之后,再重启后又要重新做一遍
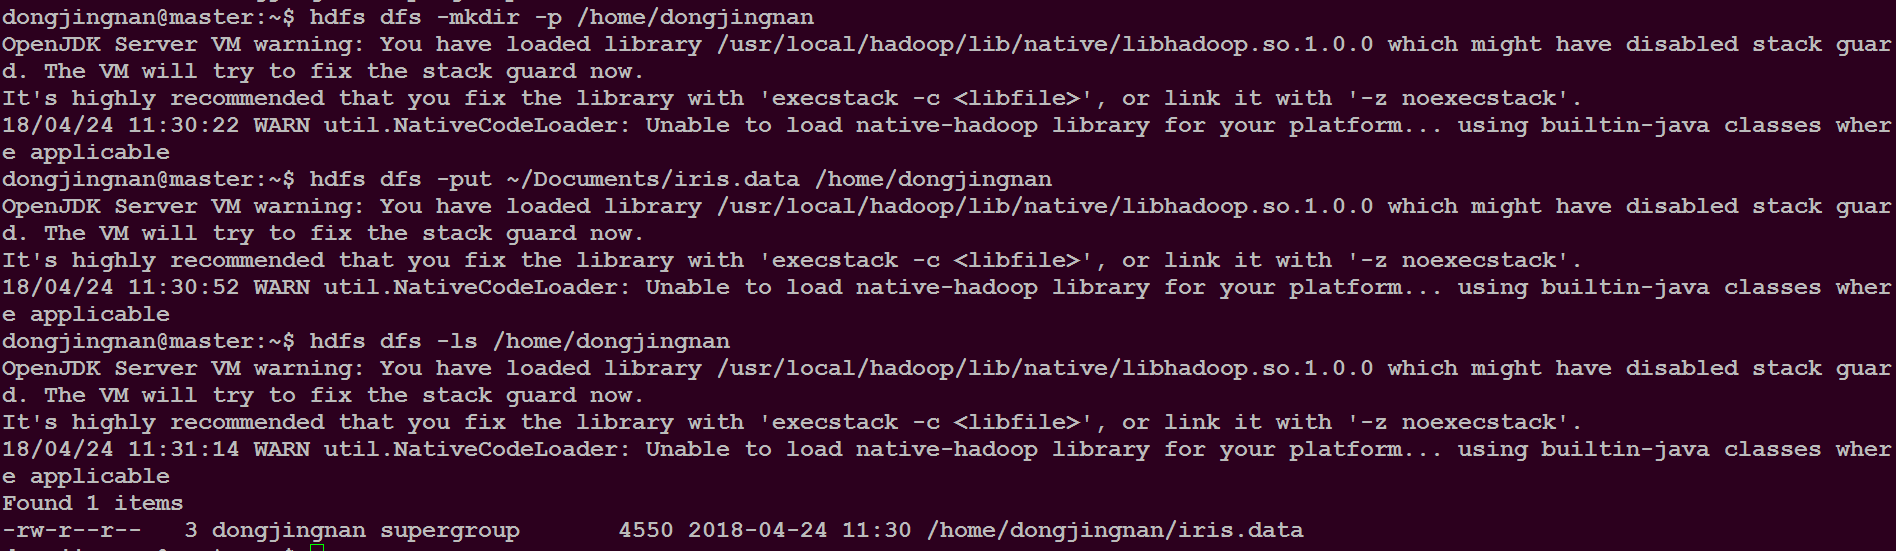
在集群中运行spark-shell
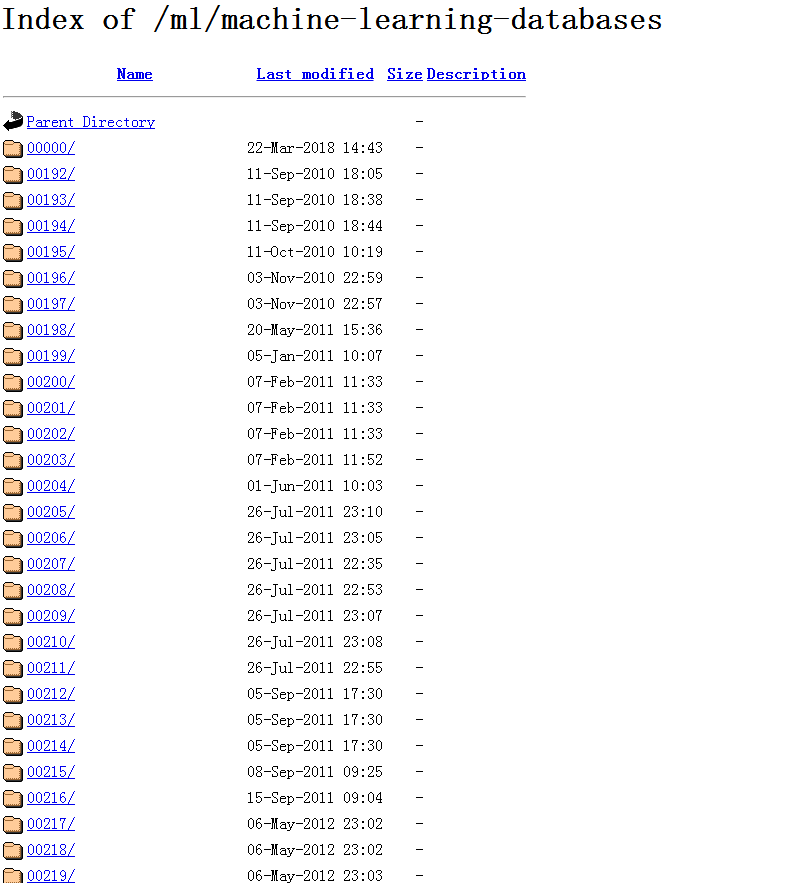
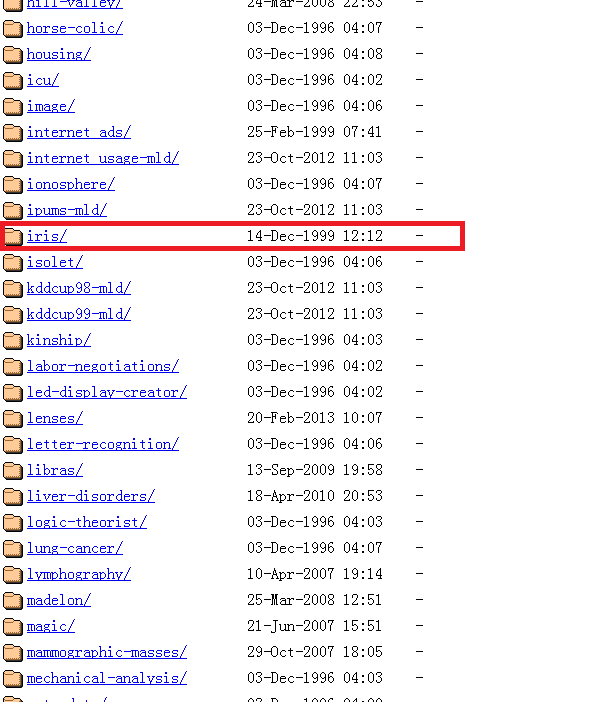
本实验所需的数据集可以在网址https://archive.ics.uci.edu/ml/machine-learning-databases/ 下载
实验所需的数据集是鸢尾花数据集
在网址https://www.jetbrains.com/idea/downloads/#section=windows 下载Intellij IDEA
选择使用的操作系统的环境,建议下载Ultimate版本,因为好像Community版本不能够将编写的程序打包成jar文件,下文要用到打包的jar文件
刚开始的时候不要设置SparkConf后的setmaster()内容
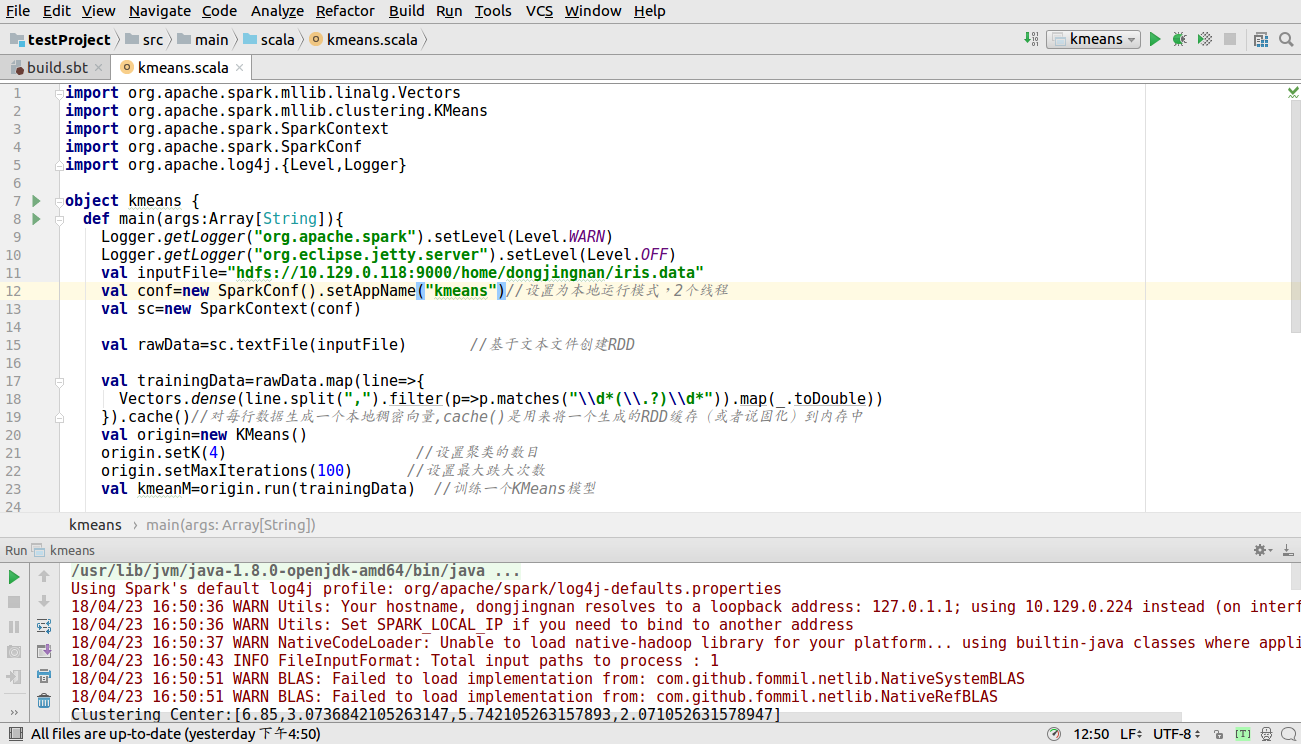
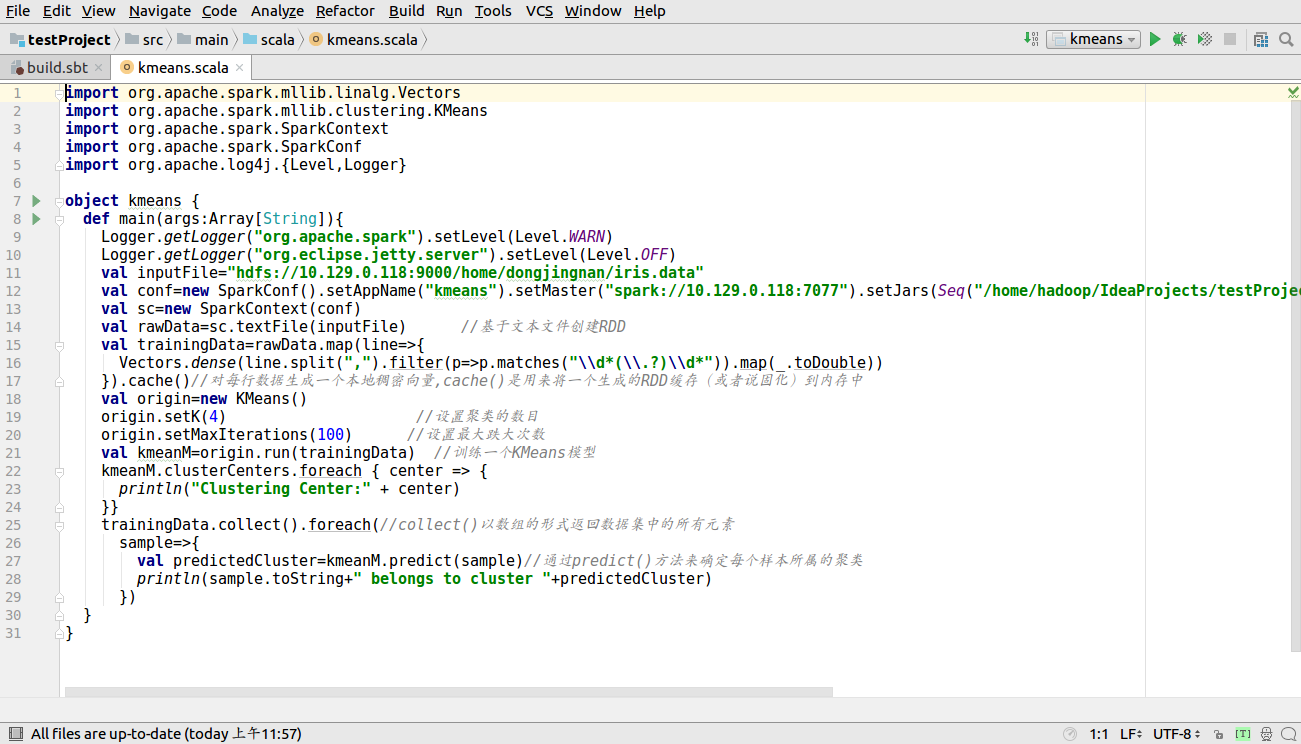
kmeans算法的实现代码如下图所示
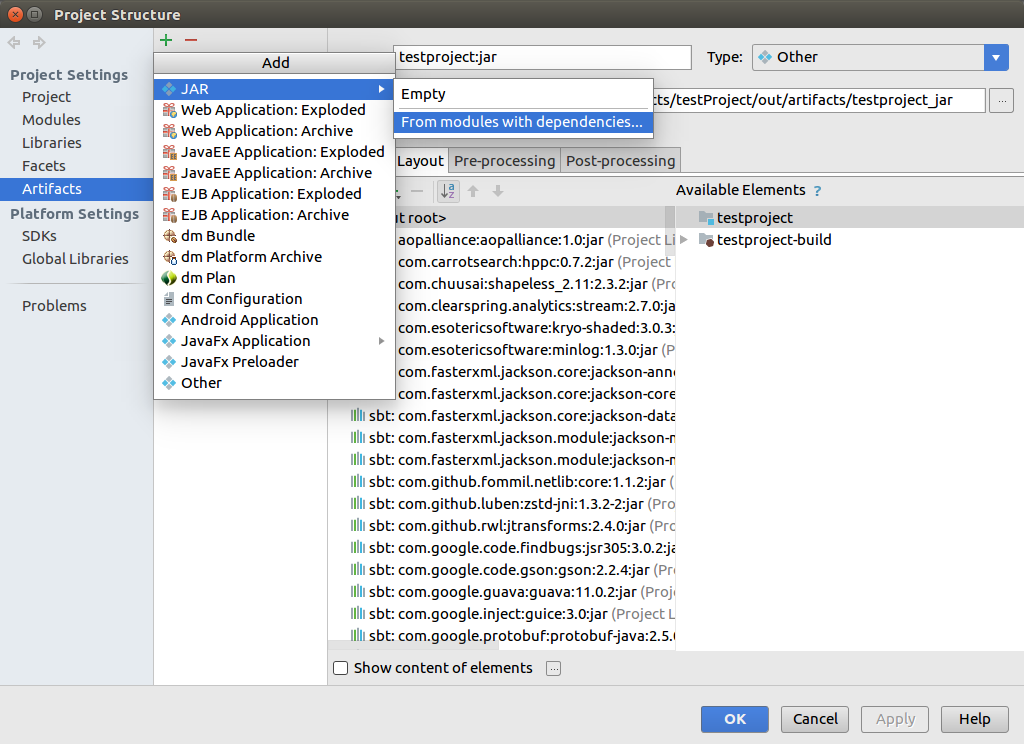
打包过程如下所示,点击file--Project Structure--单击+号
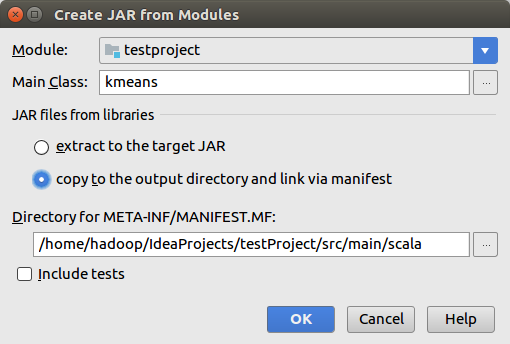
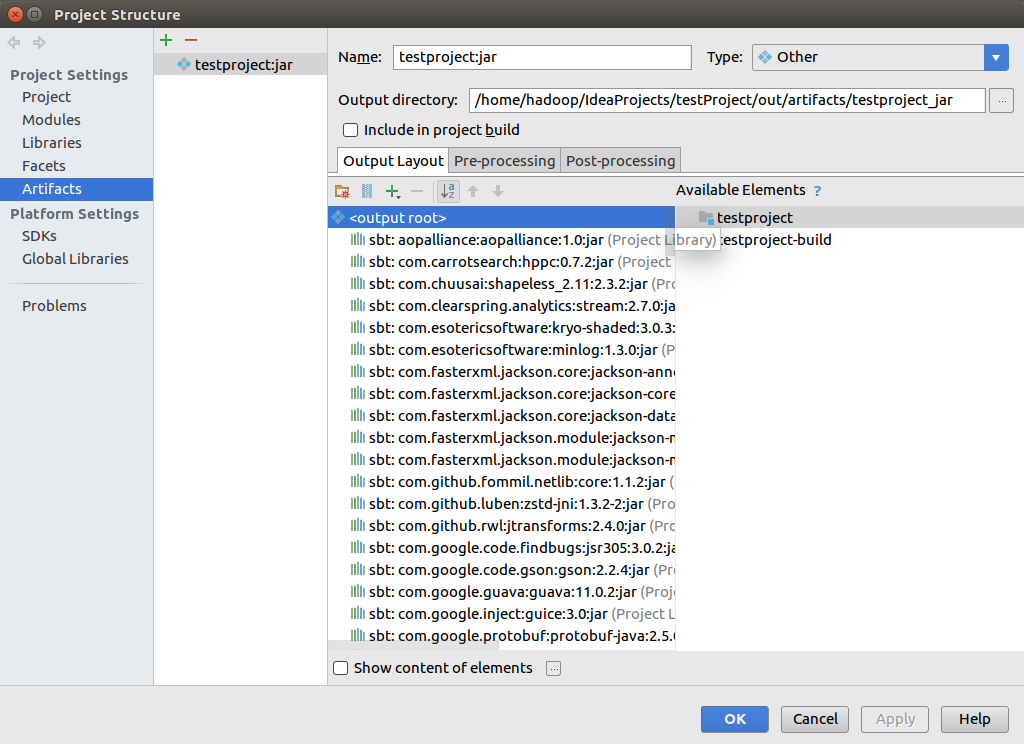
单击Build-Build Artifacts.. 之后在单击下图中的Build
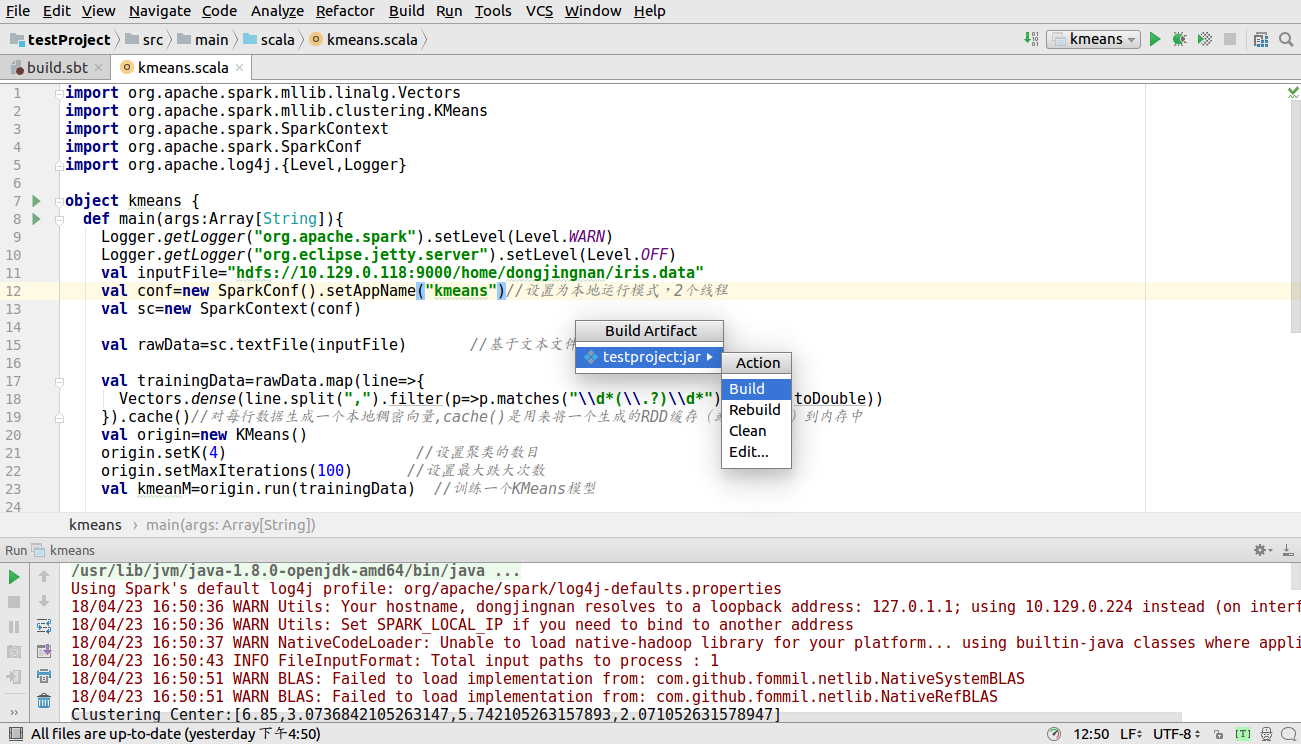
稍等会,可以看到下图中出现out 文件夹
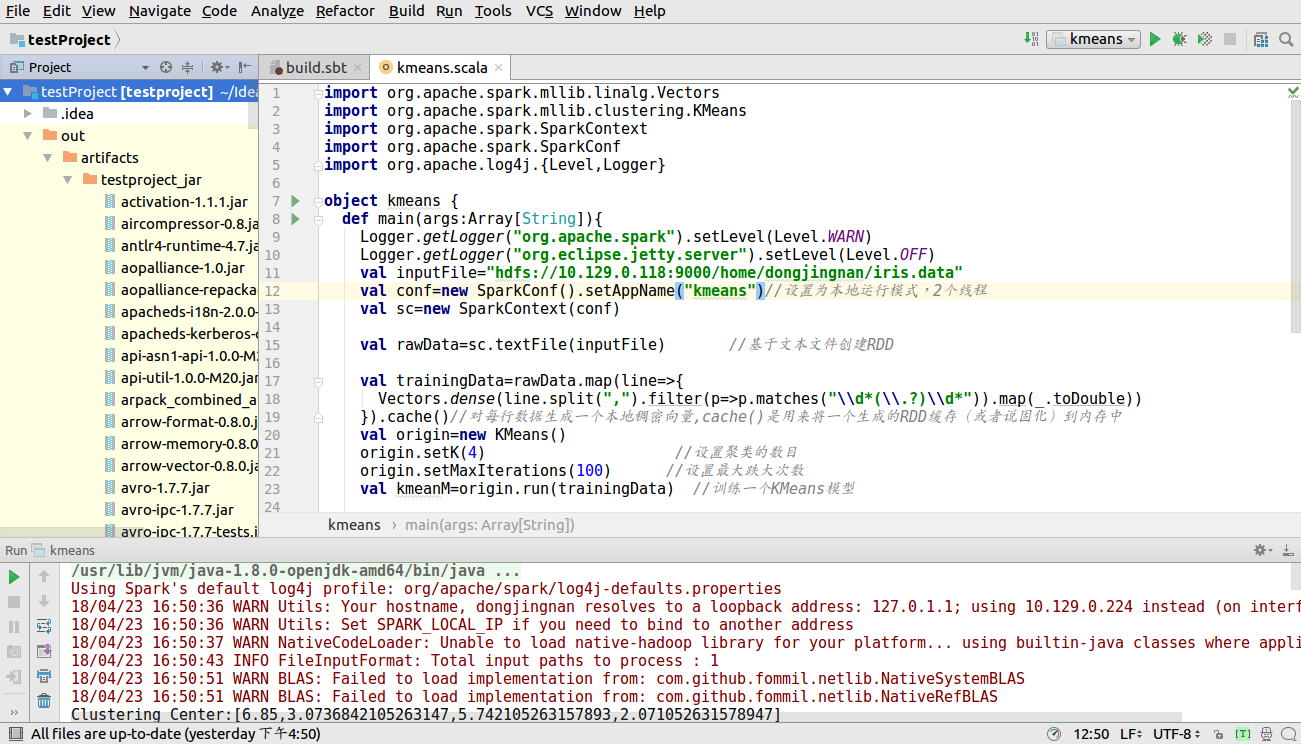
找到项目打包成的jar文件夹,如下图所示
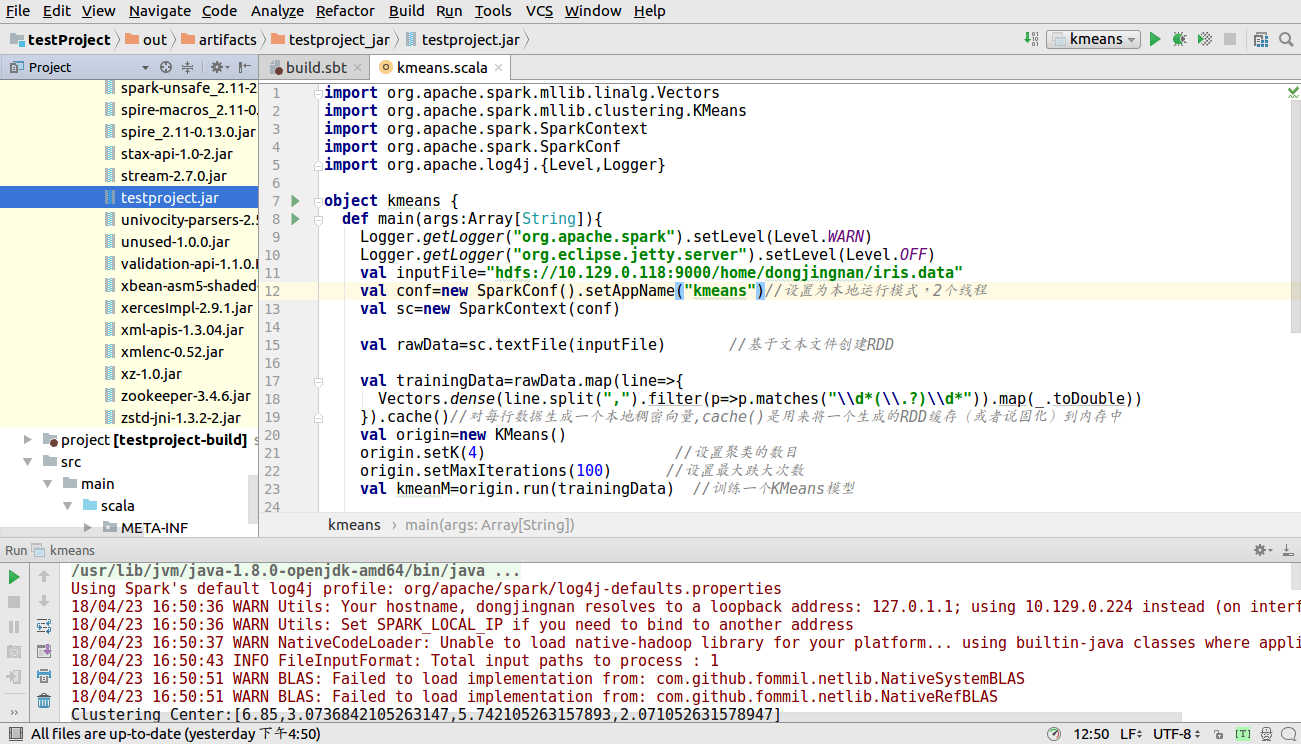
此时设置SparkConf后的setMaster()和setJar()
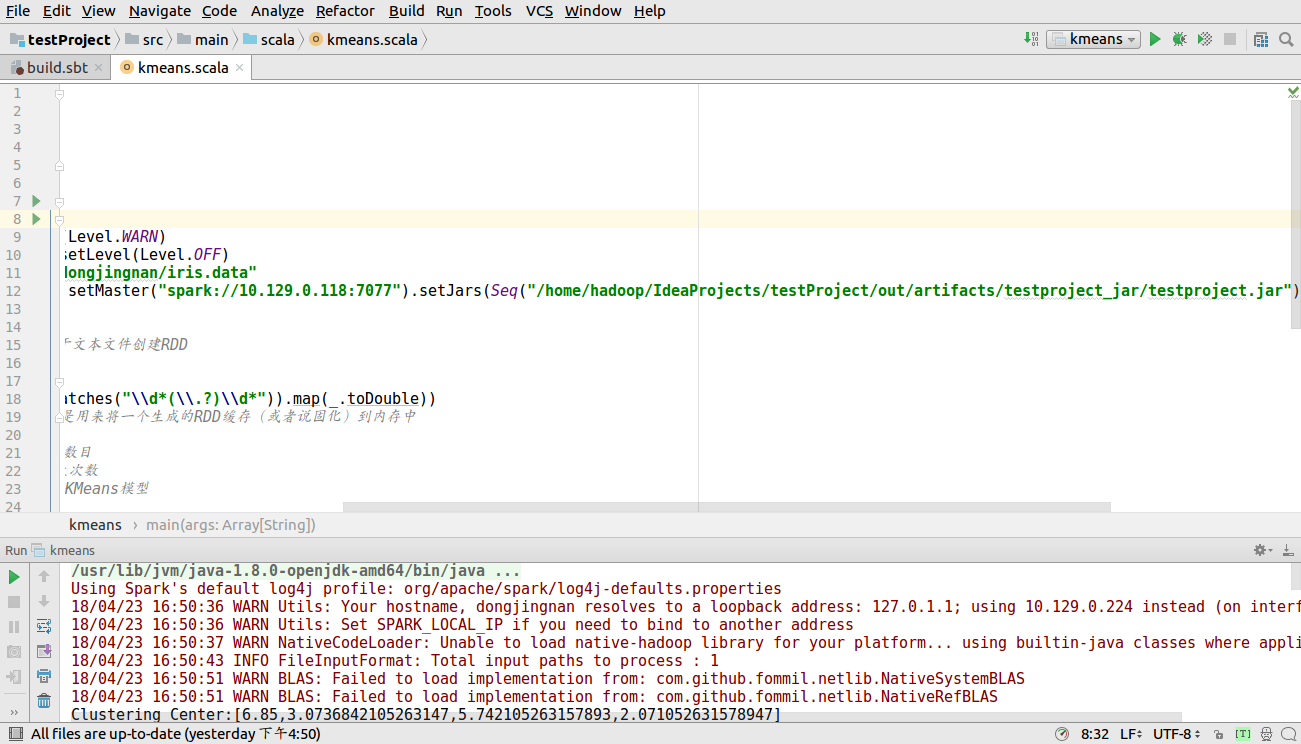
接下来运行程序单击Run-->Run kmeans 出现如下图所示
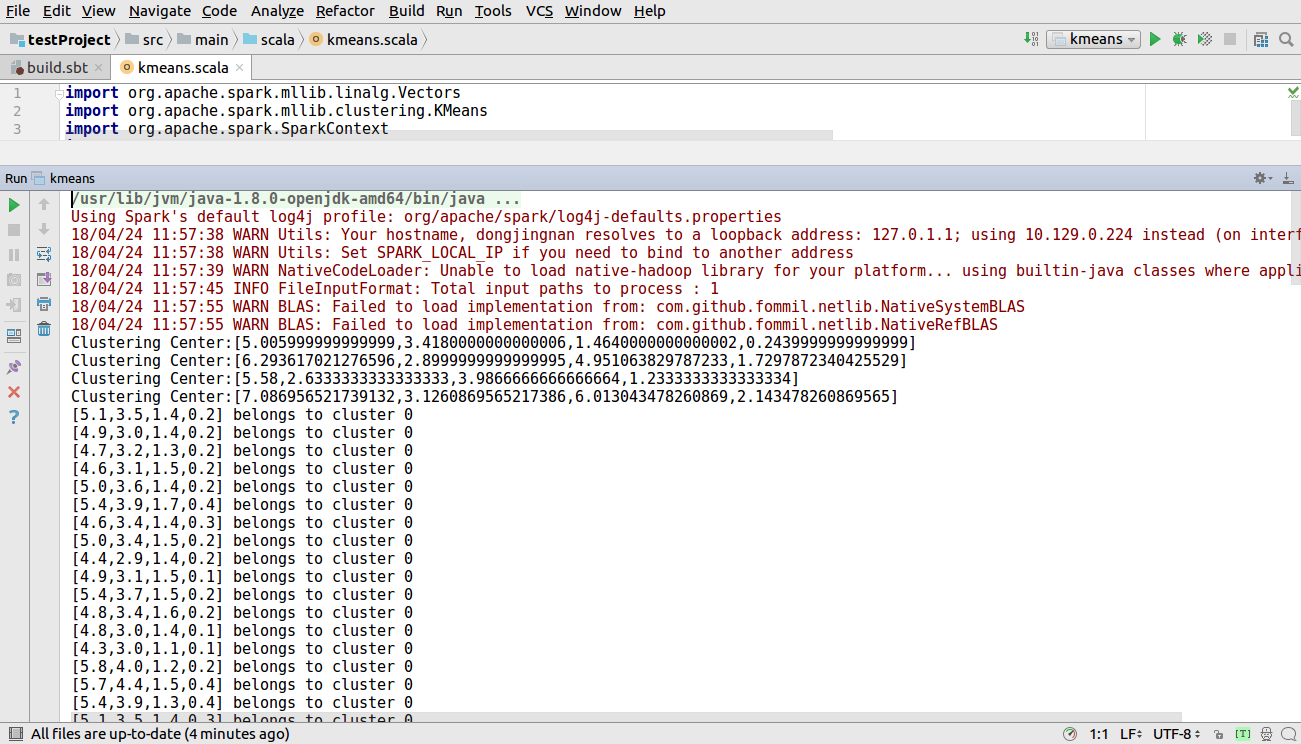
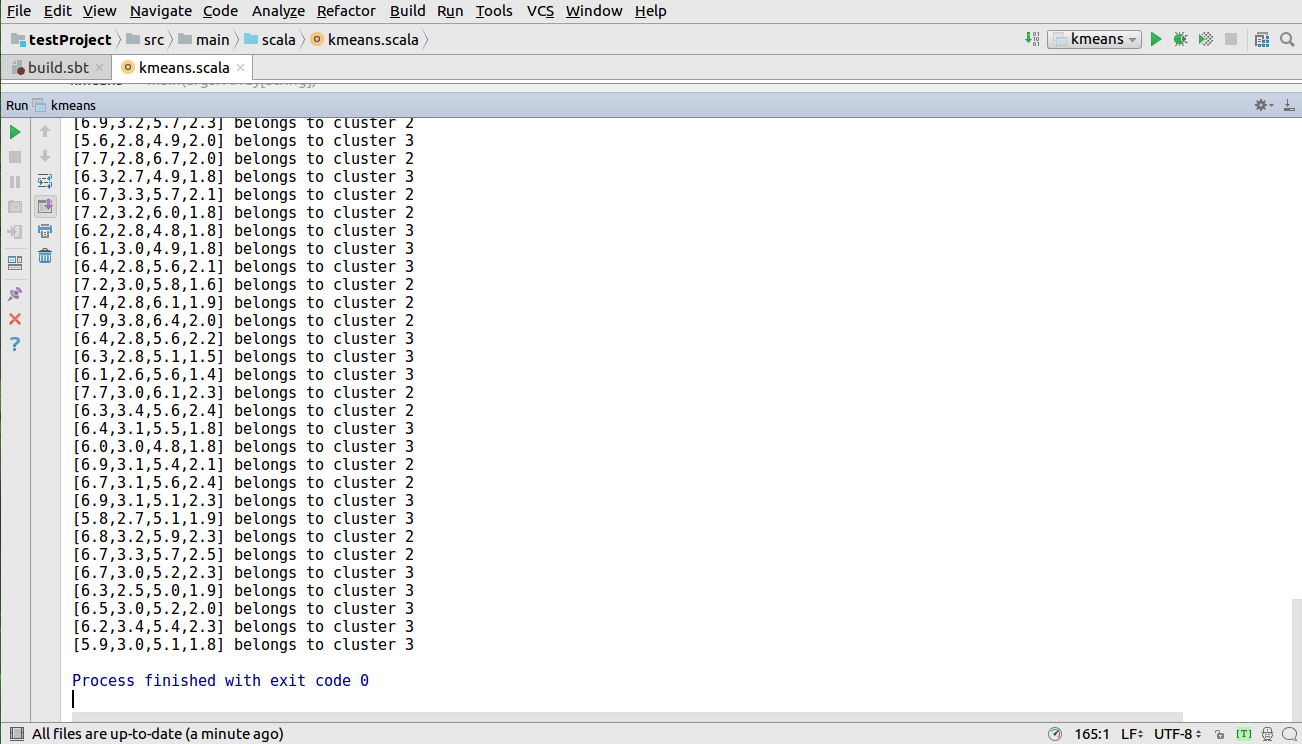
打开网址htttps://master:7077/查看应用运行情况
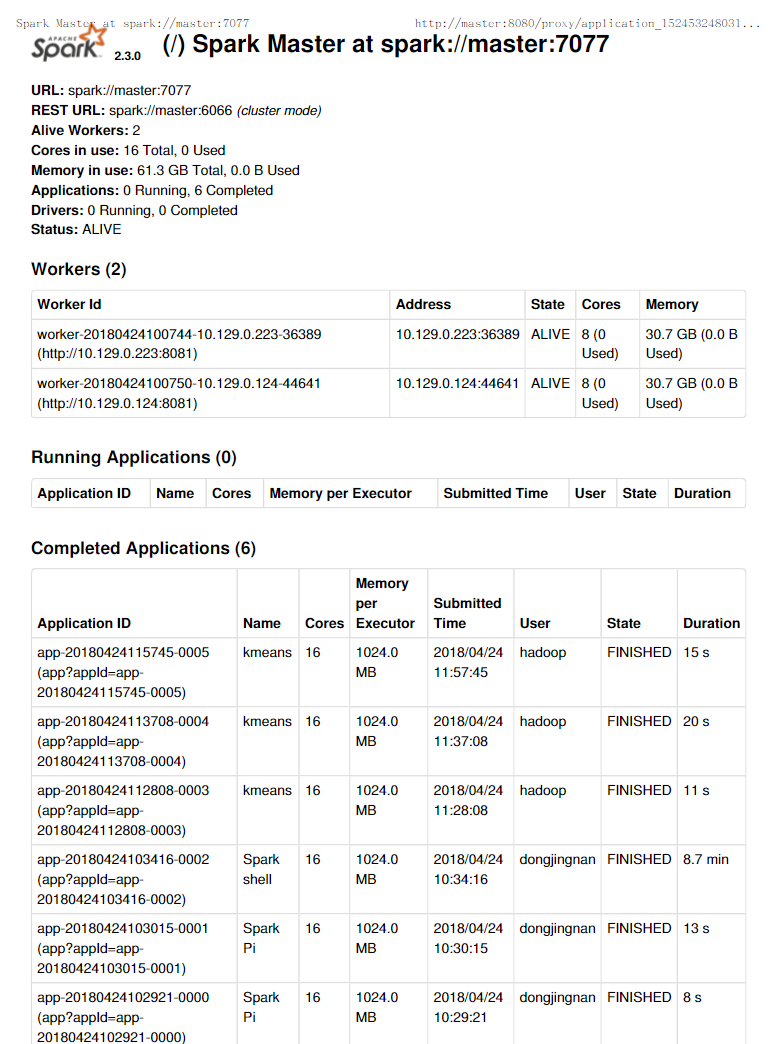
到此,整个项目运行完毕。
谢谢观看,不对之处,欢迎多多指正。
IntelliJ IDEA编写的spark程序在远程spark集群上运行的更多相关文章
- Spark优化之二:集群上运行jar程序,状态一直Accepted且不停止不报错
如果运行Spark集群时状态一直为Accepted且不停止不报错,比如像下面这样的情况: 15/06/14 11:33:33 INFO yarn.Client: Application report ...
- [Spark Core] 在 Spark 集群上运行程序
0. 说明 将 IDEA 下的项目导出为 Jar 包,部署到 Spark 集群上运行. 1. 打包程序 1.0 前提 搭建好 Spark 集群,完成代码的编写. 1.1 修改代码 [添加内容,判断参数 ...
- 用python + hadoop streaming 编写分布式程序(二) -- 在集群上运行与监控
写在前面 相关随笔: Hadoop-1.0.4集群搭建笔记 用python + hadoop streaming 编写分布式程序(一) -- 原理介绍,样例程序与本地调试 用python + hado ...
- 将java开发的wordcount程序提交到spark集群上运行
今天来分享下将java开发的wordcount程序提交到spark集群上运行的步骤. 第一个步骤之前,先上传文本文件,spark.txt,然用命令hadoop fs -put spark.txt /s ...
- 06、部署Spark程序到集群上运行
06.部署Spark程序到集群上运行 6.1 修改程序代码 修改文件加载路径 在spark集群上执行程序时,如果加载文件需要确保路径是所有节点能否访问到的路径,因此通常是hdfs路径地址.所以需要修改 ...
- 在local模式下的spark程序打包到集群上运行
一.前期准备 前期的环境准备,在Linux系统下要有Hadoop系统,spark伪分布式或者分布式,具体的教程可以查阅我的这两篇博客: Hadoop2.0伪分布式平台环境搭建 Spark2.4.0伪分 ...
- Spark学习之在集群上运行Spark
一.简介 Spark 的一大好处就是可以通过增加机器数量并使用集群模式运行,来扩展程序的计算能力.好在编写用于在集群上并行执行的 Spark 应用所使用的 API 跟本地单机模式下的完全一样.也就是说 ...
- Eclipse提交代码到Spark集群上运行
Spark集群master节点: 192.168.168.200 Eclipse运行windows主机: 192.168.168.100 场景: 为了测试在Eclipse上开发的代码在Spa ...
- 在集群上运行Spark
Spark 可以在各种各样的集群管理器(Hadoop YARN.Apache Mesos,还有Spark 自带的独立集群管理器)上运行,所以Spark 应用既能够适应专用集群,又能用于共享的云计算环境 ...
随机推荐
- 【转载】Spring Cloud底层原理
概述 毫无疑问,Spring Cloud是目前微服务架构领域的翘楚,无数的书籍博客都在讲解这个技术.不过大多数讲解还停留在对Spring Cloud功能使用的层面,其底层的很多原理,很多人可能并不知晓 ...
- SQL Server 2008各版本介绍区别(包含企业版 开发者版 标准版 Web版 工作组版 Express版 Compact版)
SQL Server 2008分为SQL Server 2008企业版.标准版.工作组版.Web版.开发者版.Express版.Compact 3.5版,其功能和作用也各不相同,其中SQL Serve ...
- DevExpress13.2.9 控件使用经验总结
一.换肤功能 1. 添加 DevExpress.OfficeSkins 和 DevExpress.BonusSkins 两个引用 2. 皮肤注册 DevExpress.UserSkins.BonusS ...
- js画一棵树
用纯js画一棵树.思路: 1.一棵树的图片,作为页面背景: 2.通过html5中的canvas画布进行遮罩: 3.定时每隔10ms,从下往上清除1px的遮罩: <!DOCTYPE html> ...
- Java SE 8 的流库学习笔记
前言:流提供了一种让我们可以在比集合更高的概念级别上指定计算的数据视图.如: //使用foreach迭代 long count = 0; for (String w : words) { if (w. ...
- Ubuntu16.04下安装MATLAB 2016b!完美运行
目录 1.下载MATLAB 2016b 2.挂载iso 3.安装MATLAB 4.破解 5.快捷键与运行 1.下载MATLAB 2016b 下载matlab 2016b for linux(可以百度搜 ...
- 解决Windows资源管理器右键菜单打开EditPlus容易导致资源管理器无响应问题
这个问题确实很烦人,经常导致 资源管理器无响应,关闭后整个资源管理器彻底崩溃,原因未知.本着折腾和强迫症精神,这个问题一定要解决.方法如下: 1.不要用EditPlus自带的添加到系统右键菜单选项. ...
- bootstrap-table sum总数量统计
写了一个分页要显示数据中所有金额的总数 但是使用 footerformatter 却不知道该怎么赋值 没办法只能放到页脚了 先上个效果图: 这样做要修改源码: bootstrap-table. ...
- 对数损失函数(Logarithmic Loss Function)的原理和 Python 实现
原理 对数损失, 即对数似然损失(Log-likelihood Loss), 也称逻辑斯谛回归损失(Logistic Loss)或交叉熵损失(cross-entropy Loss), 是在概率估计上定 ...
- 《深入理解mybatis原理》 Mybatis数据源与连接池
对于ORM框架而言,数据源的组织是一个非常重要的一部分,这直接影响到框架的性能问题.本文将通过对MyBatis框架的数据源结构进行详尽的分析,并且深入解析MyBatis的连接池. 本文首先会讲述MyB ...