
第九篇 数据表设计和保存item到json文件
上节说到Pipeline会拦截item,根据设置的优先级,item会依次经过这些Pipeline,所以可以通过Pipeline来保存文件到json、数据库等等。
下面是自定义json
#存储item到json文件

class JsonWithEncodingPipeline(object):

    def __init__(self):

        #使用codecs模块来打开文件,可以帮我们解决很多编码问题,下面先初始化打开一个json文件

        import codecs

        self.file = codecs.open('article.json','w',encoding='utf-8')

    #接着创建process_item方法执行item的具体的动作

    def process_item(self, item, spider):

        import json

        #注意ensure_ascii入参设置成False,否则在存储非英文的字符会报错

        lines = json.dumps(dict(item),ensure_ascii=False) + "\n"

        self.file.write(lines)

        #注意最后需要返回item,因为可能后面的Pipeline会调用它

        return item

    #最后关闭文件

    def spider_close(self,spider):

        self.file.close()
scrapy内置了json方法:
from scrapy.exporters import JsonItemExporter
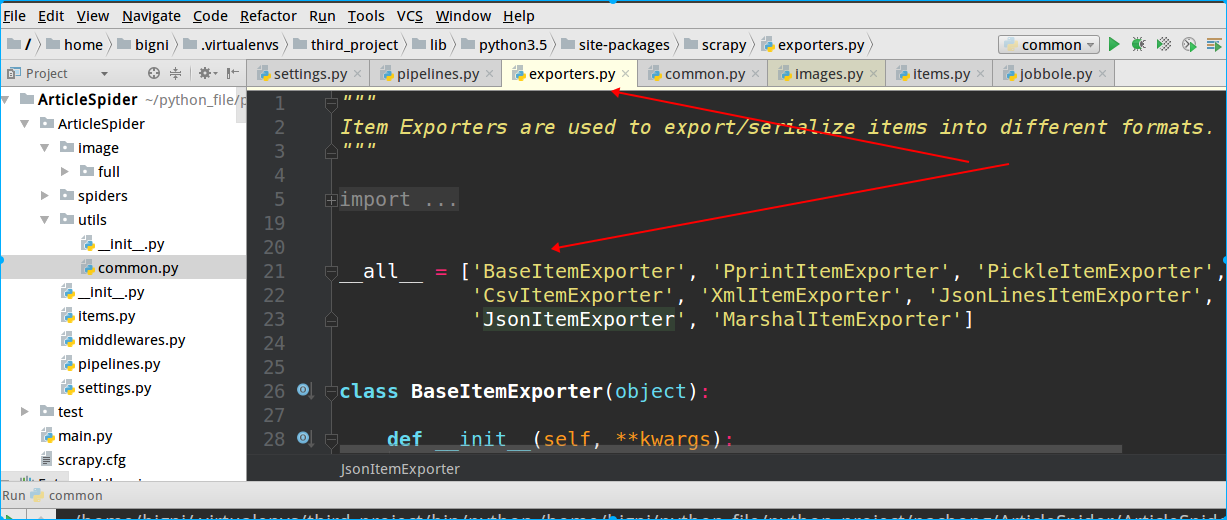
除了JsonItemExporter,scrapy提供了多种类型的exporter
class JsonExporterPipeline(object):

    #调用scrapy提供的json export导出json文件

    def __init__(self):

        #打开一个json文件

        self.file = open('articleexport.json','wb')

        #创建一个exporter实例,入参分别是下面三个,类似前面的自定义导出json

        self.exporter = JsonItemExporter(self.file,encoding='utf-8',ensure_ascii=False)

        #开始导出

        self.exporter.start_exporting()

    def close_spider(self,spider):

        #完成导出

        self.exporter.finish_exporting()

        #关闭文件

        self.file.close()

    #最后也需要调用process_item返回item

    def process_item(self, item, spider):

        self.exporter.export_item(item)

        return item
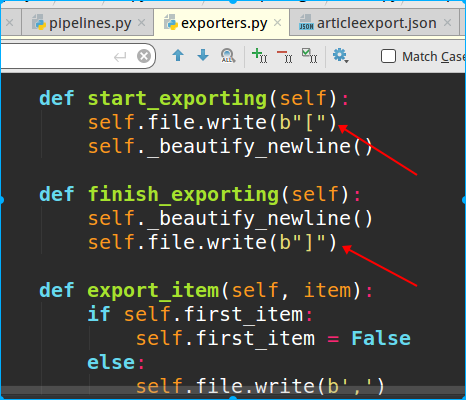
和自定义json相比,存的文件由【】
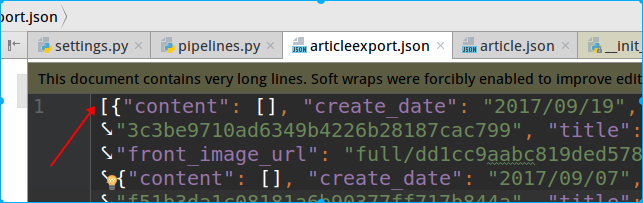
通过源码可以看到如下:
接着是如何把数据存储到mysql,我这开发环境是ubuntu,支持的mysql-client工具不多,免费的就用Mysql Workbench,也可以使用navicat(要收费)
spider要创建的一张表,和ArticleSpider项目里的item一一对应就行。
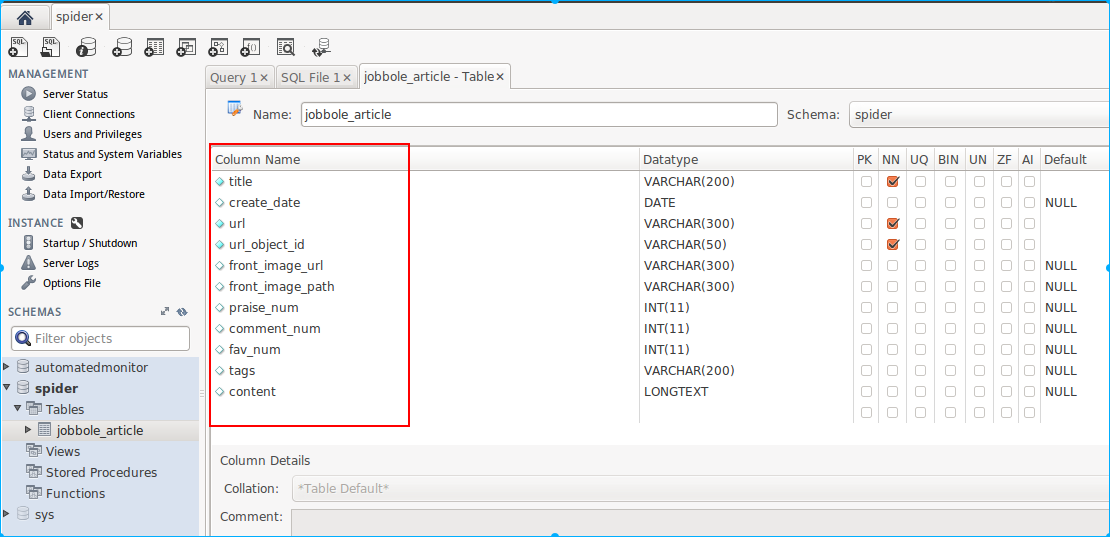
然后接下来是配置程序连接mysql
这里我使用第三方库pymysql来连接mysql,安装方式很简单,可以使用pycharm内置的包安装,也可以在虚拟环境用pip安装
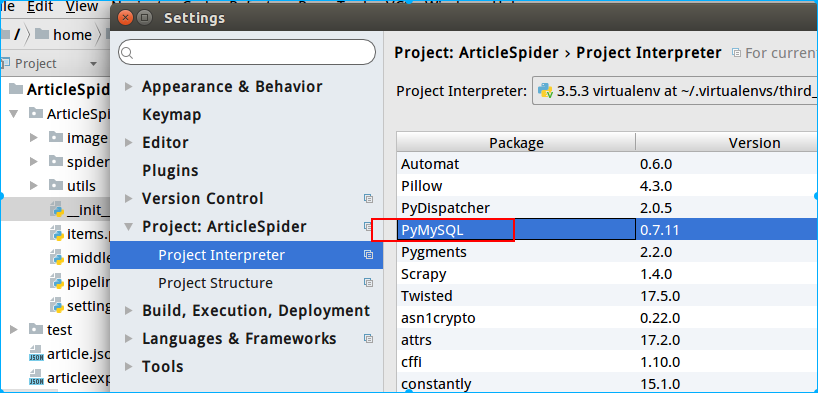
然后直接在pipline里创建mysql的pipline
import pymysql

class MysqlPipeline(object):

    def __init__(self):

        """

        初始化,建立mysql连接conn,并创建游标cursor

        """

        self.conn = pymysql.connect(

            host='localhost',

            database='spider',

            user='root',

            passwd='',

            charset='utf8',

            use_unicode=True

        )

        self.cursor = self.conn.cursor()

    def process_item(self,item,spider):

        #要执行的sql语句

        insert_sql = """

            insert into jobbole_article(title,create_date,url,url_object_id,

            front_image_url,front_image_path,praise_num,comment_num,fav_num,tags,content)

            VALUES (%s,%s,%s,%s,%s,%s,%s,%s,%s,%s,%s)

        """

        #使用游标的execute方法执行sql

        self.cursor.execute(insert_sql,(item["title"],item['create_date'],

                                        item['url'],item['url_object_id'],

                                        item['front_image_url'],item['front_image_path'],

                                        item['praise_num'],item['comment_num'],item['fav_num'],

                                        item['tags'],item['content']))

        #commit提交才能生效

        self.conn.commit()

        return item
上面的这种mysql存储方式是同步的,也就是execute和commit不执行玩,是不能继续存储数据的,而且明显的scrapy爬取速度会比数据存储到mysql的速度快些,
所以scrapy提供了另外一种异步的数据存储方法(一种异步的容器,还是需要使用pymysql)
首先把mysql的配置连接信息写进setting配置文件,方便后期修改
MYSQL_HOST = "localhost"

MYSQL_DBNAME = 'spider'

MYSQL_USER = "root"

MYSQL_PASSWORD = ""
接着在pipeline中导入scrapy提供的异步的接口:adbapi
from twisted.enterprise import adbapi
完整的pipeline如下:
class MysqlTwistedPipeline(object):

    #下面这两个函数完成了在启动spider的时候,就把dbpool传入进来了

    def __init__(self,dbpool):

        self.dbpool = dbpool

    #通过下面这种方式,可以很方便的拿到setting配置信息

    @classmethod

    def from_settings(cls,setting):

        dbparms = dict(

        host = setting['MYSQL_HOST'],

        db = setting['MYSQL_DBNAME'],

        user = setting['MYSQL_USER'],

        password = setting['MYSQL_PASSWORD'],

        charset = 'utf8',

        #cursorclass = pymysql.cursors.DictCursor,

        use_unicode = True,

        )

        #创建连接池,

        dbpool = adbapi.ConnectionPool("pymysql",**dbparms)

        return cls(dbpool)

    # 使用twisted将mysql插入变成异步执行

    def process_item(self, item, spider):

        # 指定操作方法和操作的数据

        query = self.dbpool.runInteraction(self.do_insert,item)

        #处理可能存在的异常,hangdle_error是自定义的方法

        query.addErrback(self.handle_error,item,spider)

    def handle_error(self,failure,item,spider):

        print(failure)

    def do_insert(self,cursor,item):

        #执行具体的插入

        # 根据不同的item 构建不同的sql语句并插入到mysql中

        insert_sql = """

                       insert into jobbole_article(title,create_date,url,url_object_id,

                       front_image_url,front_image_path,praise_num,comment_num,fav_num,tags,content)

                       VALUES (%s,%s,%s,%s,%s,%s,%s,%s,%s,%s,%s)

                   """

        # 使用游标的execute方法执行sql

        cursor.execute(insert_sql, (item["title"], item['create_date'],

                                         item['url'], item['url_object_id'],

                                         item['front_image_url'], item['front_image_path'],

                                         item['praise_num'], item['comment_num'], item['fav_num'],

                                         item['tags'], item['content']))
注意:导入pymysql需要单独导入cursors
import pymysql

import pymysql.cursors
一般我们只需要修改do_insert方法内容就行
还有,传递给的item要和数据表的字段对应上,不能以为不传值就会自动默认为空(但是存储到json文件就是这样)
除了pymysql,还可以通过安装mysqlclient连接数据库,但安装前需要先安装别的包,否则会报错
ubuntu需要安装:
(one_project) laoni@ubuntu:~$ sudo apt-get install libmysqlclient-dev
centos下需要安装:
(one_project) laoni@ubuntu:~$ sudo yum install python-devel mysql-devel
第九篇 数据表设计和保存item到json文件的更多相关文章
- SpringBoot + Vue + ElementUI 实现后台管理系统模板 -- 后端篇(五): 数据表设计、使用 jwt、redis、sms 工具类完善注册登录逻辑
(1) 相关博文地址: SpringBoot + Vue + ElementUI 实现后台管理系统模板 -- 前端篇(一):搭建基本环境:https://www.cnblogs.com/l-y-h/p ...
- 【原创】C#搭建足球赛事资料库与预测平台(3) 基础数据表设计
本博客所有文章分类的总目录:http://www.cnblogs.com/asxinyu/p/4288836.html 开源C#彩票数据资料库系列文章总目录:http://www.cn ...
- 【原创】C#搭建足球赛事资料库与预测平台(4) 比赛信息数据表设计
本博客所有文章分类的总目录:[总目录]本博客博文总目录-实时更新 开源C#彩票数据资料库系列文章总目录:[目录]C#搭建足球赛事资料库与预测平台与彩票数据分析目录 本篇文章开始将逐步介 ...
- 【原创】C#搭建足球赛事资料库与预测平台(6) 赔率数据表设计2
本博客所有文章分类的总目录:[总目录]本博客博文总目录-实时更新 开源C#彩票数据资料库系列文章总目录:[目录]C#搭建足球赛事资料库与预测平台与彩票数据分析目录 本篇文章开始将逐步介 ...
- MySql数据表设计,索引优化,SQL优化,其他数据库
MySql数据表设计,索引优化,SQL优化,其他数据库 1.数据表设计 1.1数据类型 1.2避免空值 1.3text类型优化 2.索引优化 2.1索引分类 2.2索引优化 3.SQL优化 3.1分批 ...
- PHP 开发 APP 接口 学习笔记与总结 - APP 接口实例 [5] 版本设计分析及数据表设计
APP 版本升级以及 APP 演示 ① 版本升级分析以及数据表设计 ② 版本升级接口开发以及 APP 演示 /** * version_upgrade 版本升级信息表 */ CREATE TABLE ...
- mysql status关键字 数据表设计中慎重使用
mysql status关键字 数据表设计中慎重使用
- 中小型WEB系统权限日志数据表设计
中小型WEB系统权限日志数据表设计 watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQvdTAxMjc1MDU3OA==/font/5a6L5L2T/fontsi ...
- 数据表设计之主键自增、UUID或联合主键
最近在做数据库设计的时候(以MySQL为主),遇到不少困惑,因为之前做数据库表设计,基本上主键都是使用自增的形式,最近因为这种做法,被领导指出存在一些不足,于是我想搞明白哪里不足. 一.MySQL为什 ...
随机推荐
- Leetcode_415字符串相加
给定两个字符串形式的非负整数 num1 和num2 ,计算它们的和. 注意: ①num1 和num2 的长度都小于 5100.②num1 和num2 都只包含数字 0-9.③num1 和num2 都不 ...
- activiti7组任务测试
package com.zcc.activiti05; import org.activiti.engine.*;import org.activiti.engine.repository.Deplo ...
- 神奇,教你用随机数打印hello world
下面是一段随机数程序. public static void main(String[] args) { System.out.println(randomString(-229985452) + & ...
- Android组件内核之间组件间通信方案(四)下篇
阿里P7Android高级架构进阶视频免费学习请点击:https://space.bilibili.com/474380680本篇文章将继续从以下两个内容来介绍通信方案: [ViewModel 与 V ...
- zookeeper的监听
统一配置管理.统一命名服务.分布式锁.集群管理
- Linux下多线程pthread内存泄露
目标文件:/proc/<pid>/maps 若其中出现了大量的8K左右的内存碎片,则说明出现了内存泄露.同理,如果相应pid进程的maps文件中出现了很多内存碎片,也说明出现了内存泄露. ...
- JSP界面引用百度地图获取坐标
需求: 需要在JSP界面上引用百度地图,文本框中输入地址之后,自动拿到在百度地图上的经纬度 解决步骤: 1.引入百度地图api: head中进行引用<script type="text ...
- htop资源管理器
htop是linux资源管理器,安装后界面如下图: 当我们用安装yum -y htop时,会报错,这是因为需要安装扩展源 yum -y epel 扩展源 安装完扩展源之后,就可以安装了
- linux6.5 网卡绑定
Linux网口绑定 通过网口绑定(bond)技术,可以很容易实现网口冗余,负载均衡,从而达到高可用高可靠的目的.前提约定: 2个物理网口分别是:eth0,eth1 绑定后的虚拟口是:bond0 服务器 ...
- mysql5.7 基于gtid的主从复制
基本环境 版本 5.7.14 主库ip:192.168.1.100 port:3306 从库ip:102.168.1.101 port:3306 搭建注意事项 主库配置 gtid-mode=on en ...