
5. Spark调优
*以下内容由《Spark快速大数据分析》整理所得。
读书笔记的第五部分是讲的是Spark调优相关的知识点。
一、并行度调优
二、序列化格式优化
三、内存管理优化
四、Spark SQL性能优化
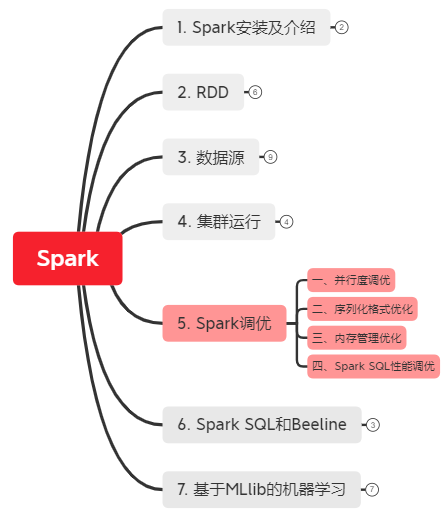
一、并行度调优
并行度调优有两种方法:
1. 是在数据混洗操作时,使用参数的方式为混洗后的RDD指定并行度。
2. 对于任何已有的RDD,可以进行重新分区来获取更多或者更少的分区数。重新分区操作通过 repartition() 实现,该操作会把 RDD随机打乱并分成设定的分区数目。如果你确定要减少RDD分区,可以使用 coalesce() 操作。由于没有打乱数据,该操作比 repartition() 更为高效。
例子:在PySpark shell中合并分区过多的RDD
# 以可以匹配数千个文件的通配字符串作为输入

>>> input = sc.textFile("s3n://log-files/2014/*.log")

>>> input.getNumPartitions() # 得到分区数

35154


# 排除掉大部分数据的筛选方法

>>> lines = input.filter(lambda line: line.startswith("2014-10-17"))

>>> lines.getNumPartitions()

35154


# 在缓存lines之前先对其进行合并分区操作(即:合并分区->缓存转化操作)

>>> lines = lines.coalesce(5).cache()

>>> lines.getNumPartitions()

4


# 可以在合并之后的RDD上进行后续分析(即:行为操作)

>>> lines.count()
二、序列化格式优化
序列化会在数据进行混洗操作时发生。使用Kryo序列化工具,可以提供比Java的序列化工具更短的序列化时间和更高压缩比的二进制表示。你只需要设置 spark.serializer 为 org.apache.spark.serializer.KryoSerializer 即可。
例子:使用 Kryo 序列化工具并注册所需类

val conf = new SparkConf()

conf.set("spark.serializer", "org.apache.spark.serializer.KryoSerializer")
三、内存管理优化
内存管理的优化可以从三块地方下手:
1. RDD存储:当调用RDD的 persist() 或cache()方法时,这个RDD的分区会被存储到缓存区中。Spark会根据 spark.storage.memoryFraction 限制用来缓存的内存占整个JVM堆空间的比例大小(默认60%)。如果超出限制,旧的分区数据会被移出内存。
2. 数据混洗与聚合的缓存区:当进行数据混洗操作时,Spark会创建出一些中间缓存区来存储数据混洗的输出数据。根据 spark.shuffle.memoryFraction 限定这种缓存区内存占总内存的比例(默认20%)
3. 用户代码:Spark可以执行任意的用户代码,所以用户的函数可以自行申请大量内存。用户代码可以访问JVM堆空间中除分配给 RDD存储和数据混洗存储以外的全部剩余空间(默认20%)。
注意:如果用户代码中分配了大量的对象,那么降低RDD存储和数据混洗存储所占用的空间可以有效避免程序内存不足的情况。
四、Spark SQL性能调优
beeline> set spark.sql.codegen=true; 可以提高大型查询的性能,但在进行小规模查询时会变慢(即不推荐小的即时查询时用)。
5. Spark调优的更多相关文章
- 【Spark学习】Apache Spark调优
Spark版本:1.1.0 本文系以开源中国社区的译文为基础,结合官方文档翻译修订而来,转载请注明以下链接: http://www.cnblogs.com/zhangningbo/p/4117981. ...
- 【Spark调优】提交job资源参数调优
[场景] Spark提交作业job的时候要指定该job可以使用的CPU.内存等资源参数,生产环境中,任务资源分配不足会导致该job执行中断.失败等问题,所以对Spark的job资源参数分配调优非常重要 ...
- 【Spark调优】大表join大表,少数key导致数据倾斜解决方案
[使用场景] 两个RDD进行join的时候,如果数据量都比较大,那么此时可以sample看下两个RDD中的key分布情况.如果出现数据倾斜,是因为其中某一个RDD中的少数几个key的数据量过大,而另一 ...
- 【Spark调优】小表join大表数据倾斜解决方案
[使用场景] 对RDD使用join类操作,或者是在Spark SQL中使用join语句时,而且join操作中的一个RDD或表的数据量比较小(例如几百MB或者1~2GB),比较适用此方案. [解决方案] ...
- 【Spark调优】数据倾斜及排查
[数据倾斜及调优概述] 大数据分布式计算中一个常见的棘手问题——数据倾斜: 在进行shuffle的时候,必须将各个节点上相同的key拉取到某个节点上的一个task来进行处理,比如按照key进行聚合或j ...
- 【Spark调优】Broadcast广播变量
[业务场景] 在Spark的统计开发过程中,肯定会遇到类似小维表join大业务表的场景,或者需要在算子函数中使用外部变量的场景(尤其是大变量,比如100M以上的大集合),那么此时应该使用Spark的广 ...
- 【Spark调优】Kryo序列化
[Java序列化与反序列化] Java序列化是指把Java对象转换为字节序列的过程:而Java反序列化是指把字节序列恢复为Java对象的过程.序列化使用场景:1.数据的持久化,通过序列化可以把数据永久 ...
- 【翻译】Spark 调优 (Tuning Spark) 中文版
由于Spark自己的调优guidance已经覆盖了很多很有价值的点,因此这里直接翻译一份过来.也作为一个积累. Spark 调优 (Tuning Spark) 由于大多数Spark计算任务是在内存中运 ...
- 【Spark调优】Shuffle原理理解与参数调优
[生产实践经验] 生产实践中的切身体会是:影响Spark性能的大BOSS就是shuffle,抓住并解决shuffle这个主要原因,事半功倍. [Shuffle原理学习笔记] 1.未经优化的HashSh ...
- 【Spark调优】:结合业务场景,优选高性能算子
聚合操作使用reduceByKey/aggregateByKey替代groupByKey 参见我的这篇博客说明 [Spark调优]:如果实在要shuffle,使用map侧预聚合的算子 内存充足前提下使 ...
随机推荐
- ansible-playbook文件复用
1. ansible-playbook文件复用 1.1) include 和 import区别 include(动态):在运行时导入 --list-tags,--list-tasks不会显示到输出 ...
- 持续集成工具之Jenkins pipline简单示例
前文我们主要聊了下jenkins的插件安装.用户及权限管理.邮件发送.配置凭证到gitlab上拉取项目和创建普通job:回顾请参考https://www.cnblogs.com/qiuhom-1874 ...
- 编程体系结构(08):Spring.Mvc.Boot框架
本文源码:GitHub·点这里 || GitEE·点这里 一.Spring框架 1.框架概述 Spring是一个开源框架,框架的主要优势之一就是其分层架构,分层架构允许使用者选择使用哪一个组件,同时为 ...
- spring boot:使接口返回统一的RESTful格式数据(spring boot 2.3.1)
一,为什么要使用REST? 1,什么是REST? REST是软件架构的规范体系,它把资源的状态用URL进行资源定位, 以HTTP动作(GET/POST/DELETE/PUT)描述操作 2,REST的优 ...
- 第十四章 Linux三剑客之老大—awk
一.awk # 擅长取列 计算 数组 函数 编程语言 内部命令 内部变量 NR #行号 $0 #完整的一行内容 $n # n 是数字 表示取出第几列 多列用逗号分割 -F #FS 分隔符的变量 NF ...
- Markdown--补充版
markdown语法实例 markdown语法实例 强调 分割线 引用 标题Setext方式 大标题 小标题 标题Atx方式 一级标题 二级标题 三级标题 四级标题 五级标题 六级标题 无序列表 有序 ...
- 性能测试之JVM的故障排查-堆内存泄漏
JVM异常说明(超链接) 一文中已介绍了,JVM每个运行时区域--程序计数器 .Java虚拟机栈.本地方法栈.Java堆.方法区.直接内存发生OutOfMemoryError的不同原因和不同错误信息. ...
- elastic后台运行
nohup./bin/elasticsearch&
- vue+uni-app商城实战 | 第一篇:【有来小店】微信小程序快速开发接入Spring Cloud OAuth2认证中心完成授权登录
一. 前言 本篇通过实战来讲述如何使用uni-app快速进行商城微信小程序的开发以及小程序如何接入后台Spring Cloud微服务. 有来商城 youlai-mall 项目是一套全栈商城系统,技术栈 ...
- java安全编码指南之:文件IO操作
目录 简介 创建文件的时候指定合适的权限 注意检查文件操作的返回值 删除使用过后的临时文件 释放不再被使用的资源 注意Buffer的安全性 注意 Process 的标准输入输出 InputStream ...