
hive之基本架构
什么是Hive
hive是建立在Hadoop体系架构上的一层SQL抽象,使得数据相关人员是用他们最为熟悉的SQL语言就可以进行海量的数据的处理、分析和统计工作,而不是必须掌握JAVA等变成语言和具备开发MapReduce程序的能力。Hive SQL实际上是先被SQL解析器进行解析然后被Hive框架解析成一个MapReduce可执行的计划,并且按照该计划生成MapReduce任务后交给Hadoop集群处理。
由于Hive SQL 是翻译为MapReduce任务后在Hadoop集群执行的,而Hadoop是一个批处理系统,所以Hive SQL是高延迟的,不但翻译成的MapReduce任务执行延迟高,而且任务的提交和处理过程也是非常的耗时。因此,Hive即使处理的数据量非常的小,在执行的过程中也会有一定的延迟现象。同时,Hive不能提供数据排序和查询缓存功能,也不提供在线事务处理,更不提供实时查询和记录的更新,因为HIVE本身被定义为处理大规模的离线数据集。如果需要实现实时查询或记录的更新,HBASE是一个不错的选择。
HIVE的基本架构
作为Hadoop的主要数据仓库解决方案,底层存储依赖于HDFS,而Hive SQL是主要交互接口,而真正的计算和执行则由MapReduce完成,它们之间的桥梁是Hive引擎。接下来,具体看下HIVE的引擎架构:
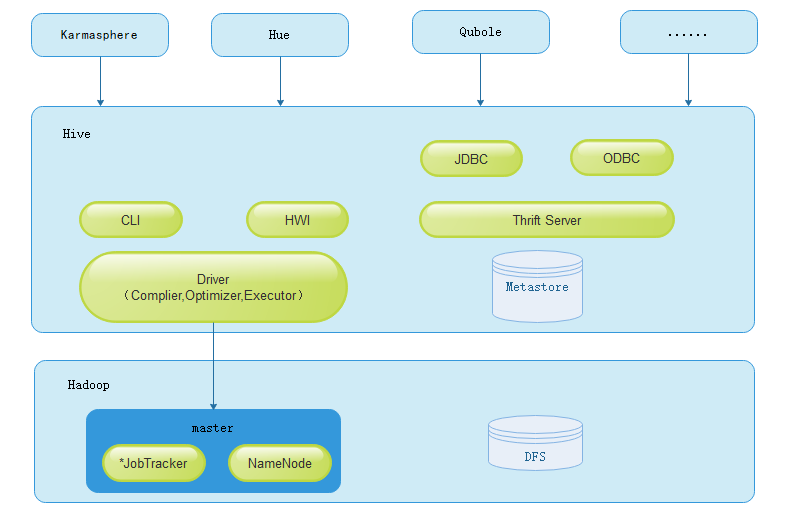
Hive的主要组件包括UI组件、Driver组件(Complier、Optimizer和Executor)、Metastore组件、CLI(Command Line Interface,命令行接口)、JDBC/ODBC、Thrift Server和Hive Web Interface(HWI)等。,接下来分别对这几个组件进行介绍。
- Drvier组件
该组件是Hive的核心组件,该组件包括Complier(编译器)、Optimizer(优化器)和Executor(执行器),它们的作用是对Hive SQL语句进行解析、编译优化、生成执行计划,然后调用底层MR计算框架。
- MetaStore组件
该组件是Hive用来负责管理元数据的组件。Hive的元数据存储在关系型数据库中,其支持的关系型数据库有Derby和mysql,其中Derby是Hive默认情况下使用的数据库,它内嵌在Hive中,但是该数据库只支持单会话,也就是说只允许一个会话链接,所以在生产中并不适用,其实其实在平时我们的测试环境中也很少使用。在我们日常的团队开发中,需要支持多会话,所以需要一个独立的元数据库,用的最多的也就是Mysql,而且Hive内部对Mysql提供了很好的支持。
- CLI
Hive的命令行接口
- Thrift Server
该组件提供JDBC和ODBC接入的能力,用来进行可扩展且跨语言的服务开发。Hive集成了该服务,能让不同的编程语言调用Hive的接口
- Hive Web Interface
该组件是Hive客户端提供的一种通过网页方式访问Hive所提供的服务。这个接口对应Hive的HWI组件
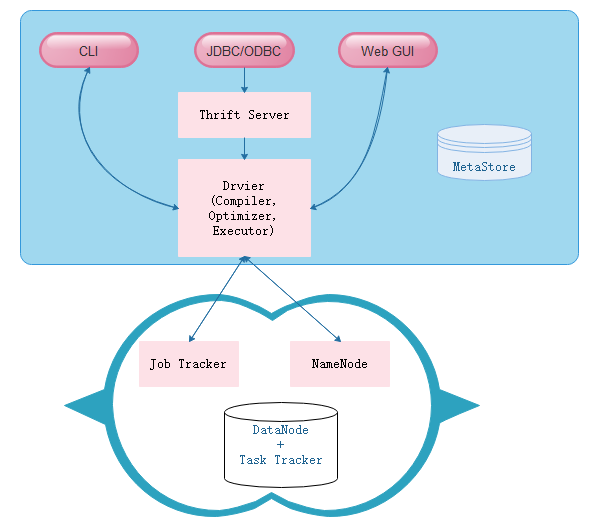
Hive通过CLI,JDBC/ODBC或HWI接受相关的Hive SQL查询,并通过Driver组件进行编译,分析优化,最后编程可执行的MapReduce任务,但是具体里面是怎么执行的,看图:
hive之基本架构的更多相关文章
- hive的体系架构及安装
1,什么是Hive? Hive是能够用类SQL的方式操作HDFS里面数据一个数据仓库的框架,这个类SQL我们称之为HQL(Hive Query Language) 2,什么是数据仓库? 存放数据的地方 ...
- hive介绍及架构设计
hive介绍及架构设计 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 我们知道MapReduce和Spark它们提供了高度抽象的编程接口便于用户编写分布式程序,它们具有极好的扩展性 ...
- Hive的配置| 架构原理
Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张表,并提供类SQL查询功能. 本质是:将HQL转化成MapReduce程序 1)Hive处理的数据存储在HDFS 2)Hi ...
- hive基础及系统架构
1.hive是什么 hive是建立在hadoop上的数据仓库,提供数据的提取.转化和加载. 2.hive的数据存储 1]hive的数据存储基于hdfs 2]存储结构主要包括:数据库.文件.表.索引.视 ...
- 【hive】——Hive初始了解
1.没有接触,不知道这个事物是什么,所以不会产生任何问题.2.接触了,但是不知道他是什么,反正我每天都在用.3.有一定的了解,不够透彻.那么hive,1.我们对它了解多少?2.它到底是什么?3.hiv ...
- hive 搭建
Hive hive是简历再hadoop上的数据库仓库基础架构,它提供了一系列的工具,可以用来进行数据提取转化加载(ETL),这是一种可以存储,查询和分析存储再hadoop种的大规模数据机制,hive定 ...
- 基于hadoop的数据仓库工具:Hive概述
Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供完整的sql查询功能,可以将sql语句转换为MapReduce任务进行运行.其优点是学习成本低,可以通过类 ...
- Hive技术文档
Hive是什么? Hive是蜂房的意思,为什么hadoop上的这层数据仓库叫Hive? 因为生物学上蜂房是一个结构相当精良的建筑,取名Hive足见则个数据仓库在数据存储上也是堪称精良的.Hive是Fa ...
- 大数据时代的技术hive:hive介绍
我最近研究了hive的相关技术,有点心得,这里和大家分享下. 首先我们要知道hive到底是做什么的.下面这几段文字很好的描述了hive的特性: 1.hive是基于Hadoop的一个数据仓库工具,可以将 ...
随机推荐
- Session的load和get方法区别是什么?
①如果没有找到符合条件的记录,get方法返回null值,而load方法会抛出异常: ②get方法直接返回实体类对象,load方法返回实体类对象的代理: ③在Hibernate3之前,get方法只在一级 ...
- Elasticsearch 分布式文档存储
shard = hash(routing) % number_of_primary_shards决定文档在哪个分片上,routing 是一个可变值,默认是文档的 _id ,也可以设置成一个自定义的值. ...
- 转载 Struts2的配置 struts.xml Action详解
在学习struts的时候,我们一定要掌握struts2的工作原理.只有当我们明确了在struts2框架的内部架构的实现过程,在配置整个struts 的框架时,可以很好的进行逻辑上的配置.接下来我就先简 ...
- Yum与RPM
Yum(全称为 Yellow dog Updater, Modified)是一个在Fedora和RedHat以及CentOS中的Shell前端软件包管理器.基于RPM包管理,能够从指定的服务器自动下载 ...
- 手写Spring事务框架
Spring事务基于AOP环绕通知和异常通知 编程事务 声明事务 Spring事务底层使用编程事务+AOP进行包装的 = 声明事务 AOP应用场景: 事务 权限 参数验证 什么是AOP技术 AO ...
- spring无法接收上传文件
现象 前端用ajax方式提交表单,代码类似于下面的例子. var formData = new FormData(); // HTML 文件类型input,由用户选择 formData.append( ...
- shell 提取文件的某行,并在行尾添加字符
sed -n '100,200p' file.txt #提取文件file.txt第100行到第200行的内容 sed 's/$/test/' file.txt #在行尾添加字符串test,$代表行尾
- shell 根据路径获取文件名和目录
path=/dir1/dir2/dir3/test.txt echo ${path##*/} 获取文件名 test.txtecho ${path##*.} 获取后缀 txt #不带后缀的文件名temp ...
- JavaScript设计模式小抄集(持续更新)
前言 本文旨在记录JavaScript中常用的设计模式代码片段,简要说明使用场景,不过于追究细节.在设计模式开篇之前,还是先要搞清楚JavaScript中关于面向对象的基础知识,可以先看看JavaSc ...
- Database基础(七):部署集群基础环境、MySQL-MMM架构部署、MySQL-MMM架构使用
一.部署集群基础环境 目标: 本案例要求为MySQL集群准备基础环境,完成以下任务操作: 数据库授权 部署MySQL双主多从结构 配置本机hosts解析记录 方案: 使用4台RHEL 6虚拟机,如下图 ...