
行人重识别(ReID) ——基于Person_reID_baseline_pytorch修改业务流程
下载Person_reID_baseline_pytorch地址:https://github.com/layumi/Person_reID_baseline_pytorch/tree/master/tutorial
下载Market1501数据集:http://www.liangzheng.org/Project/project_reid.html
Market1501数据集结构:
├── Market/

│   ├── bounding_box_test/          /* Files for testing (candidate images pool)

│   ├── bounding_box_train/         /* Files for training

│   ├── gt_bbox/                    /* We do not use it

│   ├── gt_query/                   /* Files for multiple query testing

│   ├── query/                      /* Files for testing (query images)

│   ├── readme.txt
修改--test_dir路径,执行python prepare.py之后的数据集结构:
├── Market/

│   ├── bounding_box_test/          /* Files for testing (candidate images pool)

│   ├── bounding_box_train/         /* Files for training

│   ├── gt_bbox/                    /* We do not use it

│   ├── gt_query/                   /* Files for multiple query testing

│   ├── query/                      /* Files for testing (query images)

│   ├── readme.txt

│   ├── pytorch/

│       ├── train/                   /* train

│           ├── 0002

|           ├── 0007

|           ...

│       ├── val/                     /* val

│       ├── train_all/               /* train+val

│       ├── query/                   /* query files

│       ├── gallery/                 /* gallery files
训练模型并测试,修改train.py、test.py中的--test_dir路径/home/hylink/eclipse-workspace/reID/Market/pytorch:
python train.py

python test.py

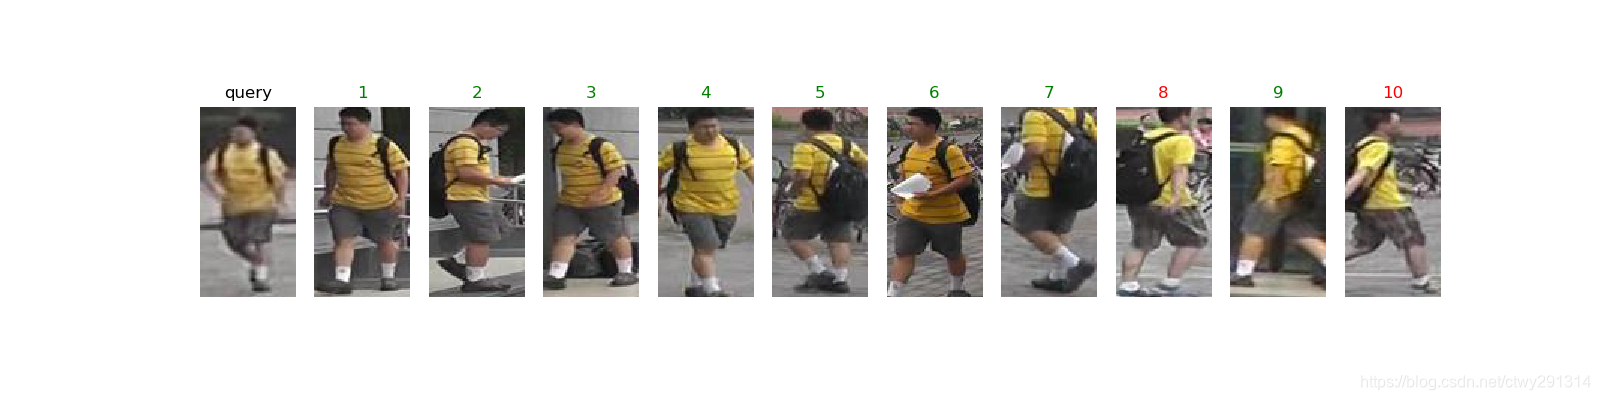
python demo.py --query_index 777
效果展示:
修改test.py(将原gallery和query生成底库,改为只生成gallery底库)
# -*- coding: utf-8 -*-

from __future__ import print_function, division

import argparse

import torch

import torch.nn as nn

import torch.optim as optim

from torch.optim import lr_scheduler

from torch.autograd import Variable

import numpy as np

import torchvision

from torchvision import datasets, models, transforms

import time

import os

import scipy.io

from model import ft_net, ft_net_dense, PCB, PCB_test

######################################################################

# Options

# --------

parser = argparse.ArgumentParser(description='Training')

parser.add_argument('--gpu_ids',default='0', type=str,help='gpu_ids: e.g. 0  0,1,2  0,2')

parser.add_argument('--which_epoch',default='last', type=str, help='0,1,2,3...or last')

parser.add_argument('--test_dir',default='/home/hylink/eclipse-workspace/reID/Market/pytorch',type=str, help='./test_data')

parser.add_argument('--name', default='ft_ResNet50', type=str, help='save model path')

parser.add_argument('--batchsize', default=32, type=int, help='batchsize')

parser.add_argument('--use_dense', action='store_true', help='use densenet121' )

parser.add_argument('--PCB', action='store_true', help='use PCB' )

parser.add_argument('--multi', action='store_true', help='use multiple query' )

opt = parser.parse_args()

str_ids = opt.gpu_ids.split(',')

#which_epoch = opt.which_epoch

name = opt.name

test_dir = opt.test_dir

gpu_ids = []

for str_id in str_ids:

    id = int(str_id)

    if id >=0:

        gpu_ids.append(id)

# set gpu ids

if len(gpu_ids)>0:

    torch.cuda.set_device(gpu_ids[0])

######################################################################

# Load Data

# ---------

#

# We will use torchvision and torch.utils.data packages for loading the

# data.

#

data_transforms = transforms.Compose([

        transforms.Resize((288,144), interpolation=3),

        transforms.ToTensor(),

        transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])

############### Ten Crop

        #transforms.TenCrop(224),

        #transforms.Lambda(lambda crops: torch.stack(

         #   [transforms.ToTensor()(crop)

          #      for crop in crops]

           # )),

        #transforms.Lambda(lambda crops: torch.stack(

         #   [transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])(crop)

          #       for crop in crops]

          # ))

])

if opt.PCB:

    data_transforms = transforms.Compose([

        transforms.Resize((384,192), interpolation=3),

        transforms.ToTensor(),

        transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])

    ])

data_dir = test_dir

if opt.multi:

    image_datasets = {x: datasets.ImageFolder( os.path.join(data_dir,x) ,data_transforms) for x in ['gallery','query','multi-query']}

    dataloaders = {x: torch.utils.data.DataLoader(image_datasets[x], batch_size=opt.batchsize,

                                             shuffle=False, num_workers=16) for x in ['gallery','query','multi-query']}

else:

    image_datasets = {x: datasets.ImageFolder( os.path.join(data_dir,x) ,data_transforms) for x in ['gallery']}

    dataloaders = {x: torch.utils.data.DataLoader(image_datasets[x], batch_size=opt.batchsize,

                                             shuffle=False, num_workers=16) for x in ['gallery']}

#class_names = image_datasets['query'].classes

use_gpu = torch.cuda.is_available()

######################################################################

# Load model

#---------------------------

def load_network(network):

    save_path = os.path.join('./model',name,'net_%s.pth'%opt.which_epoch)

    network.load_state_dict(torch.load(save_path))

    return network

######################################################################

# Extract feature

# ----------------------

#

# Extract feature from  a trained model.

#

def fliplr(img):

    '''flip horizontal'''

    inv_idx = torch.arange(img.size(3)-1,-1,-1).long()  # N x C x H x W

    img_flip = img.index_select(3,inv_idx)

    return img_flip

def extract_feature(model,dataloaders):

    features = torch.FloatTensor()

    count = 0

    for data in dataloaders:

        img, label = data

        n, c, h, w = img.size()

        count += n

        print(count)

        if opt.use_dense:

            ff = torch.FloatTensor(n,1024).zero_()

        else:

            ff = torch.FloatTensor(n,2048).zero_()

        if opt.PCB:

            ff = torch.FloatTensor(n,2048,6).zero_() # we have six parts

        for i in range(2):

            if(i==1):

                img = fliplr(img)

            input_img = Variable(img.cuda())

            outputs = model(input_img)

            f = outputs.data.cpu()

            ff = ff+f

        # norm feature

        if opt.PCB:

            # feature size (n,2048,6)

            # 1. To treat every part equally, I calculate the norm for every 2048-dim part feature.

            # 2. To keep the cosine score==1, sqrt(6) is added to norm the whole feature (2048*6).

            fnorm = torch.norm(ff, p=2, dim=1, keepdim=True) * np.sqrt(6)

            ff = ff.div(fnorm.expand_as(ff))

            ff = ff.view(ff.size(0), -1)

        else:

            fnorm = torch.norm(ff, p=2, dim=1, keepdim=True)

            ff = ff.div(fnorm.expand_as(ff))

        features = torch.cat((features,ff), 0)

    return features

def get_id(img_path):

    camera_id = []

    labels = []

    for path, v in img_path:

        #filename = path.split('/')[-1]

        filename = os.path.basename(path)

        label = filename[0:4]

        camera = filename.split('c')[1]

        if label[0:2]=='-1':

            labels.append(-1)

        else:

            labels.append(int(label))

        camera_id.append(int(camera[0]))

    return camera_id, labels

gallery_path = image_datasets['gallery'].imgs

#query_path = image_datasets['query'].imgs

gallery_cam,gallery_label = get_id(gallery_path)

#query_cam,query_label = get_id(query_path)

if opt.multi:

    mquery_path = image_datasets['multi-query'].imgs

    mquery_cam,mquery_label = get_id(mquery_path)

######################################################################

# Load Collected data Trained model

print('-------test-----------')

if opt.use_dense:

    model_structure = ft_net_dense(751)

else:

    model_structure = ft_net(751)

if opt.PCB:

    model_structure = PCB(751)

model = load_network(model_structure)

# Remove the final fc layer and classifier layer

if not opt.PCB:

    model.model.fc = nn.Sequential()

    model.classifier = nn.Sequential()

else:

    model = PCB_test(model)

# Change to test mode

model = model.eval()

if use_gpu:

    model = model.cuda()

# Extract feature

gallery_feature = extract_feature(model,dataloaders['gallery'])

#query_feature = extract_feature(model,dataloaders['query'])

if opt.multi:

    mquery_feature = extract_feature(model,dataloaders['multi-query'])

# Save to Matlab for check

#result = {'gallery_f':gallery_feature.numpy(),'gallery_label':gallery_label,'gallery_cam':gallery_cam,'query_f':query_feature.numpy(),'query_label':query_label,'query_cam':query_cam}

result = {'gallery_f':gallery_feature.numpy(),'gallery_label':gallery_label,'gallery_cam':gallery_cam}

scipy.io.savemat('pytorch_result.mat',result)

if opt.multi:

    result = {'mquery_f':mquery_feature.numpy(),'mquery_label':mquery_label,'mquery_cam':mquery_cam}

    scipy.io.savemat('multi_query.mat',result)
修改demo.py(将query路径下的图片生成特征并于gallery底库进行比对并展示)
# -*- coding: utf-8 -*-

from __future__ import print_function, division

import argparse

import torch

import torch.nn as nn

import torch.optim as optim

from torch.optim import lr_scheduler

from torch.autograd import Variable

import numpy as np

import torchvision

from torchvision import datasets, models, transforms

import time

import os

import scipy.io

import matplotlib.pyplot as plt

from model import ft_net, ft_net_dense, PCB, PCB_test

######################################################################

# Options

# --------

parser = argparse.ArgumentParser(description='Training')

parser.add_argument('--gpu_ids',default='0', type=str,help='gpu_ids: e.g. 0  0,1,2  0,2')

parser.add_argument('--which_epoch',default='last', type=str, help='0,1,2,3...or last')

parser.add_argument('--test_dir',default='/home/hylink/eclipse-workspace/reID/Market/pytorch',type=str, help='./test_data')

parser.add_argument('--name', default='ft_ResNet50', type=str, help='save model path')

parser.add_argument('--batchsize', default=32, type=int, help='batchsize')

parser.add_argument('--use_dense', action='store_true', help='use densenet121' )

parser.add_argument('--PCB', action='store_true', help='use PCB' )

parser.add_argument('--multi', action='store_true', help='use multiple query' )

parser.add_argument('--query_index', default=3, type=int, help='test_image_index')

opt = parser.parse_args()

str_ids = opt.gpu_ids.split(',')

#which_epoch = opt.which_epoch

name = opt.name

test_dir = opt.test_dir

gpu_ids = []

for str_id in str_ids:

    id = int(str_id)

    if id >=0:

        gpu_ids.append(id)

# set gpu ids

if len(gpu_ids)>0:

    torch.cuda.set_device(gpu_ids[0])

######################################################################

# Load Data

# ---------

#

# We will use torchvision and torch.utils.data packages for loading the

# data.

#

data_transforms = transforms.Compose([

        transforms.Resize((288,144), interpolation=3),

        transforms.ToTensor(),

        transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])

############### Ten Crop

        #transforms.TenCrop(224),

        #transforms.Lambda(lambda crops: torch.stack(

         #   [transforms.ToTensor()(crop)

          #      for crop in crops]

           # )),

        #transforms.Lambda(lambda crops: torch.stack(

         #   [transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])(crop)

          #       for crop in crops]

          # ))

])

if opt.PCB:

    data_transforms = transforms.Compose([

        transforms.Resize((384,192), interpolation=3),

        transforms.ToTensor(),

        transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])

    ])

data_dir = test_dir

if opt.multi:

    image_datasets = {x: datasets.ImageFolder( os.path.join(data_dir,x) ,data_transforms) for x in ['gallery','query','multi-query']}

    dataloaders = {x: torch.utils.data.DataLoader(image_datasets[x], batch_size=opt.batchsize,

                                             shuffle=False, num_workers=16) for x in ['gallery','query','multi-query']}

else:

    image_datasets = {x: datasets.ImageFolder( os.path.join(data_dir,x) ,data_transforms) for x in ['gallery','query']}

    dataloaders = {x: torch.utils.data.DataLoader(image_datasets[x], batch_size=opt.batchsize,

                                             shuffle=False, num_workers=16) for x in ['gallery','query']}

class_names = image_datasets['query'].classes

use_gpu = torch.cuda.is_available()

######################################################################

# Load model

#---------------------------

def load_network(network):

    save_path = os.path.join('./model',name,'net_%s.pth'%opt.which_epoch)

    network.load_state_dict(torch.load(save_path))

    return network

######################################################################

# Extract feature

# ----------------------

#

# Extract feature from  a trained model.

#

def fliplr(img):

    '''flip horizontal'''

    inv_idx = torch.arange(img.size(3)-1,-1,-1).long()  # N x C x H x W

    img_flip = img.index_select(3,inv_idx)

    return img_flip

def extract_feature(model,dataloaders):

    features = torch.FloatTensor()

    count = 0

    for data in dataloaders:

        img, label = data

        n, c, h, w = img.size()

        count += n

        print(count)

        if opt.use_dense:

            ff = torch.FloatTensor(n,1024).zero_()

        else:

            ff = torch.FloatTensor(n,2048).zero_()

        if opt.PCB:

            ff = torch.FloatTensor(n,2048,6).zero_() # we have six parts

        for i in range(2):

            if(i==1):

                img = fliplr(img)

            input_img = Variable(img.cuda())

            outputs = model(input_img)

            f = outputs.data.cpu()

            ff = ff+f

        # norm feature

        if opt.PCB:

            # feature size (n,2048,6)

            # 1. To treat every part equally, I calculate the norm for every 2048-dim part feature.

            # 2. To keep the cosine score==1, sqrt(6) is added to norm the whole feature (2048*6).

            fnorm = torch.norm(ff, p=2, dim=1, keepdim=True) * np.sqrt(6)

            ff = ff.div(fnorm.expand_as(ff))

            ff = ff.view(ff.size(0), -1)

        else:

            fnorm = torch.norm(ff, p=2, dim=1, keepdim=True)

            ff = ff.div(fnorm.expand_as(ff))

        features = torch.cat((features,ff), 0)

    return features

def get_id(img_path):

    camera_id = []

    labels = []

    for path, v in img_path:

        #filename = path.split('/')[-1]

        filename = os.path.basename(path)

        label = filename[0:4]

        camera = filename.split('c')[1]

        if label[0:2]=='-1':

            labels.append(-1)

        else:

            labels.append(int(label))

        camera_id.append(int(camera[0]))

    return camera_id, labels

query_path = image_datasets['query'].imgs

query_cam,query_label = get_id(query_path)

if opt.multi:

    mquery_path = image_datasets['multi-query'].imgs

    mquery_cam,mquery_label = get_id(mquery_path)

######################################################################

# Load Collected data Trained model

print('-------test-----------')

if opt.use_dense:

    model_structure = ft_net_dense(751)

else:

    model_structure = ft_net(751)

if opt.PCB:

    model_structure = PCB(751)

model = load_network(model_structure)

# Remove the final fc layer and classifier layer

if not opt.PCB:

    model.model.fc = nn.Sequential()

    model.classifier = nn.Sequential()

else:

    model = PCB_test(model)

# Change to test mode

model = model.eval()

if use_gpu:

    model = model.cuda()

# Extract feature

query_feature = extract_feature(model,dataloaders['query'])

######################################################################

######################################################################

def imshow(path, title=None):

    """Imshow for Tensor."""

    im = plt.imread(path)

    plt.imshow(im)

    if title is not None:

        plt.title(title)

    plt.pause(0.001)  # pause a bit so that plots are updated

######################################################################

result = scipy.io.loadmat('pytorch_result.mat')

gallery_feature = torch.FloatTensor(result['gallery_f'])

gallery_cam = result['gallery_cam'][0]

gallery_label = result['gallery_label'][0]

query_feature = query_feature.cuda()

gallery_feature = gallery_feature.cuda()

#######################################################################

# sort the images

def sort_img(qf, ql, qc, gf, gl, gc):

    query = qf.view(-1,1)

    # print(query.shape)

    score = torch.mm(gf,query)

    score = score.squeeze(1).cpu()

    score = score.numpy()

    # predict index

    index = np.argsort(score)  #from small to large

    index = index[::-1]

    # index = index[0:2000]

    # good index

    query_index = np.argwhere(gl==ql)

    #same camera

    camera_index = np.argwhere(gc==qc)

    junk_index1 = np.argwhere(gl==-1)

    junk_index2 = np.intersect1d(query_index, camera_index)

    junk_index = np.append(junk_index2, junk_index1)

    mask = np.in1d(index, junk_index, invert=True)

    index = index[mask]

    return index

i = opt.query_index

index = sort_img(query_feature[i],query_label[i],query_cam[i],gallery_feature,gallery_label,gallery_cam)

########################################################################

# Visualize the rank result

query_path, _ = image_datasets['query'].imgs[i]

query_label = query_label[i]

print(query_path)

print('Top 10 images are as follow:')

try: # Visualize Ranking Result

    # Graphical User Interface is needed

    fig = plt.figure(figsize=(16,4))

    ax = plt.subplot(1,11,1)

    ax.axis('off')

    imshow(query_path,'query')

    for i in range(10):

        ax = plt.subplot(1,11,i+2)

        ax.axis('off')

        img_path, _ = image_datasets['gallery'].imgs[index[i]]

        label = gallery_label[index[i]]

        imshow(img_path)

        if label == query_label:

            ax.set_title('%d'%(i+1), color='green')

        else:

            ax.set_title('%d'%(i+1), color='red')

        print(img_path)

except RuntimeError:

    for i in range(10):

        img_path = image_datasets.imgs[index[i]]

        print(img_path[0])

    print('If you want to see the visualization of the ranking result, graphical user interface is needed.')

fig.savefig("show.png")
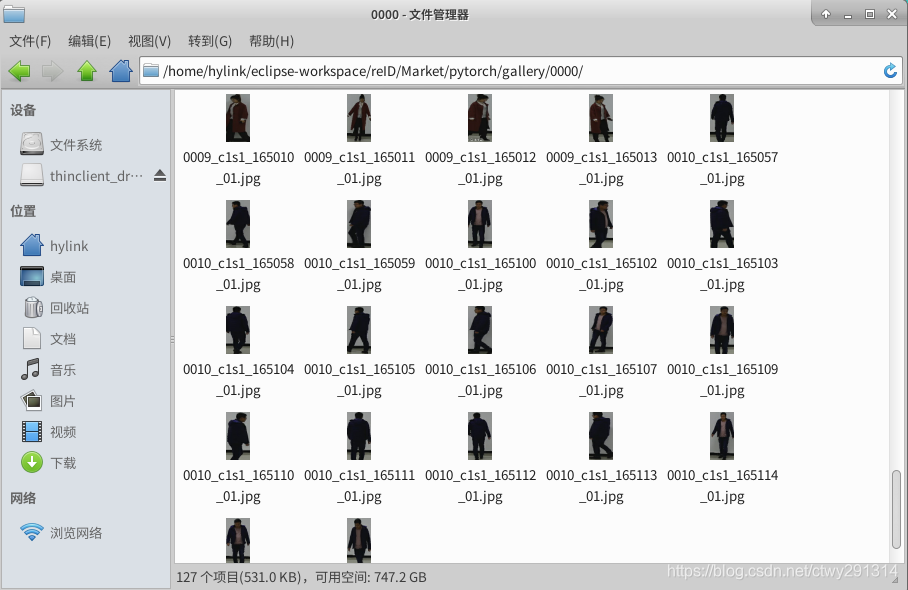
自定义底库放置在pytorch/gallery/
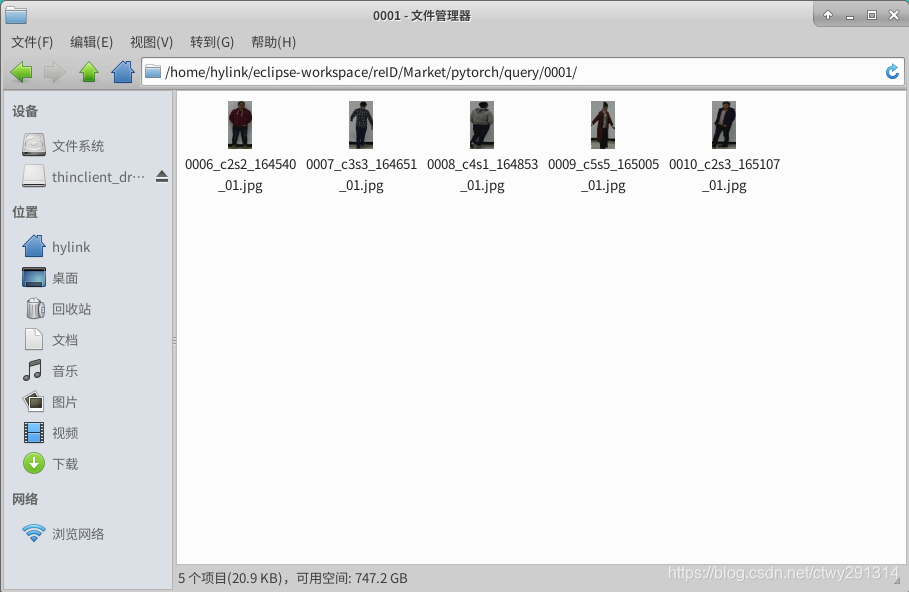
自定义查询库放置在pytorch/query/
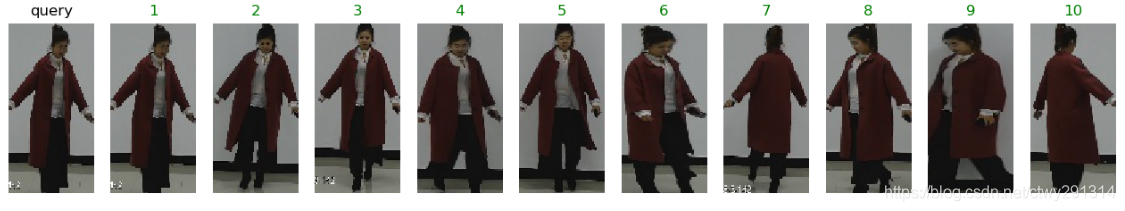
效果展示
行人重识别(ReID) ——基于Person_reID_baseline_pytorch修改业务流程的更多相关文章
- 行人重识别(ReID) ——基于深度学习的行人重识别研究综述
转自:https://zhuanlan.zhihu.com/p/31921944 前言:行人重识别(Person Re-identification)也称行人再识别,本文简称为ReID,是利用计算机视 ...
- 行人重识别(ReID) ——基于MGN-pytorch进行可视化展示
下载MGN-pytorch:https://github.com/seathiefwang/MGN-pytorch 下载Market1501数据集:http://www.liangzheng.org/ ...
- 行人重识别(ReID) ——技术实现及应用场景
导读 跨镜追踪(Person Re-Identification,简称 ReID)技术是现在计算机视觉研究的热门方向,主要解决跨摄像头跨场景下行人的识别与检索.该技术能够根据行人的穿着.体态.发型等信 ...
- 行人重识别(ReID) ——数据集描述 DukeMTMC-reID
数据集简介 DukeMTMC 数据集是一个大规模标记的多目标多摄像机行人跟踪数据集.它提供了一个由 8 个同步摄像机记录的新型大型高清视频数据集,具有 7,000 多个单摄像机轨迹和超过 2,700 ...
- 行人重识别(ReID) ——数据集描述 Market-1501
数据集简介 Market-1501 数据集在清华大学校园中采集,夏天拍摄,在 2015 年构建并公开.它包括由6个摄像头(其中5个高清摄像头和1个低清摄像头)拍摄到的 1501 个行人.32668 个 ...
- 行人重识别(ReID) ——概述
什么是Re-ID? 行人重识别(Person re-identification,简称Re-ID)也称行人再识别,是利用计算机视觉技术判断图像或者视频序列中是否存在特定行人的技术.广泛被认为是一个图像 ...
- 行人重识别(ReID) ——数据集描述 CUHK03
数据集简介 CUHK03是第一个足以进行深度学习的大规模行人重识别数据集,该数据集的图像采集于香港中文大学(CUHK)校园.数据以"cuhk-03.mat"的 MAT 文件格式存储 ...
- CVPR2020行人重识别算法论文解读
CVPR2020行人重识别算法论文解读 Cross-modalityPersonre-identificationwithShared-SpecificFeatureTransfer 具有特定共享特征变换 ...
- 行人重识别和车辆重识别(ReID)中的评测指标——mAP和Rank-k
1.mAP mAP的全称是mean Average Precision,意为平均精度均值(如果按照原来的顺利翻译就是平均均值精度).这个指标是多目标检测和多标签图像分类中长常用的评测指标,因为这类任务 ...
随机推荐
- 代理修饰词weak/assign/strong的区别
基于项目报错: WebViewJavascriptBridgeBase 中定义:@property (assign) id <WebViewJavascriptBridgeBaseDelegat ...
- SQL SERVER 数据库如何限制一列不能重复(已经有主键)
ALTER TABLE 表名ADDCONSTRAINT 约束名 UNIQUE (列名) -------------------------------------------------------- ...
- Bugku web web2
web2 打开后发现是个大滑稽啊!F12检查元素拿到flag
- 进阶1:Linux 环境准备_ 设置网络IP_安装火狐浏览器
VM 已安装 centos6.5 Final 已安装 配置好了Linux IP ,并能ping 通 ,例如 : ping www.baidu.com 设置LINUX 网络IP: https://j ...
- 力扣60——第k个排列
原题 给出集合 [1,2,3,-,n],其所有元素共有 n! 种排列. 按大小顺序列出所有排列情况,并一一标记,当 n = 3 时, 所有排列如下: 1. "123" 2. &qu ...
- h5视频标签 video
video标签,用来播放视频的 基本上所有的浏览器都支持 video支持的视频格式有: mp4 mime-type: video/mp4 WebM mime-type: video/WebM Ogg ...
- java创建对象方法列表
引用 不用构造方法也能创建对象 前言 java中对象创建的方法主要包括,1,使用new关键字,2.使用clone方法,3.反射机制,4.反序列化.其中1,3都会明确的显式的调用构造函数.2是在内存上对 ...
- 软件-工具:Beyond Compare
ylbtech-软件-工具:Beyond Compare 1.返回顶部 1. Beyond Compare是一套由Scooter Software推出的文件比较工具.主要用途是对比两个文件夹或者文件, ...
- POI向Excel中写入数据及追加数据
import org.apache.poi.xssf.usermodel.XSSFCell; import org.apache.poi.xssf.usermodel.XSSFRow; import ...
- VS2008 项目启动时报:“无法直接启动带有类库输出类型的项目”
解决办法一: 右击要解决方案项目--属性-通用属性—单启动项目 解决方法二:直接选中界面类,右击设为启动项目, 如果还是这样,那么在此项目上按右键 (VS2010的资源管理工具中),点属性,更改设置.