
Selenium结合BeautifulSoup4编写简单爬虫
在学会了抓包,接口请求(如requests库)和Selenium的一些操作方法后,基本上就可以编写爬虫,爬取绝大多数网站的内容。
在爬虫领域,Selenium永远是最后一道防线。从本质上来说,访问网页实际上就是一个接口请求。请求url后,返回的是网页的源代码。
我们只需要解析html或者通过正则匹配提取出我们需要的数据即可。
有些网站我们可以使用requests.get(url),得到的响应文本中获取到所有的数据。而有些网页数据是通过JS动态加载到页面中的。使用requests获取不到或者只能获取到一部分数据。
此时我们就可以使用selenium打开页面来,使用driver.page_source来获取JS执行完后的完整源代码。
例如,我们要爬取,diro官网女包的名称,价格,url,图片等数据,可以使用requests先获取到网页源代码:
访问网页,打开开发者工具,我们可以看到所有的商品都在一个
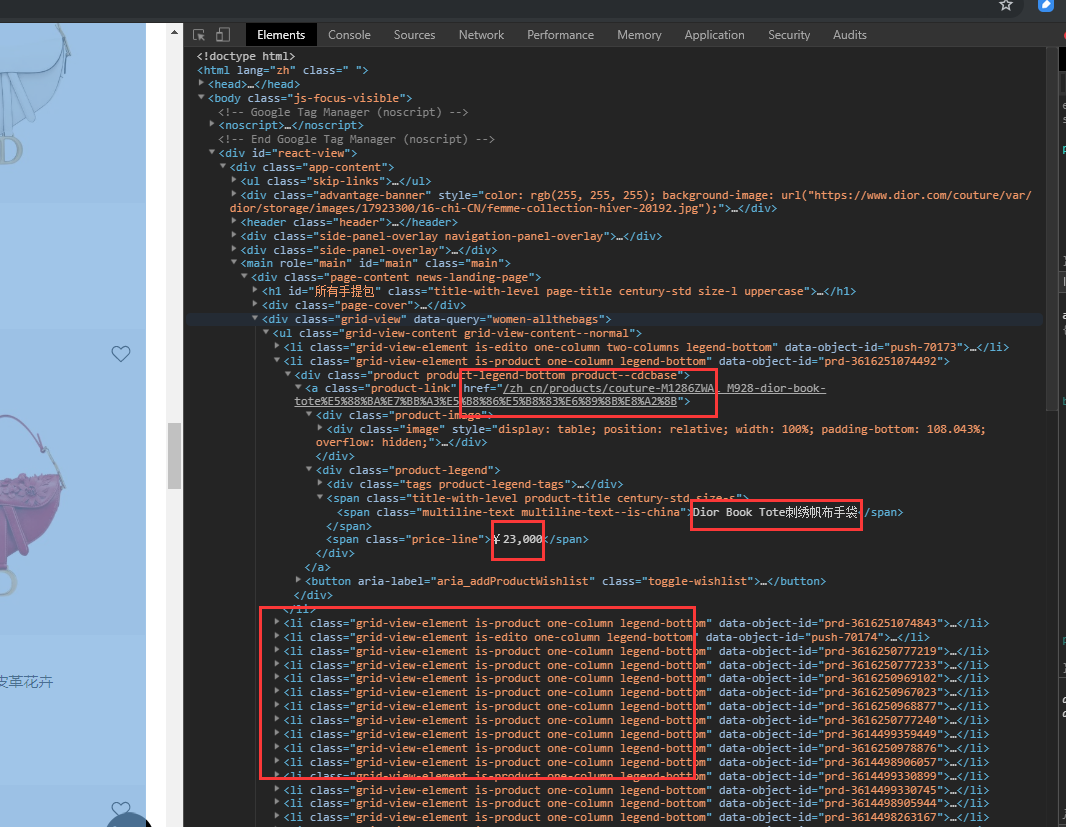
从html格式的源码中提取数据,有多种选择,可以使用xml.etree等等方式,bs4是一个比较方便易用的html解析库,配合lxml解析速度比较快。
bs4的使用方法为
from bs4 import BeautifulSoup

soup = BeautifulSoup(网页源代码字符串,'lxml')

soup.find(...).find(...)

soup.findall()

soup.select('css selector语法')
soup.find()可以通过节点属性进行查找,如,soup.find('div', id='节点id')或soup.find('li', class_='某个类名')或soup.find('标签名', 属性=属性值),当找到一个节点后,还可以使用这个节点继续在其子节点中查找。
soup.find_all()是查找多个,同样属性的节点,返回一个列表。
soup.select()是使用css selector语法查找,返回一个列表。
以下为示例代码:
from selenium import webdriver

from bs4 import BeautifulSoup

driver = webdriver.Chrome()

driver.get('https://www.dior.cn/zh_cn/女士精品/皮具系列/所有手提包')

soup = BeautifulSoup(driver.page_source, 'lxml')

products = soup.select('li.is-product')

for product in products:

    name = product.find('span', class_='product-title').text.strip()

    price = product.find('span', class_='price-line').text.replace('¥', '').replace(',','')

    url = 'https://www.dior.cn' + product.find('a', class_='product-link').attrs['href']

    img = product.find('img').attrs['src']

    sku = img.split('/')[-1]

    print(name, sku, price)

driver.quit()
运行结果,如下图:
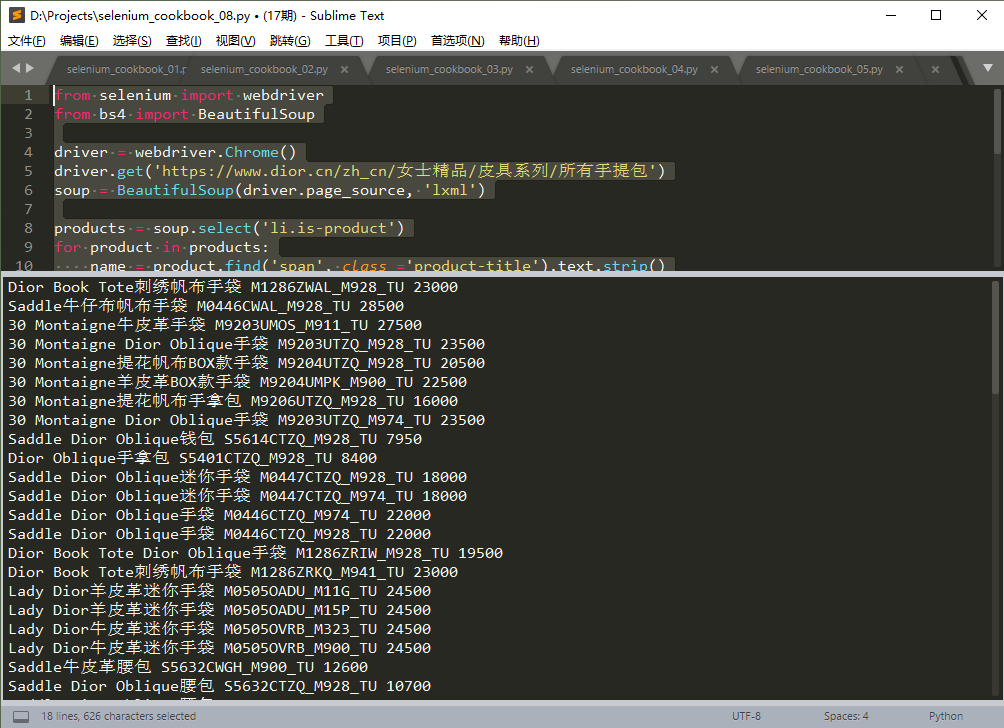
注:本例中,也可以使用requests.get()获取网页源代码,格式和使用selenium加载的稍有不同。
一般简单爬虫编写的步骤为:
- 进入列表页,打开开发者工具,刷新页面及向下滚动,查看新产品加载,是否能抓到XHR数据接口(直接返回JSON格式所有产品数据的接口)
- 如果有这种接口,尝试修改参数中的分页值,和请求总数值,看看是否能从一个接口返回所有的商品数据
- 如果只有Doc类型的接口返回页面,尝试使用requests.get()请求页面,分析响应文本,是否包含所有商品数据
- 如果requests获取不到商品数据或数据不全可以使用selenium加载页面,然后使用bs4解析提取,如果有多个页面,循环逐个操作即可。
Selenium结合BeautifulSoup4编写简单爬虫的更多相关文章
- 用python编写简单爬虫
需求:抓取百度百科python词条相关词条网页的标题和简介,并将数据输出在一个html表格中 入口页:python的百度词条页 https://baike.baidu.com/item/Python/ ...
- Python 利用Python编写简单网络爬虫实例3
利用Python编写简单网络爬虫实例3 by:授客 QQ:1033553122 实验环境 python版本:3.3.5(2.7下报错 实验目的 获取目标网站“http://bbs.51testing. ...
- Python 利用Python编写简单网络爬虫实例2
利用Python编写简单网络爬虫实例2 by:授客 QQ:1033553122 实验环境 python版本:3.3.5(2.7下报错 实验目的 获取目标网站“http://www.51testing. ...
- 在python3中使用urllib.request编写简单的网络爬虫
转自:http://www.cnblogs.com/ArsenalfanInECNU/p/4780883.html Python官方提供了用于编写网络爬虫的包 urllib.request, 我们主要 ...
- Python开发简单爬虫
简单爬虫框架: 爬虫调度器 -> URL管理器 -> 网页下载器(urllib2) -> 网页解析器(BeautifulSoup) -> 价值数据 Demo1: # codin ...
- python3实现简单爬虫功能
本文参考虫师python2实现简单爬虫功能,并增加自己的感悟. #coding=utf-8 import re import urllib.request def getHtml(url): page ...
- Python开发简单爬虫 - 慕课网
课程链接:Python开发简单爬虫 环境搭建: Eclipse+PyDev配置搭建Python开发环境 Python入门基础教程 用Eclipse编写Python程序 课程目录 第1章 课程介绍 ...
- Python开发简单爬虫(一)
一 .简单爬虫架构: 爬虫调度端:启动爬虫,停止爬虫,监视爬虫运行情况 URL管理器:对将要爬取的和已经爬取过的URL进行管理:可取出带爬取的URL,将其传送给“网页下载器” 网页下载器:将URL指定 ...
- 用python语言编写网络爬虫
本文主要用到python3自带的urllib模块编写轻量级的简单爬虫.至于怎么定位一个网页中具体元素的url可自行百度火狐浏览器的firebug插件或者谷歌浏览器的自带方法. 1.访问一个网址 re= ...
随机推荐
- 谈jdbcTemplate与mybatis
为什么会产生 Hibernate Mybatis 这类的dao层框架 传统的jdbc 虽然执行速度很快,但是开发效率很低,随着面向对象开发的设计思想,在面向对象编程中 将对象 进行持久化,存入关系型的 ...
- (十四)Hibernate中的多表操作(4):单向一对一
案例一: 注解方式实现一对一 UserBean.java package bean; import java.io.Serializable; import javax.persistence.Col ...
- .netcore 和.netFrameWork
netcore 是一个流程,可以调用,netcore 框架下,选择netFrameWork.可以使用netFrameWork的库,比如画图等.只是管道是netcore的.
- Oracle数据库默认的data pump dir在哪
转自:https://zhidao.baidu.com/question/921271686131558779.html 使用select * from dba_directories;可以查到,例如 ...
- 字符串转json数组
import net.sf.json.JSONArray;import net.sf.json.JSONObject; String content = inBankOdd.getContent(). ...
- bash shell的ANSI控制
格式: echo -e "\033[字背景颜色;字体颜色m字符串\033[0m" 例如: echo -e "\033[41;36m something here \03 ...
- 5.Redis的持久化
Redis中数据的持久化有两种方式:RDB(Redis DataBsse) 和 AOF(Append Only File),默认采取的是RDB方式 RDB 1.是什么:在指定的时间间隔内将内存中的数据 ...
- 常用git指令记录
Generating an SSH key Checking for existing SSH keys Generating a new SSH key and adding it to the s ...
- 搭建nginx文件服务器
一.安装nginx服务 apt install nginx 二.修改nginx配置文件 cd /etc/nginx/conf.d/ vim download_server.conf server { ...
- PropTypes没有定义的问题
今天做项目遇到了一个坑 import React, { Component,PropTypes} from 'react'; console.log(PropTypes); //undefined 用 ...