
Apache Flink - 常见数据流类型
DataStream:
DataStream是 Flink 流处理 API 中最核心的数据结构。它代表了一个运行在多个分区上的并行流。一个DataStream可以从StreamExecutionEnvironment通过env.addSource(SourceFunction)获得。- DataStream 上的转换操作都是逐条的,比如
map(),flatMap(),filter()。DataStream 也可以执行rebalance(再平衡,用来减轻数据倾斜)和broadcaseted(广播)等分区转换。 如上图的执行图所示,DataStream 各个算子会并行运行,算子之间是数据流分区。如 Source 的第一个并行实例(S1)和 flatMap() 的第一个并行实例(m1)之间就是一个数据流分区。而在 flatMap() 和 map() 之间由于加了 rebalance(),它们之间的数据流分区就有3个子分区(m1的数据流向3个map()实例)。
KeyedStream:
KeyedStream用来表示根据指定的key进行分组的数据流。KeyedStream可以通过调用DataStream.keyBy()来获得。而在KeyedStream上进行任何transformation都将转变回DataStream。在实现中,KeyedStream是把key的信息写入到了transformation中。每条记录只能访问所属key的状态,其上的聚合函数可以方便地操作和保存对应key的状态。
WindowedStream & AllWindowedStream:
WindowedStream代表了根据key分组,并且基于WindowAssigner切分窗口的数据流。所以WindowedStream都是从KeyedStream衍生而来的。而在WindowedStream上进行任何transformation也都将转变回DataStream。DataStream[MyType] stream = ...
WindowedDataStream[MyType] windowed = stream
.keyBy("userId")
.window(TumblingEventTimeWindows.of(Time.seconds(5))) // Last 5 seconds of data
DataStream[ResultType] result = windowed.reduce(myReducer)Flink 的窗口实现中会将到达的数据缓存在对应的窗口buffer中(一个数据可能会对应多个窗口)。当到达窗口发送的条件时(由Trigger控制),Flink 会对整个窗口中的数据进行处理。Flink 在聚合类窗口有一定的优化,即不会保存窗口中的所有值,而是每到一个元素执行一次聚合函数,最终只保存一份数据即可。
- 在key分组的流上进行窗口切分是比较常用的场景,也能够很好地并行化(不同的key上的窗口聚合可以分配到不同的task去处理)。不过当我们需要在普通流上进行窗口操作时,就要用到
AllWindowedStream。AllWindowedStream是直接在DataStream上进行windowAll(...)操作。AllWindowedStream 的实现是基于 WindowedStream 的。Flink 不推荐使用AllWindowedStream,因为在普通流上进行窗口操作,就势必需要将所有分区的流都汇集到单个的Task中,而这个单个的Task很显然就会成为整个Job的瓶颈。
JoinedStreams & CoGroupedStreams:
- co-group 侧重的是group,是对同一个key上的两组集合进行操作,而 join 侧重的是pair,是对同一个key上的每对元素进行操作, join 只是 co-group 的一个特例。
- JoinedStreams 和 CoGroupedStreams 是基于 Window 上实现的,所以 CoGroupedStreams 最终又调用了 WindowedStream 来实现。
DataStream[MyType] firstInput = ...

DataStream[AnotherType] secondInput = ...

DataStream[(MyType, AnotherType)] result = firstInput.join(secondInput)

    .where("userId").equalTo("id")

    .window(TumblingEventTimeWindows.of(Time.seconds(3)))

    .apply (new JoinFunction () {...})
双流上的数据在同一个key的会被分别分配到同一个window窗口的左右两个篮子里,当window结束的时候,会对左右篮子进行笛卡尔积从而得到每一对pair,对每一对pair应用 JoinFunction。
ConnectedStreams:
- 在 DataStream 上有一个 union 的转换
dataStream.union(otherStream1, otherStream2, ...),用来合并多个流,新的流会包含所有流中的数据。union 有一个限制,就是所有合并的流的类型必须是一致的。 - union 有一个限制,就是所有合并的流的类型必须是一致的。
ConnectedStreams提供了和 union 类似的功能,用来连接两个流,但是与 union 转换有以下几个区别:- ConnectedStreams 只能连接两个流,而 union 可以连接多个流。
- ConnectedStreams 连接的两个流类型可以不一致,而 union 连接的流的类型必须一致。
- ConnectedStreams 会对两个流的数据应用不同的处理方法,并且双流之间可以共享状态。这在第一个流的输入会影响第二个流时, 会非常有用。
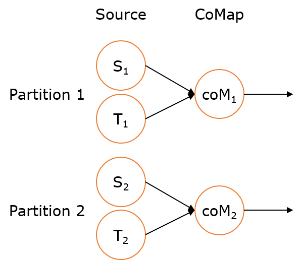
- 如下 ConnectedStreams 的样例,连接
input和other流,并在input流上应用map1方法,在other上应用map2方法,双流可以共享状态(比如计数)。DataStream[MyType] input = ...
DataStream[AnotherType] other = ... ConnectedStreams[MyType, AnotherType] connected = input.connect(other) DataStream[ResultType] result =
connected.map(new CoMapFunction[MyType, AnotherType, ResultType]() {
override def map1(value: MyType): ResultType = { ... }
override def map2(value: AnotherType): ResultType = { ... }
})当并行度为2时:
Apache Flink - 常见数据流类型的更多相关文章
- [Note] Apache Flink 的数据流编程模型
Apache Flink 的数据流编程模型 抽象层次 Flink 为开发流式应用和批式应用设计了不同的抽象层次 状态化的流 抽象层次的最底层是状态化的流,它通过 ProcessFunction 嵌入到 ...
- Apache Flink vs Apache Spark——感觉二者是互相抄袭啊 看谁的好就抄过来 Flink支持在runtime中的有环数据流,这样表示机器学习算法更有效而且更有效率
Apache Flink是什么 Flink是一款新的大数据处理引擎,目标是统一不同来源的数据处理.这个目标看起来和Spark和类似.没错,Flink也在尝试解决 Spark在解决的问题.这两套系统都在 ...
- Apache Flink - 数据流容错机制
Apache Flink提供了一种容错机制,可以持续恢复数据流应用程序的状态.该机制确保即使出现故障,程序的状态最终也会反映来自数据流的每条记录(只有一次). 从容错和消息处理的语义上(at leas ...
- Apache Flink 介绍
原文地址:https://mp.weixin.qq.com/s?__biz=MzU2Njg5Nzk0NQ==&mid=2247483660&idx=1&sn=ecf01cfc8 ...
- 深入理解Apache Flink
Apache Flink(下简称Flink)项目是大数据处理领域最近冉冉升起的一颗新星,其不同于其他大数据项目的诸多特性吸引了越来越多人的关注.本文将深入分析Flink的一些关键技术与特性,希望能够帮 ...
- 深入理解Apache Flink核心技术
深入理解Apache Flink核心技术 2016年02月18日 17:04:03 阅读数:1936 标签: Apache-Flink数据流程序员JVM 版权声明:本文为博主原创文章,未经博主允许 ...
- 《从0到1学习Flink》—— Apache Flink 介绍
前言 Flink 是一种流式计算框架,为什么我会接触到 Flink 呢?因为我目前在负责的是监控平台的告警部分,负责采集到的监控数据会直接往 kafka 里塞,然后告警这边需要从 kafka topi ...
- Apache Flink 入门示例demo
在本文中,我们将从零开始,教您如何构建第一个Apache Flink (以下简称Flink)应用程序. 开发环境准备 Flink 可以运行在 Linux, Max OS X, 或者是 Windows ...
- Apache Flink -Streaming(DataStream API)
综述: 在Flink中DataStream程序是在数据流上实现了转换的常规程序. 1.示范程序 import org.apache.flink.api.common.functions.FlatMap ...
随机推荐
- kvm第四章-- 虚拟化网络管理
- vue-resource发送请求
<!DOCTYPE html> <html> <head> <title>vue-resource</title> <meta cha ...
- idea+maven使用
maven 1. 打开软件,点击configure-project default-settings.配置maven目录. 后续还需要配置一个地方是本地仓库的优先,在runner-VM Options ...
- PimaIndiansdiabetes-数据预处理实验(一)
有趣的事,Python永远不会缺席! 如需转发,请注明出处:小婷儿的python https://www.cnblogs.com/xxtalhr/p/10859517.html 链接:https:// ...
- SHELL字符串处理技巧(${}、##、%%)
在SHELL编程中,经常要处理一些字符串变量.比如,计算长度啊.截取子串啊.字符替换啊等等,常常要用到awk.expr.sed.tr等命令.下面给大家介绍个简单的字符串处理方法,用不着嵌套复杂的子 ...
- py-1 语言介绍
一.编程与编程语言 1.编程的目的 计算机的发明,是为了用机器取代并解放人力.而编程的目的则是将人类的思想流程按照某种能够被计算机识别的表达方式传递给计算机,从而达到让计算机能够像人脑.电脑一样自动执 ...
- Android笔记(九) Android中的布局——框架布局
框架布局没有任何定位方式,所有的控件都会摆放在布局的左上角. 代码示例: framelayout.xml <?xml version="1.0" encoding=" ...
- Promise原理实现
首先先看一下 promise 的调用方式: // 实例化 Promise: new MyPromise((resolve, reject) => { setTimeout(() => { ...
- idea远程debug调试阿里云ECS
1.首先远程服务器的代码跟本地项目代码应该完全一致,否则会出现debug混乱现象,亲测. 2.config如图: ①命名可以省略②复制这个地址③输入远程ip和自定义且未被占用的端口号xxxx 3.开放 ...
- 进程 multiprocessing Process join Lock Queue
多道技术 1.空间上的复用 多个程序公用一套计算机硬件 2.时间上的复用 cpu 切换程序+保存程序状态 1.当一个程序遇到IO操作,操作系统会剥夺该程序的cpu执行权限(提高了cpu的利用率,并且不 ...