
Spark Shuffle机制
Spark Shuffle
一.HashShuffle
普通机制:产生磁盘小文件的数量为:M(map task number)*R(reduce task number)
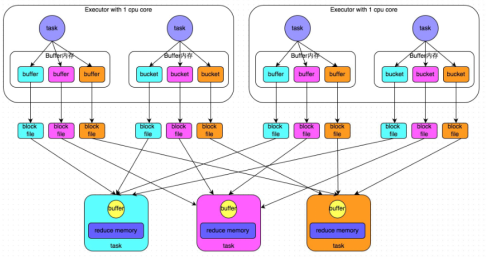
过程:
1.map task处理完数据之后,写到buffer缓冲区,buffer的大小为32k,个数与reduce task个数一致
2. 每个buffer缓存区满32k后会溢写磁盘,每个buffer最终对应一个磁盘小文件
3.reduce task拉取数据
问题:
1.shuffle write,read 频繁
2.占用内存过多,容易造成gc以及出现OOM
3.磁盘小文件多,会造成频繁I/O,效率降低
合并机制:产生磁盘小文件的数量为:C(core number)*R(reduce task number)
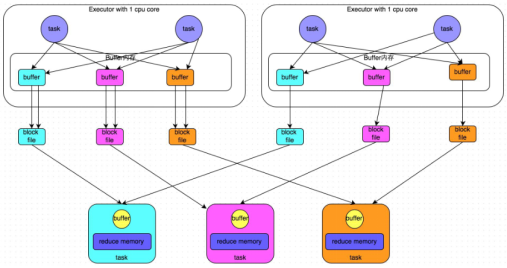
过程:
1.map task处理完数据之后,写到buffer缓冲区,buffer的大小为32k,个数与reduce task个数一致
2.Executor中每个core中的task共用一份buffer缓冲区
3.每个buffer缓存区满32k后会溢写磁盘,每个buffer最终对应一个磁盘小文件
4.reduce task拉取数据
二.SortShuffle
普通机制:产生磁盘小文件数量:2*M(map task number)
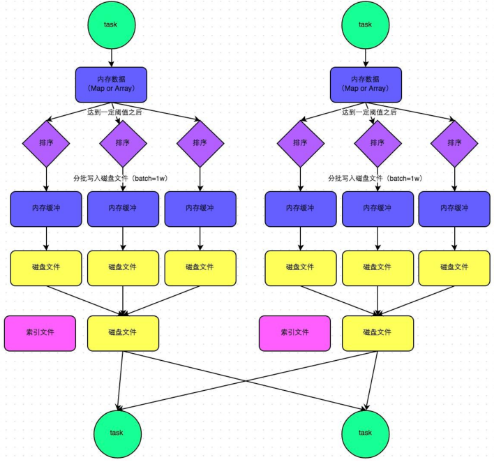
步骤:
1.map task处理完数据之后,首先写入一个5M的数据结构
2.sortShuffle有不定期估算机制,来估算这个内存结构的大小,当估算超过真实的大小,会申请内存:2*估算大小-当前大小
3.申请到内存继续写入内存数据结构,申请不到会溢写磁盘
4.溢写磁盘过程中有排序,每批1万条数据溢写,最终对应两个磁盘文件:一个索引文件,一个数据文件
5.reduce task拉取数据首先读取索引文件,再拉取数据
bypass机制:产生磁盘小文件数量:2*M(map task number)
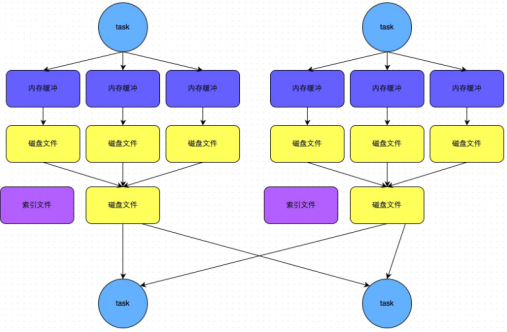
步骤:
1.map task处理完数据之后,首先写入一个5M的数据结构
2.sortShuffle有不定期估算机制,来估算这个内存结构的大小,当估算超过真实的大小,会申请内存:2*估算大小-当前大小
3.申请到内存继续写入内存数据结构,申请不到会溢写磁盘
4.溢写磁盘过程中没有排序,每批1万条数据溢写,最终对应两个磁盘文件:一个索引文件,一个数据文件
5.reduce task拉取数据首先读取索引文件,再拉取数据
Spark Shuffle机制的更多相关文章
- Spark Shuffle机制详细源码解析
Shuffle过程主要分为Shuffle write和Shuffle read两个阶段,2.0版本之后hash shuffle被删除,只保留sort shuffle,下面结合代码分析: 1.Shuff ...
- spark shuffle 机制
spark shuffle 分为两种 1.byPassSortShuffle 发生条件分区数<=200:无排序及聚合操作 主要是直接按照分区号写文件,有多少分区写多少文件 不做任何排序,简单直接 ...
- 【Spark】Spark的Shuffle机制
MapReduce中的Shuffle 在MapReduce框架中,shuffle是连接Map和Reduce之间的桥梁,Map的输出要用到Reduce中必须经过shuffle这个环节,shuffle的性 ...
- 【Spark篇】---Spark中Shuffle机制,SparkShuffle和SortShuffle
一.前述 Spark中Shuffle的机制可以分为HashShuffle,SortShuffle. SparkShuffle概念 reduceByKey会将上一个RDD中的每一个key对应的所有val ...
- spark的shuffle机制
对于大数据计算框架而言,Shuffle阶段的设计优劣是决定性能好坏的关键因素之一.本文将介绍目前Spark的shuffle实现,并将之与MapReduce进行简单对比.本文的介绍顺序是:shuffle ...
- Spark Shuffle原理、Shuffle操作问题解决和参数调优
摘要: 1 shuffle原理 1.1 mapreduce的shuffle原理 1.1.1 map task端操作 1.1.2 reduce task端操作 1.2 spark现在的SortShuff ...
- Spark Shuffle数据处理过程与部分调优(源码阅读七)
shuffle...相当重要,为什么咩,因为shuffle的性能优劣直接决定了整个计算引擎的性能和吞吐量.相比于Hadoop的MapReduce,可以看到Spark提供多种计算结果处理方式,对shuf ...
- 【Spark学习】Apache Spark安全机制
Spark版本:1.1.1 本文系从官方文档翻译而来,转载请尊重译者的工作,注明以下链接: http://www.cnblogs.com/zhangningbo/p/4135808.html 目录 W ...
- Spark工作机制简述
Spark工作机制 主要模块 调度与任务分配 I/O模块 通信控制模块 容错模块 Shuffle模块 调度层次 应用 作业 Stage Task 调度算法 FIFO FAIR(公平调度) Spark应 ...
随机推荐
- MMORPG战斗系统随笔(一)、战斗系统流程简介
前言 转载请标明出处http://www.cnblogs.com/zblade/ 很久没有更新博客,中间迁移过一次博客,后来一直忙于项目的开发,忙的晚上回去没时间写博客,周日又要自我调整一下,所以空闲 ...
- HashMap源码之常用方法--JDK1.8
常用方法 hash(key) static final int hash(Object key) { int h; return (key == null) ? 0 : (h = key.hashCo ...
- Linux两台主机之间建立信任(ssh免密码)
背景: 有时候我们在两个主机之间复制文件的时候,提示输入密码,很不方便,那如何免密码复制呢?,就是使用通过linux公钥和秘钥,建立双机信任关系. 在整理之前,我先说下ssh免密码的要点 : 你想免密 ...
- Python数据可视化的四种简易方法
摘要: 本文讲述了热图.二维密度图.蜘蛛图.树形图这四种Python数据可视化方法. 数据可视化是任何数据科学或机器学习项目的一个重要组成部分.人们常常会从探索数据分析(EDA)开始,来深入了解数据, ...
- Java 容器源码分析之 Set
Set 表示由无重复对象组成的集合,也是集合框架中重要的一种集合类型,直接扩展自 Collection 接口.在一个 Set 中,不能有两个引用指向同一个对象,或两个指向 null 的引用.如果对象 ...
- 基于vue与vux做的可滑动tab组件(附源码)
背景 前不久,刚完成了一个商品列表+购物车功能的页面,因为一级商品分类在顶部tab中显示,可滑动,间距可定制,如下图所示: 定制的tab需求如下: 1. 每个tab-item的间距是相同的,可定制 2 ...
- OJ:自己实现一个简单的 priority_queue
Description 补足程序,使得下面程序输出结果是: 1.8 2.4 3.8 4.9 8.8 #include <iostream> #include <algorithm&g ...
- webpack 配置文件相关解说
博客地址:https://ainyi.com/10 webpack - 什么是webpack: WebPack可以看做是模块打包机:它做的事情是,分析你的项目结构,找到JavaScript模块以及其它 ...
- for 循环 和 Array 数组对象
博客地址:https://ainyi.com/12 for 循环 和 Array 数组对象方法 for for-in for-of forEach效率比较 - 四种循环,遍历长度为 1000000 的 ...
- .Net EF6+Mysql 环境搭建
由于一直使用的数据库是mysql,之前所用的orm都是轻量级的例如 dapper 这些的,然后想用ef配置一下mysql,总共时间花了差不多2天,才将坑填完,写个博客将流程记录一下 给后来者少掉点坑. ...