
Spectral Bounds for Sparse PCA: Exact and Greedy Algorithms[贪婪算法选特征]
概括
这篇论文,不像以往的那些论文,构造优化问题,然后再求解这个问题(一般都是凸化)。而是,直接选择某些特征,自然,不是瞎选的,论文给了一些理论支撑。但是,说实话,对于这个算法,我不敢苟同,我觉得好麻烦的。
Sparse PCA Formulation
非常普遍的问题
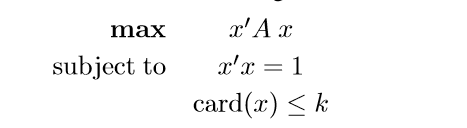
Optimality Conditions
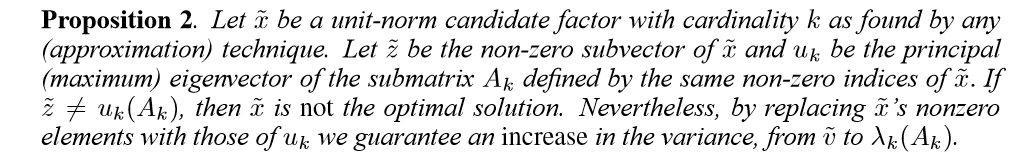
这一小节,论文给出了,上述问题在取得最优的情况下应该符合条件。
条件1
如果\(x^{*} \quad \mathbf{Card}(x^{*})=k\)是上述问题的最优解,那么\(z^{*}\)(由\(x^{*}\)非零元组成)是子举证\(A_k^{*}\)(\(x^{*}\)非零元所在位置,\(A\)的\(k\)行\(k\)列)的主特征向量。
这个条件是显然的。
条件2
感觉和上面也没差啊。
Eigenvalue Bounds
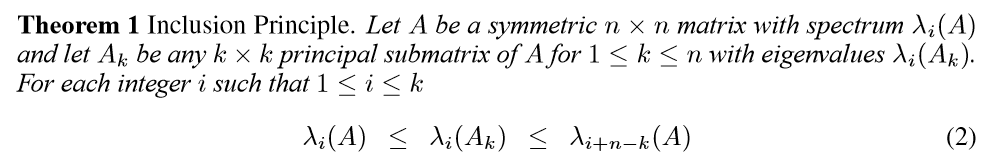
这个定理,可以由一个事实导出:
\(A \in \mathbb{R}^{n\times n}\)为一对称矩阵,\(\lambda_i\)为其特征值,且降序排列。
\(A_{n-1}\)为\(A\)的任意\(n-1\)级主子式,\(\delta_i \quad i=1,2,\ldots,n-1\)为其特征值,那么有下面分隔:
\(\lambda_1 \leq \delta_1 \leq \lambda_2 \leq \ldots \leq \delta_{n-1} \leq \lambda_n\)
根据这个事实,再用归纳法就可以推出上面式子。
分隔定理的证明(《代数特征值问题》p98)
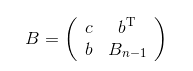
存在正交变换\(Q\),使得\(Q^{\mathrm{T}}BQ\)右下角变为对角阵。若正交矩阵\(S\)使得\(S^{\mathrm{T}}B_{n-1}S\)为对角阵,那么,
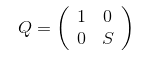
且右下角矩阵的特征值并没有变化。
令:
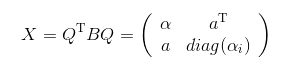
设\(a\)只有\(s\)个成分不为0,若\(a_j=0\),那么\(\alpha_j\)就是\(X\)的特征值。
经过一个适当的置换矩阵\(P\)变换,我们可以得到:
(注意,下面的\(b\)和上面的\(b\)不是一个\(b\),只是为了与书上的符号相一致)
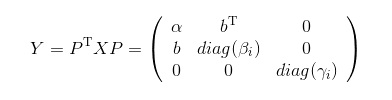
那么只需要考虑
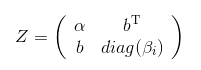
的特征值就行了,因为\(\gamma_i\)是矩阵\(A\)和\(A_{n-1}\)所共有的。
考虑\(Z\)的特征多项式:
\((\alpha-\lambda)\mathop{\prod}\limits_{i=1}^{s}(\beta_i-\lambda)-
\mathop{\sum}\limits_{j=1}^{s}b_j^2\mathop{\prod}\limits_{i \neq j}(\beta_i-\lambda)=0\)
假定\(\beta_i\)中只有\(t\)个不同的值,不失一般性,可令它们为\(\beta_1,\beta_2,\ldots,\beta_t\),
且重数为\(r_1,r_2,\ldots,r_s \quad \mathop{\sum}\limits_{i}r_i=s\)
等式左端有因子:
\(\mathop{\sum}\limits_{i=1}^{t}(\beta_i-\lambda)^{r_i-1}\)
因此,\(\beta_i\)为\(Z\)的特征值,重数为\(r_i-1\)
等式除以\(\mathop{\sum}\limits_{i=1}^{t}(\beta_i-\lambda)^{r_i}\)可得:
\(0=(\alpha-\lambda)-
\mathop{\sum}\limits_{i=1}^{t}c_i^2(\beta_i-\lambda)^{-1}
=a-f(\lambda)\)
\(Z\)的剩余的特征值是\(a-f(\lambda)=0\)的根。
根据正负的特点,和连续函数(实质上是分段的)根的存在性定理,可以知道
\(a-f(\lambda)\)的\(t+1\)个根\(\delta_i\)满足:
\(\delta_1>\beta_1>\delta_2>\ldots>\beta_t>\delta_{t+1}\)
这样所有根的序列就得到了,就是我们要证的。整理一下可以得到,
除了刚刚讲的\(t+1\)个根,
还有\(s-t\)个\(\beta_i\)相同的特征值,以及
\(n-s-1\)个\(\gamma_i\).
另外一个性质
这个性质不想去弄明白了
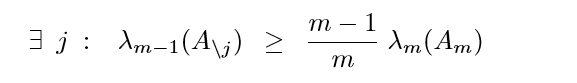
算法
我的理解这样的:
step1.选第一个特征,就是对角元最大的那个
step2.在第一个的基础上,再选一个,这次会形成一个\(2\times2\)的子矩阵,所以,需要选择令这个矩阵首特征值最大的第二个特征。
step3.反复进行,直到k?
这是前向的,还有对应的后向的,一个个减。论文推荐是,俩种都进行,然后挑二者中比较好的一个。
未免太复杂了些?
代码
只写了前向的代码:
import numpy as np

def You_eig_value(C):  #幂法 只输出特征值

    d = C.shape[1]

    x1 = np.random.random(d)

    while True:

        x2 = C @ x1

        x2 = x2 / np.sqrt(x2 @ x2)

        if np.sum(np.abs(x2-x1)) < 0.0001:

            break

        else:

            x1 = x2

    return x1 @ C @ x1

def forward(C):

    n = C.shape[0]

    label1 = set(range(n))

    label = [np.argsort(np.diag(C))[-1]]

    label1 -= set(label)

    count = 0

    while len(label1) > 0:

        count += 1

        maxvalue = 0

        maxi = -1

        for i in label1:

            value = You_eig_value(C[label+[i],:][:,label + [i]])

            if value > maxvalue:

                maxvalue = value

                maxi = i

        label.append(maxi)

        label1 -= {maxi}

    return label

f = open('C:/Users/biiig/Desktop/pitprops.txt')

C = []

for i in f:

    C.append(list(map(float, i.split())))

f.close()

C = np.array(C)

forward(C) # [12, 6, 5, 9, 1, 0, 8, 7, 3, 2, 11, 4, 10]
Spectral Bounds for Sparse PCA: Exact and Greedy Algorithms[贪婪算法选特征]的更多相关文章
- Sparse PCA: reproduction of the synthetic example
The paper: Hui Zou, Trevor Hastie, and Robert Tibshirani, Sparse Principal Component Analysis, Journ ...
- Deflation Methods for Sparse PCA
目录 背景 总括 Hotelling's deflation 公式 特点 Projection deflation 公式 特点 Schur complement deflation Orthogona ...
- Sparse PCA 稀疏主成分分析
Sparse PCA 稀疏主成分分析 2016-12-06 16:58:38 qilin2016 阅读数 15677 文章标签: 统计学习算法 更多 分类专栏: Machine Learning ...
- A direct formulation for sparse PCA using semidefinite programming
目录 背景 Sparse eigenvectors(单个向量的稀疏化) 初始问题(low-rank的思想?) 等价问题 最小化\(\lambda\) 得到下列问题(易推) 再来一个等价问题 条件放松( ...
- Sparse Filtering 学习笔记(二)好特征的刻画
Sparse Filtering 是一个用于提取特征的无监督学习算法,与通常特征学习算法试图建模训练数据的分布的做法不同,Sparse Filtering 直接对训练数据的特征分布进行分析,在所谓 ...
- activity select problem(greedy algorithms)
many activities will use the same place, every activity ai has its' start time si and finish time f ...
- 机器学习:PCA(人脸识别中的应用——特征脸)
一.思维理解 X:原始数据集: Wk:原始数据集 X 的前 K 个主成分: Xk:n 维的原始数据降维到 k 维后的数据集: 将原始数据集降维,就是将数据集中的每一个样本降维:X(i) . WkT = ...
- 用scikit-learn学习主成分分析(PCA)
在主成分分析(PCA)原理总结中,我们对主成分分析(以下简称PCA)的原理做了总结,下面我们就总结下如何使用scikit-learn工具来进行PCA降维. 1. scikit-learn PCA类介绍 ...
- 主成分分析(PCA)原理总结
主成分分析(Principal components analysis,以下简称PCA)是最重要的降维方法之一.在数据压缩消除冗余和数据噪音消除等领域都有广泛的应用.一般我们提到降维最容易想到的算法就 ...
随机推荐
- mssql sqlserver 判断字符串大小写的方法分享
摘要:下文讲述使用sql脚本的方法判断字符串为大小写的方法分享,如下所示 实验环境:sqlserver 2008 R2 实现思路: 将字符串转换为大写或小写然后转换为二进制编码, 然后和源字符串做对比 ...
- SQL SERVER 查询表的行数
SELECT OBJECT_NAME(ii.id) TableName ,rows FROM sysindexes ii INNER JOIN sysobjects oo ON ( oo.id = i ...
- VsCode中使用Emmet神器快速编写HTML代码
一.Emmet简述 Emmet (前身为 Zen Coding) 是一个能大幅度提高前端开发效率的一个工具. 在前端开发的过程中,一大部分的工作是写 HTML.CSS 代码.特别是手动编写 HTML ...
- hivesql优化的深入解析
转载:https://www.csdn.net/article/2015-01-13/2823530 一个Hive查询生成多个Map Reduce Job,一个Map Reduce Job又有Map, ...
- 二、tableau常用难点操作
常用操作: 1.Ctrl+要选的多个字段+“智能显示”选择相应的图形 2.ctrl+m:新建工作表 3.添加行和列时,注意分层结构的利用 3.行的标题颜色的修改: (1)单行:表-右击-阴影-选择相应 ...
- [转]JIRA 7.2.6与Confluence 6.0.3的安装与配置之MS SQL Server版
相关软件版本信息 说明:下方软件可以点击链接,通过百度云盘进行下载. 操作系统:Windows 10(密码:foht)或者Windows Server 2012(密码:lsad): 数据库:SQL S ...
- LeetCode算法题-Convert Sorted Array to Binary Search Tree(Java实现)
这是悦乐书的第166次更新,第168篇原创 01 看题和准备 今天介绍的是LeetCode算法题中Easy级别的第25题(顺位题号是108).给定一个数组,其中元素按升序排序,将其转换为高度平衡的二叉 ...
- js 编辑数组
删除数组第一个元素使用var length = arr.shift(); 删除arr的第一个元素后, 返回值是删除后的数组长度 删除数组最后一个元素使用var length = a ...
- 我的BRF+自学教程(二):跟踪模式(trace mode)
使用自开发程序来处理业务逻辑时,处理过程通常是个黑箱,业务顾问和业务用户不知道程序的具体运行方式,要依赖文档和频繁的沟通来确认实际情况. BRFplus可以通过配置的方式实现业务逻辑,使得业务人员把业 ...
- ES5-ES6-ES7_数组的扩展
Array.prototype.indexOf(value) 得到值在数组中的第一个下标,如果元素不存在返回-1,可以用来判断是否包含指定的元素 var arr = [6,5,4,3,1,7,6]; ...