
爬虫初窥day3:BeautifulSoup
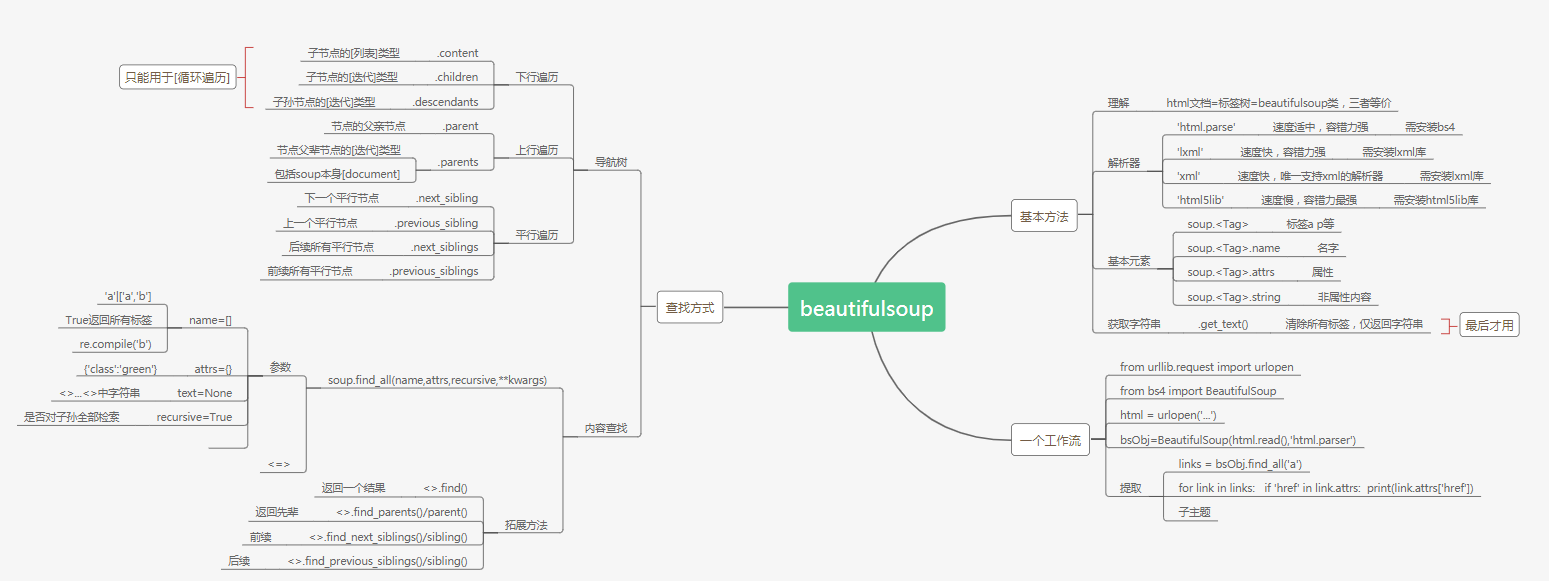
信息提取
1.通过Tag对象的属性和方法
#!/usr/bin/python

# -*- coding: utf- -*-

from urllib.request import urlopen

from bs4 import BeautifulSoup

import re

html = urlopen('https://www.cnblogs.com/pcat/p/5398997.html')

soup = BeautifulSoup(html.read().decode('utf-8'),'html.parser')#避免乱码,先utf-8解码

#print()输出第一个匹配项

print(soup)

print(soup.a)

print(soup.a.name)

print(soup.a.attrs)

print(soup.a.string)

soup.html.get_text()输出字符串,原文排版
2.通过标签树对象的find_all()方法
aS = soup.find_all('a')

for i in aS:

    print(i)

    #print(i.name)

    #print(i.attrs)

    #print(i.string)

#find_all带条件(name,attrs,string,text,recursive,可多条件匹配)

hrefs = soup.find_all(href=re.compile('pcat$'))#以pcat结尾的链接

for i in hrefs:

    print(i)

#对css类名属性class进行搜索时,为避免与python保留字冲突,需用class_

a = soup.find_all(class_ = 'postDesc')

print(a)

#补充1.text匹配非属性内容。.["a","b"]的形式,表示匹配多个值
3.通过标签树对象的find()方法
#find返回一个标签节点,find_all返回多值列表

#find

e1 =soup.find('head').find('title')#在标签名为head的tag中查找title标签

print(e1)
4.通过CSS选择器
#标签名

soup.select('p')#搜索所有标签名为p的标签

soup.select('p a')#搜索所有p标签的子孙节点中标签名为a的标签。即下N层

soup.select('p > a')#搜索所有p标签的直接子节点中标签名为a的标签。即下一层

#类名

soup.select('.blogStats ')#所有类名为blogStats的标签

soup.select('.blogStats span')#所有类名为blogStats且子孙节点中标签名为span的标签

soup.select('a.menu')#标签名为a并且类名为menu的标签

e1=soup.select('a.menu')#标签名为a并且类名为menu的标签

for i in e1:

    print(i['href'])

#id

soup.select('#stats_post_count')#所有id为xxx的标签

soup.select('#navList #blog_nav_sitehome')#所有id为xxx且其子孙节点id为xxx的标签

#属性

soup.select('a[href]')#标签名为a且属性中存在href的所有标签

soup.select('a[href="https://www.cnblogs.com/pcat/"]')#标签名为a且href属性值为http://...的所有标签

soup.select('a[href^="http"]')#标签名为a且href属性以http开头的标签

soup.select('a[href$="http"]')#标签名为a且href属性以pcat结尾的标签

soup.select('a[href*="cnblogs"]')#标签名为a且href属性包含example的标签

#标签名/类名/id/属性 空格[ ] 右符号'>' 相互搭配
遍历
1.下行遍历
| <tag>.contents | 以列表形式返回Tag的所有子节点 |
| <tag>.children | 以迭代形式返回Tag的所有子节点 |
| <tag>.descendants | 以迭代形式返回Tag的所有子孙节点 |
| <tag>.strings | 以迭代形式返回Tag及其所有子孙节点的非属性字符串 |
| <tag>.stripped_strings | 以迭代形式返回Tag去除空白字符后的非属性字符串 |
\c
#contents

e1=soup.ul.contents

print(type(e1))

print(len(e1))

#children

e1=soup.ul.children

for i in e1:

    print(i)

#descendants

e1=soup.ul.descendants

for i in e1:

    print(i)

#strings

e1=soup.ul.strings

for i in e1:

    print(i)

#stripped_strings

e1=soup.ul.stripped_strings

for i in e1:

    print(i)
\c
2.上行遍历
| parent | 以列表形式返回tag的所有父亲节点 |
| parents | 以迭代形式返回tag的所有父辈节点 |
\c
3.水平遍历
| next_sibling | 按文档顺序,返回Tag的下一个相邻兄弟节点 |
| previous_sibling | 按文档顺序,返回Tag的上一个相邻兄弟节点 |
| next_siblings | 按文档顺序,返回Tag的后续兄弟节点 |
| previous_siblings | 按文档顺序,返回Tag的前续兄弟节点 |
爬虫初窥day3:BeautifulSoup的更多相关文章
- 爬虫初窥day4:requests
Requests 是使用 Apache2 Licensed 许可证的 HTTP 库.用 Python 编写,真正的为人类着想. Python 标准库中的 urllib2 模块提供了你所需要的大多数 ...
- 爬虫初窥day2:正则
正则在线测试 http://tool.oschina.net/regex https://www.regexpal.com/ http://tool.chinaz.com/regex exp1:筛选所 ...
- 爬虫初窥day1:urllib
模拟“豆瓣”网站的用户登录 # coding:utf-8 import urllib url = 'https://www.douban.com/' data = urllib.parse.urlen ...
- python爬虫 scrapy2_初窥Scrapy
sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction.htm?courseId=1005269003&utm_campai ...
- Scrapy001-框架初窥
Scrapy001-框架初窥 @(Spider)[POSTS] 1.Scrapy简介 Scrapy是一个应用于抓取.提取.处理.存储等网站数据的框架(类似Django). 应用: 数据挖掘 信息处理 ...
- scrapy2_初窥Scrapy
递归知识:oop,xpath,jsp,items,pipline等专业网络知识,初级水平并不是很scrapy,可以从简单模块自己写. 初窥Scrapy Scrapy是一个为了爬取网站数据,提取结构性数 ...
- Scrapy 1.4 文档 01 初窥 Scrapy
初窥 Scrapy Scrapy 是用于抓取网站并提取结构化数据的应用程序框架,其应用非常广泛,如数据挖掘,信息处理或历史存档. 尽管 Scrapy 最初设计用于网络数据采集(web scraping ...
- python2.7 爬虫初体验爬取新浪国内新闻_20161130
python2.7 爬虫初学习 模块:BeautifulSoup requests 1.获取新浪国内新闻标题 2.获取新闻url 3.还没想好,想法是把第2步的url 获取到下载网页源代码 再去分析源 ...
- R语言爬虫初尝试-基于RVEST包学习
注意:这文章是2月份写的,拉勾网早改版了,代码已经失效了,大家意思意思就好,主要看代码的使用方法吧.. 最近一直在用且有维护的另一个爬虫是KINDLE 特价书爬虫,blog地址见此: http://w ...
随机推荐
- hive 踩坑
1. create tabl metastore.MetaStoreDirectSql: Self-test query [select "DB_ID" from "DB ...
- 【Django】关于ORM的使用
添加模型并映射到数据库中: 1. 在 settings.py 中,配置好 DATABASES ,做好数据库相关的配置. 以mysql为例: DATABASES = { 'default': { 'EN ...
- css中background-size的属性值
length 设置背景图像的高度和宽度. 第一个值设置宽度,第二个值设置高度. 如果只设置一个值,则第二个值会被设置为 "auto". percentage 以父元素的百分比来设置 ...
- Winform开发框架之简易工作流设计(转自 伍华聪博客)
Winform开发框架之简易工作流设计 一讲到工作流,很多人第一反应就是这个东西很深奥,有时候又觉得离我们较为遥远,确实完善的工作流设计很多方面,而正是由于需要兼顾很多方面,一般通用的工作流都难做到尽 ...
- Android笔记:OptionsMenu
使用菜单选项OptionsMenu,需要进行以下操作:(1)重写onCreateOptionsMenu方法: public boolean onCreateOptionsMenu(Menu menu) ...
- centos 7 redis-4.0.11 哨兵
redis-master:192.168.199.223 redis-slave_1: 192.168.199.224 redis-slave_2: 192.168.199.252 redis-mas ...
- 七:python 对象类型详解三:列表
一:列表简介: 1,列表可以包含任何种类的对象:数字.字符串甚至集合对象类型.列表都是可变对象,它们都支持在原处修改的操作,可以通过指定的偏移量和分片.列表方法调用.删除语句等方法来实现.关键的作用有 ...
- 与服务器同步工程(expect脚本)
先看下我实际用的例子: #!/usr/bin/expect spawn rsync -vazu ssh-src/src wayne@192.168.5.2:~/projects/ expect &qu ...
- Android 环境搭建与Android SDK目录介绍
Android SDK下载和安装 本地已有合适版本Android SDK,则无需再下载,或者可以使用SDK Manager更新SDK: 没有SDK,则需要下载. 这里说一下使用SDK Manager下 ...
- UVA1588-Kickdown
2018-10-30-18:27:03 原题链接 题目描述: 给出两个长度分别为n1,n2且每列高度只为1或2的长条,需要将它们放入一个高度为3的容器,求出能够容纳他们的最短容器长度. 本题思路: 模 ...