
作业3-k均值算法
4. 作业:
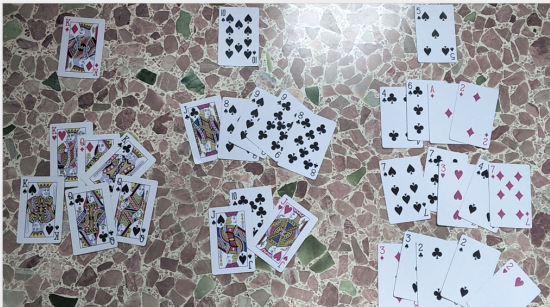
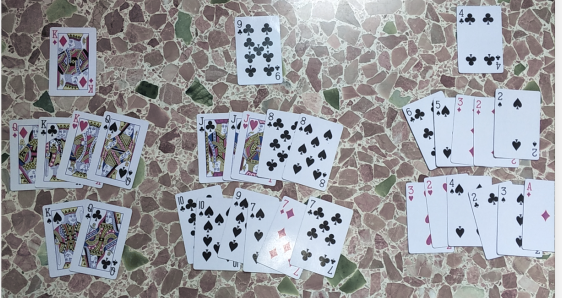
1). 扑克牌手动演练k均值聚类过程:>30张牌,3类
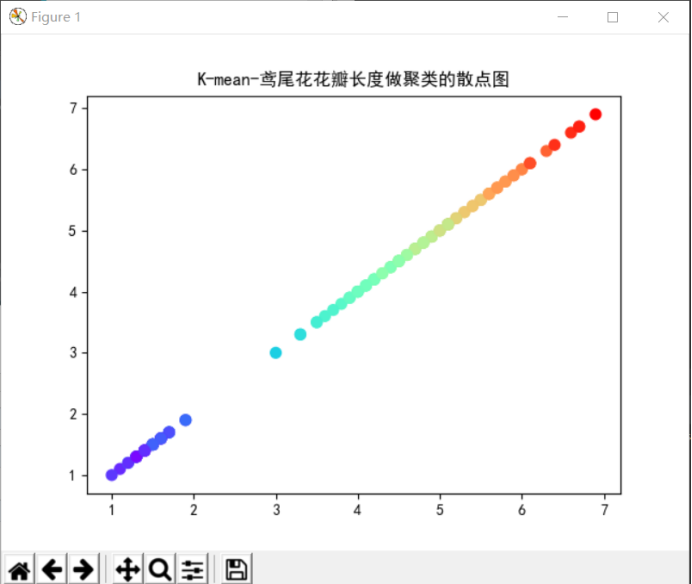
2). *自主编写K-means算法 ,以鸢尾花花瓣长度数据做聚类,并用散点图显示。(加分题)
3). 用sklearn.cluster.KMeans,鸢尾花花瓣长度数据做聚类,并用散点图显示.
4). 鸢尾花完整数据做聚类并用散点图显示.
5).想想k均值算法中以用来做什么
答:
(1)
第一轮:13、10、5
第二轮:13、9、4
(2)
import matplotlib.pyplot as plt

from sklearn.datasets import load_iris

import numpy as np

#导入数据

iris = load_iris()

data = iris.data   # 数据值

data.shape     # 可知数据的总数和属性个数

n = len(data)  # 数据集样本个数

m = data.shape[1]  # 数据的属性个数

# 类中心个数(1-5)

k = 3

dist = np.zeros([n, k+1])  # k+1是最后一列要归类

# 选中心

center = data[:k, :]    # k为3所以是前三行所有属性

centerNew = np.zeros([k, m])  # 初始化新的类中心

while True:

    # 求距离

    for i in range(n):

        for j in range(k):

            dist[i, j] = np.sqrt(sum((data[i, :]-center[j, :])**2))    # 求欧式距离

    # 归类

        dist[i, k] = np.argmin(dist[i, :k])

    for i in range(k):

        index = dist[:, k] == i

        centerNew[i, :] = data[index, :].mean(axis=0)

    # 判定结果

    if np.all((center == centerNew)):

        break

    else:

        center = centerNew

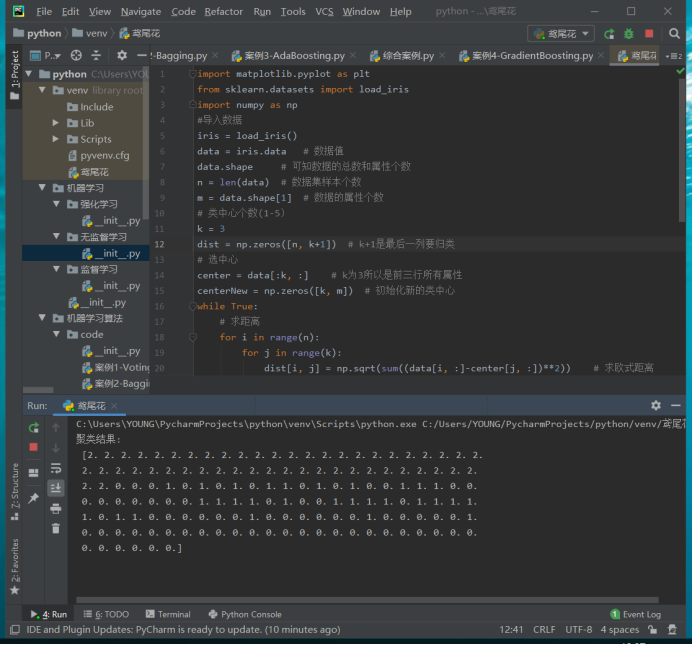
print("聚类结果:\n", dist[:, k])

# print(data[:,k])

plt.scatter(data[:,2], data[:,2], c=dist[:,2], s=50, cmap='rainbow')

plt.rcParams['font.sans-serif'] = ['SimHei']  # 设置字体

plt.title("K-mean-鸢尾花花瓣长度做聚类的散点图")

plt.show()
(3)
# 用sklearn.cluster.KMeans,鸢尾花花瓣长度数据做聚类,并用散点图显示.

import matplotlib.pyplot as plt

from sklearn.datasets import load_iris

from sklearn.cluster import KMeans

iris = load_iris()    # 导入鸢尾花数据

# print(iris)

X = iris.data[:, 2]   # 第三列为花瓣长度

X = X.reshape(-1, 1)  # 令新数组列为1

# print(X)

y = KMeans(n_clusters=3)   # 模型构建(类中心数为3)

y.fit(X)                   # 模型训练

kc = y.cluster_centers_    # 聚类中心

y_kmeans = y.predict(X)    # 预测每个样本的聚类索引

print("聚类结果:\n", y_kmeans)

print("聚类中心:\n", kc)

plt.scatter(X[:, 0], X[:, 0], c=y_kmeans, s=50, cmap='rainbow')  # 画散点图

plt.rcParams['font.sans-serif'] = ['SimHei']  # 设置字体

plt.title("sklearn.cluster.KMeans-鸢尾花花瓣长度做聚类的散点图")

plt.show()

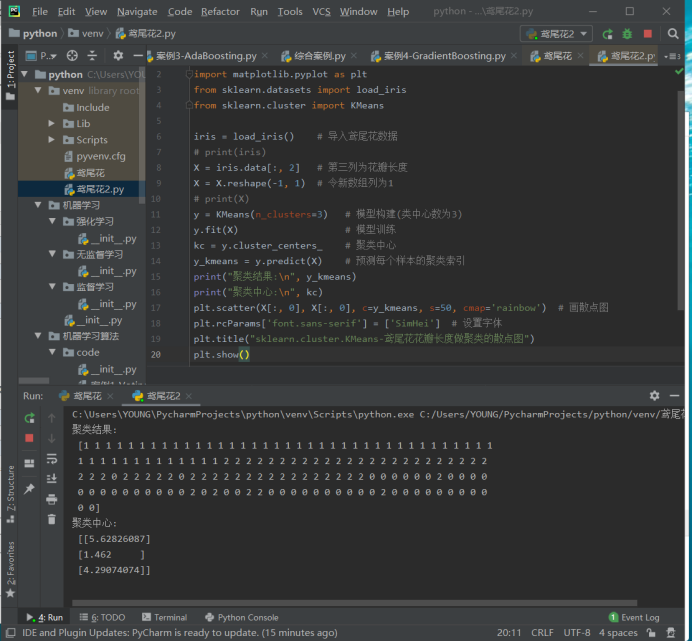
(4)
# 鸢尾花完整数据做聚类并用散点图显示.

import matplotlib.pyplot as plt

from sklearn.datasets import load_iris

from sklearn.cluster import KMeans

iris = load_iris()   # 导入鸢尾花数据

X = iris.data        # 鸢尾花完整数据

# print(X)

y = KMeans(n_clusters=3)  # 模型构建(类中心数为3)

y.fit(X)                  # 模型训练

kc = y.cluster_centers_   # 聚类中心

y_kmeans = y.predict(X)   # 预测每个样本的聚类索引

print("聚类结果:\n", y_kmeans)

print("聚类中心:\n", kc)

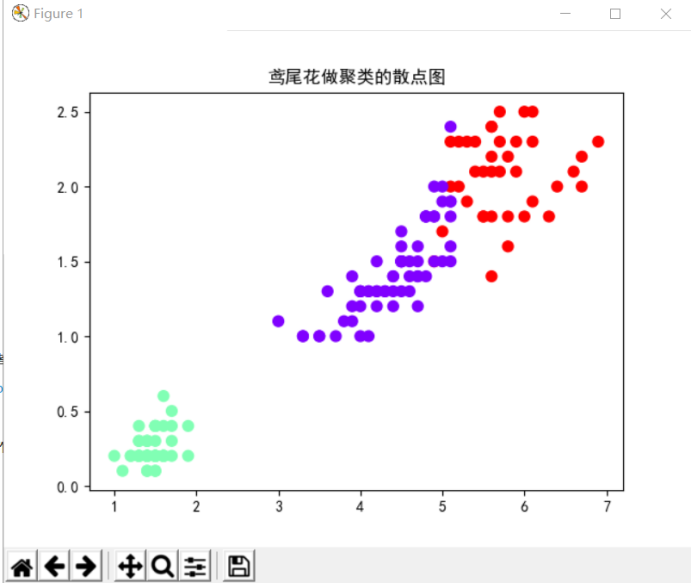
plt.scatter(X[:, 2], X[:, 3], c=y_kmeans, s=50, cmap='rainbow')  # 画散点图

plt.rcParams['font.sans-serif'] = ['SimHei']  # 设置字体

plt.title("鸢尾花做聚类的散点图")

plt.show()
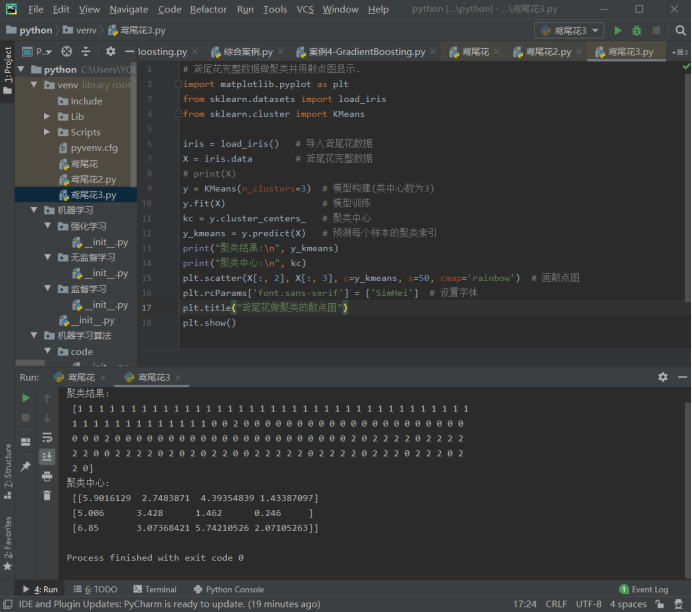
(5)可以通过k均值算法进行库存分类,例如按销售活动分组库存或者按制造指标对库存进行分组,也可以用来识别不同类型的癌症特征。
作业3-k均值算法的更多相关文章
- 聚类算法:K-means 算法(k均值算法)
k-means算法: 第一步:选$K$个初始聚类中心,$z_1(1),z_2(1),\cdots,z_k(1)$,其中括号内的序号为寻找聚类中心的迭代运算的次序号. 聚类中心的向量值可任意设 ...
- 一句话总结K均值算法
一句话总结K均值算法 核心:把样本分配到离它最近的类中心所属的类,类中心由属于这个类的所有样本确定. k均值算法是一种无监督的聚类算法.算法将每个样本分配到离它最近的那个类中心所代表的类,而类中心的确 ...
- 聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用
1.用python实现K均值算法 import numpy as np x = np.random.randint(1,100,20)#产生的20个一到一百的随机整数 y = np.zeros(20) ...
- 【机器学习】K均值算法(I)
K均值算法是一类非监督学习类,其可以通过观察样本的离散性来对样本进行分类. 例如,在对如下图所示的样本中进行聚类,则执行如下步骤 1:随机选取3个点作为聚类中心. 2:簇分配:遍历所有样本然后依据每个 ...
- Bisecting KMeans (二分K均值)算法讲解及实现
算法原理 由于传统的KMeans算法的聚类结果易受到初始聚类中心点选择的影响,因此在传统的KMeans算法的基础上进行算法改进,对初始中心点选取比较严格,各中心点的距离较远,这就避免了初始聚类中心会选 ...
- KMeans (K均值)算法讲解及实现
算法原理 KMeans算法是典型的基于距离的聚类算法,采用距离作为相似性的评价指标,即认为两个对象的距离越近,其相似度就越大.该算法认为簇是由距离靠近的对象组成的,因此把得到紧凑且独立的簇作为最终目标 ...
- 聚类分析K均值算法讲解
聚类分析及K均值算法讲解 吴裕雄 当今信息大爆炸时代,公司企业.教育科学.医疗卫生.社会民生等领域每天都在产生大量的结构多样的数据.产生数据的方式更是多种多样,如各类的:摄像头.传感器.报表.海量网络 ...
- K均值算法
为了便于可视化,样本数据为随机生成的二维样本点. from matplotlib import pyplot as plt import numpy as np import random def k ...
- K均值算法-python实现
测试数据展示: #coding:utf-8__author__ = 'similarface''''实现K均值算法 算法摘要:-----------------------------输入:所有数据点 ...
- spark Bisecting k-means(二分K均值算法)
Bisecting k-means(二分K均值算法) 二分k均值(bisecting k-means)是一种层次聚类方法,算法的主要思想是:首先将所有点作为一个簇,然后将该簇一分为二.之后选择能最大程 ...
随机推荐
- Oracle如何查询不等于某数值
前言 今天在使用Oracle查询“不等于”的时候,发现得到的数据与期望中的不一样,进一步查找资料才有发现. 1.Oracle的不等于 在Oracle中,"<>".&qu ...
- Django-User
User对象 User对象是认证系统的核心.用户对象通常用来代表网站的用户,并支持例如访问控制.注册用户.关联创建者和内容等.在Django认证框架中只有一个用户类,例如超级用户('superuser ...
- Activiti网关--包含网关
1.什么是包含网关 包含网关可以看做是排他网关和并行网关的结合体:和排他网关一样,你可以在外出顺序流上定义条件,包含网关会解析它们:但是主要的区别是包含网关可以选择多于一条顺序流,这和并行网关一样,包 ...
- RedHat 6.7 使用 CentOS 6 的源
1. 移除 RedHat 相关软件包 # yum -y remove subscription-manager and rh-check # rpm -aq | grep yum | xargs rp ...
- 艾编程coding老师课堂笔记:SpringBoot源码深度解析
思想:有道无术,术尚可求,有术无道,止于术! Spring 开源框架,解决企业级开发的复杂性的问题,简化开发 AOP, IOC Spring 配置越来多,配置不方便管理! Javaweb---Serv ...
- stm32:实现呼吸灯
1.main.c #include "sys.h" #include "delay.h" #include "key.h" #define ...
- git基础使用合集
1.git初始化仓库-git init git init 创建一个.git目录,跟踪管理版本 2.git 添加-git add git add xxx.xxx 添加到暂缓区里 git add * 添加 ...
- django_rest_framework视图传递参数给序列化器
django_rest_framework视图传递参数给序列化器 视图中默认可以将request.data传递给序列化器,但request.data是不可更改的对象,但又想将额外的参数传递给序列化器 ...
- 2017蓝桥杯取位数(C++B组)
题目: 标题:取数位求1个整数的第k位数字有很多种方法.以下的方法就是一种.// 求x用10进制表示时的数位长度 int len(int x){ if(x<10) return 1; retur ...
- Python 1基础语法三(变量和标识符的区别)
一.字面量: 就是一个一个的值,如1.2.3.‘world’,就是它自己本身表达的字面值.字面意思,在程序中可以直接使用. 二.变量(variable): 可以用来保存字面量,变量本身没有任何意思:如 ...