
聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用
1.用python实现K均值算法
import numpy as np

x = np.random.randint(1,100,20)#产生的20个一到一百的随机整数

y = np.zeros(20)

k = 3

print(x)

print(y)

def initcenter(x,k):#初始化聚类中心数组

    return x[0:k].reshape(k)

kc = initcenter(x,k)

print(kc)

def nearest(kc, i):#定义函数求出kc与i之差最小的数的坐标

    d = (abs(kc - i))

    w = np.where(d == np.min(d))

    return w[0][0]

# print(nearest(kc,66))

# for i in range(x.shape[0]):

#     y[i] = nearest(kc,x[i])

# print(y)

def xclassify(x, y, kc):#按距离最近的准则将它们分到距离它们最近的聚类中心(最相似)所对应的类

    for i in range(x.shape[0]):

        y[i] = nearest(kc,x[i])

    return y

y = xclassify(x,y,kc)

print(x)

print(y)
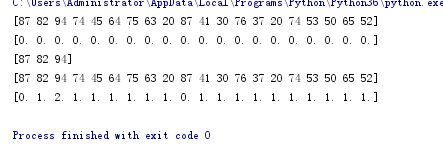
#.用sklearn.cluster.KMeans,鸢尾花完整数据做聚类并用散点图显示.

import matplotlib.pyplot as plt

import numpy as np

from sklearn.datasets import load_iris

iris=load_iris()

print(iris)

X=iris.data

print(X)

from sklearn.cluster import KMeans

est = KMeans(n_clusters=3)

est.fit(X)

kc = est.cluster_centers_

y_kmeans = est.predict(X) #预测每个样本的聚类索引

print(y_kmeans,kc)

print(kc.shape,y_kmeans.shape)

plt.scatter(X[:,0],X[:,1],c=y_kmeans,s=50,cmap='rainbow')

plt.show()
# 鸢尾花完整数据做聚类并用散点图显示.

from sklearn.cluster import KMeans

import numpy as np

from sklearn.datasets import load_iris

import matplotlib.pyplot as plt

data = load_iris()

iris = data.data

petal_len = iris

print(petal_len)

k_means = KMeans(n_clusters=3) #三个聚类中心

result = k_means.fit(petal_len) #Kmeans自动分类

kc = result.cluster_centers_ #自动分类后的聚类中心

y_means = k_means.predict(petal_len) #预测Y值

plt.scatter(petal_len[:,0],petal_len[:,2],c=y_means, marker='p',cmap='rainbow')

plt.show()
聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用的更多相关文章
- 第八次作业:聚类--K均值算法:自主实现与sklearn.cluster.KMeans调用
import numpy as np x = np.random.randint(1,100,[20,1]) y = np.zeros(20) k = 3 def initcenter(x,k): r ...
- 聚类--K均值算法
import numpy as np from sklearn.datasets import load_iris iris = load_iris() x = iris.data[:,1] y = ...
- K 均值算法-如何让数据自动分组
公号:码农充电站pro 主页:https://codeshellme.github.io 之前介绍到的一些机器学习算法都是监督学习算法.所谓监督学习,就是既有特征数据,又有目标数据. 而本篇文章要介绍 ...
- 机器学习之K均值算法(K-means)聚类
K均值算法(K-means)聚类 [关键词]K个种子,均值 一.K-means算法原理 聚类的概念:一种无监督的学习,事先不知道类别,自动将相似的对象归到同一个簇中. K-Means算法是一种聚类分析 ...
- 聚类算法:K-means 算法(k均值算法)
k-means算法: 第一步:选$K$个初始聚类中心,$z_1(1),z_2(1),\cdots,z_k(1)$,其中括号内的序号为寻找聚类中心的迭代运算的次序号. 聚类中心的向量值可任意设 ...
- 3.K均值算法
一.概念 K-means中心思想:事先确定常数K,常数K意味着最终的聚类类别数,首先随机选定初始点为质心,并通过计算每一个样本与质心之间的相似度(这里为欧式距离),将样本点归到最相似的类中,接着,重新 ...
- 一句话总结K均值算法
一句话总结K均值算法 核心:把样本分配到离它最近的类中心所属的类,类中心由属于这个类的所有样本确定. k均值算法是一种无监督的聚类算法.算法将每个样本分配到离它最近的那个类中心所代表的类,而类中心的确 ...
- 【机器学习】K均值算法(I)
K均值算法是一类非监督学习类,其可以通过观察样本的离散性来对样本进行分类. 例如,在对如下图所示的样本中进行聚类,则执行如下步骤 1:随机选取3个点作为聚类中心. 2:簇分配:遍历所有样本然后依据每个 ...
- Bisecting KMeans (二分K均值)算法讲解及实现
算法原理 由于传统的KMeans算法的聚类结果易受到初始聚类中心点选择的影响,因此在传统的KMeans算法的基础上进行算法改进,对初始中心点选取比较严格,各中心点的距离较远,这就避免了初始聚类中心会选 ...
随机推荐
- CodeBlocks中我遇到的无法调试问题及解决方案
CodeBlocks中遇到无法调试问题,可能有很多种,以下是我遇到的问题及解决方案 1.当无法调试时,如果IDE提示你出现下图中红色问题,说明你的调试器没有装好 2.在菜单栏点击Settings--D ...
- Oracle 11g 测试ogg中断之后,重新同步操作
测试ogg中断之后,重新同步操作 2018-06-07 17:11 779 1 原创 GoldenGate 本文链接:https://www.cndba.cn/leo1990/article/2839 ...
- Tomcat各个版本下载路径
http://archive.apache.org/dist/tomcat/tomcat-7/ 修改对应版本号即可比如 tomcat-8
- git版本控制系统更新
版本控制系统: 一.概念: 版本控制系统(Version Control System):是一种记录一个或若干文件内容变化,以便将来查阅特定版本修订情况的系统. 二.版本控制系统分类 1.本地版本控制 ...
- android spf中存list<string>
private void setSpfList() { final SharedPreferences mSharedPreferences = getPreferences(Context.MODE ...
- Flask项目笔记
一.jsonify jsonify 是flask的函数,可以将字典转换成json数据返回给浏览器二. 钩子函数 @app.before_first_request:第一次请求调用,用于初始化数据 @ ...
- vue 及sass安装
推荐:https://www.cnblogs.com/Mr--Li/p/7921150.html
- MySQL父子节点查询
MySQL父子结点递归查询 表结构: CREATE TABLE `agency` ( `id` ) NOT NULL COMMENT '编号', `name` ) NOT NULL COMMENT ' ...
- list练习
usernames = ['cwl','pn','gxn','hyp']passwords = ['123456','abc123','324234','23423']#pn#sdfsdf #需要校验 ...
- makefile笔记1 - 初识makefile
前情提要 上一篇<编译入门>讲了变成的基本问题.如果源文件只有一个,就如之前的例子,那么用gcc命令直接编译就可以了.但是很多实际的工程用到的源文件都是相当多的,这时候用命令一个个编译是很 ...