
算法总结篇---字典树(Trie)
写在前面
字典树是一种清新通俗的数据结构(还是算法?)
顾名思义,字典树就是一棵像字典一样的树,可以用来查询某个单词是否出现过,查询过程就像查字典一样每个字符挨个找,看看是否有这个单词
具体实现
引例:
给你两个整数 \(n\) 和 \(m\) ,表示有 \(n\) 个单词和 \(m\) 次询问
在询问过程中,如果某个单词第一次被查到输出OK,如果不是第一次被查到输出REPEAT,如果没有该单词输出WRONG
先看一个样例
5

i

he

his

she

hers

3

hi

sheself

love
贴一个字典树成品图:
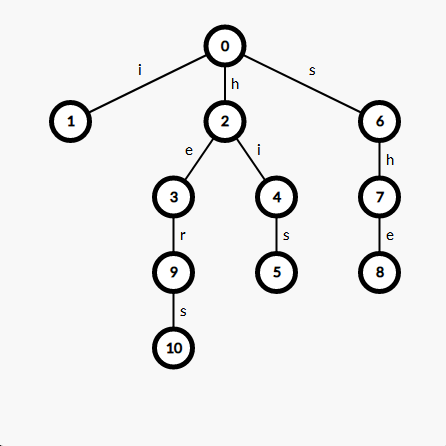
可以发现,生成的这棵字典树可以从根节点 \(0\) 开始,找到所有给出的单词。举个栗子,\(0 \to 2 \to 4 \to 5\) 表示的就是单词 his
字典树的结构还是比较简单的,我们用 \(tr_{u,c}\) 表示结点 \(u\) 通过 \(c\) 字符指向的下一个结点,或者说在结点 \(u\) 所代表的字符串中加一个字符 \(c\) 后所在的新节点(\(c\) 的取值与字符集有关,可根据题目具体要求来定)
相信大家已经发现 he 在 hers 的路径上有重叠,那么如何区分呢?
为了标记插入字典树的字符串,只需要每次插入完成时标记其所在的结点即可
放一个结构体封装的模板
struct Trie{

	int tr[MAXN][26], node_cnt = 0;//字典树以及结点个数

	bool cnt[MAXN];//标记是否是某个字符串的结尾

	void insert(char *s){//插入操作

		int now = 0, len = strlen(s + 1);//now表示当前所在的结点,len表示字符串长度

		for(int i = 1; i <= len; ++i){

			int ch = s[i] - 'a';//取出要插入的字符

			if(! tr[now][ch]) tr[now][ch] = ++node_cnt;

			//如果这个字符未被插入,新建一个结点将其插入

			now = tr[now][ch];//now指针跳向tr[now][ch]指向的位置

		}

		cnt[now] = true;//在字符串完成时所在的结点处打上标记

	}

	int find(char *s){//查询操作

		int now = 0, len = strlen(s + 1);//意义同上

		for(int i = 1; i <= len; ++i){

			int ch = s[i] - 'a';

			if(!tr[now][ch]) return false;//如果没有遍历到的字符,直接返回false

			now = tr[now][ch];//now指针跳向tr[now][ch]指向的位置

		}

		return cnt[now];

		//注意这里不能直接返回true,有可能查询的只是某个串的前缀,比如在样例中查询her

	}

} trie;
具体解释在注释里讲的很清楚了
引例代码:
只需要在查询返回时做一下标记处理即可
/*

Work by: Suzt_ilymics

Knowledge: ??

Time: O(??)

*/

#include<iostream>

#include<cstdio>

#include<cstring>

#include<algorithm>

#define LL long long

#define orz cout<<"lkp AK IOI!"<<endl

using namespace std;

const int MAXN = 1e6+4;

const int INF = 1;

const int mod = 1;

int n, m;

char s[100];

int read(){

	int s = 0, f = 0;

	char ch = getchar();

	while(!isdigit(ch))  f |= (ch == '-'), ch = getchar();

	while(isdigit(ch)) s = (s << 1) + (s << 3) + ch - '0' , ch = getchar();

	return f ? -s : s;

}

struct Trie{

	int tr[MAXN][26], node_cnt = 0;

	int cnt[MAXN];

	void insert(char *s){

		int now = 0, len = strlen(s + 1);

		for(int i = 1; i <= len; ++i){

			int ch = s[i] - 'a';

			if(! tr[now][ch]) tr[now][ch] = ++node_cnt;

			now = tr[now][ch];

		}

		cnt[now] = 1;

	}

	int find(char *s){

		int now = 0, len = strlen(s + 1);

		for(int i = 1; i <= len; ++i){

			int ch = s[i] - 'a';

			if(!tr[now][ch]) return 0;

			now = tr[now][ch];

		}

		if(cnt[now] == 1){

			cnt[now] = 2;

			return 1;

		}

		return 2;

	}

} trie;

int main()

{

	n = read();

	for(int i = 1; i <= n; ++i) cin >> s + 1, trie.insert(s);

	m = read();

	for(int i = 1; i <= m; ++i){

		cin >> s + 1;

		int ans = trie.find(s);

		if(ans == 0) printf("WRONG\n");

		else if(ans == 1) printf("OK\n");

		else printf("REPEAT\n");

	}

	return 0;

}
例题
Phone List
T组数据,每组数据给出n个长度不超过10数字串,问是否有一个串是另一个串的前缀
Solution:
朴素做法是 \(n^{2}\) 判断,
考虑如何用字典树做,把n个数字串插入字典树,在从头遍历一遍看看是否是其他字符串的前缀,复杂度 \(O(\sum\mid S \mid)\)
稍微优化一下,在插入时判断。发现一个数是另一个数的前缀有两种可能,一是遍历过程中经过了其他标记过的结点,二是遍历结束后没有新建结点
The XOR Largest Pair
在给定的 \(N\) 个整数 \(A_1,A_2,···A_n\) 中选出两个进行异或运算,得到的结果最大是多少? $(0 \le n \le 2^{31} ) $
Solution
使用类似贪心的方法,先把 \(n\) 个数插进去时,将其拆成二进制,先插高位再插低位
在 \(O(n)\) 扫一遍所有数查询最大值,如果对应位数 \(x \ xor \ 1\) 存在,就走 \(tr[now][x \ xor \ 1]\) ,否则走 \(tr[now][x]\),遍历过程中统计答案即可,最后对所有答案取最大值
L语言
给定由 \(n\) 个单词组成的字典,有 \(m\) 段文章,输出一段文章从前向后理解最多能理解多少。
规定一段字符串被理解当且仅当这一段字符串是字典中的某整个单词
Solution:
建树不多说了,
在理解一段文章时,因为每当一段字符是字典中的整个单词,都可以被理解,那么从前向后遍历,对于某个位置,如果它是某个单词的结尾,那么它的下一个位置可以重新从根节点中开始匹配。在匹配过程中如果发现遍历到的结点是某个单词的结尾,将其标记,方便下一次匹配。匹配过程中顺便记录最后一个被标记的单词的结尾的位置。
算法总结篇---字典树(Trie)的更多相关文章
- 字典树(Trie)详解
详解字典树(Trie) 本篇随笔简单讲解一下信息学奥林匹克竞赛中的较为常用的数据结构--字典树.字典树也叫Trie树.前缀树.顾名思义,它是一种针对字符串进行维护的数据结构.并且,它的用途超级广泛.建 ...
- [POJ] #1002# 487-3279 : 桶排序/字典树(Trie树)/快速排序
一. 题目 487-3279 Time Limit: 2000MS Memory Limit: 65536K Total Submissions: 274040 Accepted: 48891 ...
- 『字典树 trie』
字典树 (trie) 字典树,又名\(trie\)树,是一种用于实现字符串快速检索的树形数据结构.核心思想为利用若干字符串的公共前缀来节约储存空间以及实现快速检索. \(trie\)树可以在\(O(( ...
- 字典树trie学习
字典树trie的思想就是利用节点来记录单词,这样重复的单词可以很快速统计,单词也可以快速的索引.缺点是内存消耗大 http://blog.csdn.net/chenleixing/article/de ...
- nyoj 163 Phone List(动态字典树<trie>) poj Phone List (静态字典树<trie>)
Phone List 时间限制:1000 ms | 内存限制:65535 KB 难度:4 描述 Given a list of phone numbers, determine if it i ...
- 【字符串算法】字典树(Trie树)
什么是字典树 基本概念 字典树,又称为单词查找树或Tire树,是一种树形结构,它是一种哈希树的变种,用于存储字符串及其相关信息. 基本性质 1.根节点不包含字符,除根节点外的每一个子节点都包含一个字符 ...
- 算法与数据结构基础 - 字典树(Trie)
Trie基础 Trie字典树又叫前缀树(prefix tree),用以较快速地进行单词或前缀查询,Trie节点结构如下: //208. Implement Trie (Prefix Tree)clas ...
- 字典树(Trie树)的实现及应用
>>字典树的概念 Trie树,又称字典树,单词查找树或者前缀树,是一种用于快速检索的多叉树结构,如英文字母的字典树是一个26叉树,数字的字典树是一个10叉树.与二叉查找树不同,Trie树的 ...
- 字典树(Trie Tree)
在图示中,键标注在节点中,值标注在节点之下.每一个完整的英文单词对应一个特定的整数.Trie 可以看作是一个确定有限状态自动机,尽管边上的符号一般是隐含在分支的顺序中的.键不需要被显式地保存在节点中. ...
随机推荐
- 使用 CoreDNS 来应对 DNS 污染
原文链接:https://fuckcloudnative.io/posts/install-coredns-on-macos/ CoreDNS 是 Golang 编写的一个插件式 DNS 服务器,是 ...
- 面试常问:Mybatis使用了哪些设计模式?
前言 虽然我们都知道有26个设计模式,但是大多停留在概念层面,真实开发中很少遇到,Mybatis源码中使用了大量的设计模式,阅读源码并观察设计模式在其中的应用,能够更深入的理解设计模式. Mybati ...
- Mac电脑jsp连接mysql
四个步骤教你如何用jsp代码连接mysql 第一步:下载jdbc驱动 进入mysql官网:https://dev.mysql.com/downloads/connector/ 找到Connect/J ...
- JAVA的一些笔记
/*一般函数与构造函数的区别 构造函数:对象创建时,就会调用与之对应的构造函数,对对象进行初始化 一般函数:对象创建时,需要函数功能时才调用 构造函数:一个对象对象创建时,只调用一次 一般函数:对象创 ...
- INNER JOIN、LEFT JOIN、RIGHT JOIN、FULL JOIN 的使用和区别
INNER JOIN:如果表中有至少一个匹配,则返回行 LEFT JOIN:即使右表中没有匹配,也从左表返回所有的行 RIGHT JOIN:即使左表中没有匹配,也从右表返回所有的行 FULL JOIN ...
- TurtleBot3使用课程-第二节b(北京智能佳)
目录 1.导航 2 1.1 运行导航节点 3 1.1.1 [远程PC]运行roscore 3 1.1.2 [turtlebot3 SBC]运行提出turtlebot3 3 1.1.3[远程PC]运行导 ...
- JUC包-原子类(AtomicInteger为例)
目录 JUC包-原子类 为什么需要JUC包中的原子类 原子类原理(AtomicInteger为例) volatile CAS CAS的缺点 ABA问题 什么是ABA问题 ABA问题的解决办法 JUC包 ...
- java:原子类的CAS
当一个处理器想要更新某个变量的值时,向总线发出LOCK#信号,此时其他处理器的对该变量的操作请求将被阻塞,发出锁定信号的处理器将独占共享内存,于是更新就是原子性的了. 1.compareAndSet- ...
- Flutter 布局类组件:弹性布局(Flex)
前言 弹性布局允许子组件按照一定比例来分配父容器空间,Flutter中的弹性布局主要通过Flex和Expanded来配合实现. Flex Flex组件可以沿着水平或垂直方向排列子组件,如果你知道主轴方 ...
- MySQL中的全局锁和表级锁
全局锁和表锁 数据库锁设计的初衷是解决并发出现的一些问题.当出现并发访问的时候,数据库需要合理的控制资源的访问规则.而锁就是访问规则的重要数据结构. 根据锁的范围,分为全局锁.表级锁和行级锁三类. 全 ...