
【python爬虫】根据查询词爬取网站返回结果
最近在做语义方面的问题,需要反义词。就在网上找反义词大全之类的,但是大多不全,没有我想要的。然后就找相关的网站,发现了http://fanyici.xpcha.com/5f7x868lizu.html,还行能把“老师”-“学生”,“医生”-“病人”这样对立关系的反义词查出来。

一开始我想把网站中数据库中存在的所有的词语都爬出来(暗网爬虫),但是分析了url的特点:
http://fanyici.xpcha.com/5f7x868lizu.html
查询词和非阴影部分的剩余的7个位置有关,如果暴力破解的发,总共(26+10)^7=78364164096~780亿个url有很多没用的。写了个爬虫爬,感觉太慢了,暂时放弃了这种想法,想用模拟浏览器的方式,根据查询词的存储查询结果。在网上找了很多资料,终于搞定。
使用的是mechanize模块,它是非常适合的模拟浏览器模块。可以利用该模块完成一些浏览器想要做的事,比如自动填写表单。主要特点:
- http,https协议等
- 简单的HTML表单填写
- 浏览器历史记录和重载
- Referer的HTTP头的正确添加(可选)
- 自动遵守robots.txt的
- 自动处理HTTP-EQUIV和刷新
下面以解决该问题为导向,记录下完成步骤
0. 预备
环境:linux python 2.7
安装模块:mechanize cookielib BeautifulSoup
1. 初始化并建立一个浏览器对象
import re

import sys

import mechanize

import cookielib

from  bs4 import BeautifulSoup

br = mechanize.Browser()        ##建立浏览器对象

cj = cookielib.LWPCookieJar()   ##通过导入cookielib模块,并设置浏览器cookie,可以在需要认证的网络行为之后不用重复认证登陆

br.set_cookiejar(cj)        ##关联cookies
###设置一些参数,因为是模拟客户端请求,所以要支持客户端的一些常用功能,比如gzip,referer等
br.set_handle_equiv(True)
br.set_handle_gzip(True)
br.set_handle_redirect(True)
br.set_handle_referer(True)
br.set_handle_robots(False)
###这个是degbug##你可以看到他中间的执行过程,对调试代码有帮助
br.set_handle_refresh(mechanize._http.HTTPRefreshProcessor(), max_time=1)
br.set_debug_http(True)
br.set_debug_redirects(True)
br.set_debug_responses(True)
br.addheaders = [('User-agent', 'Mozilla/5.0 (X11; U; Linux i686; en-US; rv:1.9.0.1) Gecko/2008071615 Fedora/3.0.1-1.fc9 Firefox/3.0.1')]
2. 模拟浏览器的行为(获取web网页模拟网站查询)
r = br.open(sys.argv[1])

query = sys.argv[2]

br.select_form(nr=0)

br.form['q'] = query

br.submit()

html = br.response().read()
这里选择的表单是nr=0,可以通过一下方式获取表单信息,从而利用需要的表单号。
for f in br.forms:

    print f
查询词变量是’q’,是通过分析网站的源码获得,如下图
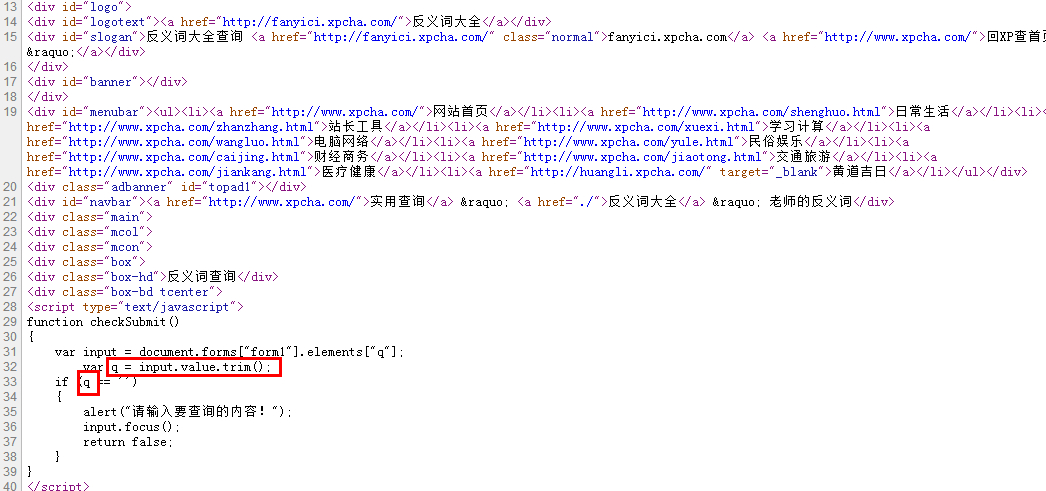
3. 解析需要的内容
这里利用了BeautifulSoup模块,更详细看这里
def parseHtml(html):

    '''

    @summary: 抓取结构化数据

    '''

    content = ""

    wordpattern = '<h1>(.+?)的反义词</h1>'

    pattern = '<span class="medium b">(.+?)</span>'

    temp = re.findall(pattern, html)

    wordtemp = re.search(wordpattern, html)

    if temp:

        word = wordtemp.group(1)

        content = word + '\t'

        for key in temp:

            content += key + '\t'

    content = content.strip('\t')

    return content
这样实现基本的功能可以了,参考代码(文件名为:crawler.py)
#! coding:utf-8

import re

import sys

import mechanize

import cookielib

from  bs4 import BeautifulSoup

def parseHtml(html):

    '''

    @summary: 抓取结构化数据

    '''

    content = ""

    wordpattern = '<h1>(.+?)的反义词</h1>'

    pattern = '<span class="medium b">(.+?)</span>'

    temp = re.findall(pattern, html)

    wordtemp = re.search(wordpattern, html)

    if temp:

        word = wordtemp.group(1)

        content = word + '\t'

        for key in temp:

            content += key + '\t'

    content = content.strip('\t')

    return content

def saveData(data):

    '''

    @summary: 数据存储

    '''

    f = open('test', 'w')

    f.write(data)

    f.close()

br = mechanize.Browser()

cj = cookielib.LWPCookieJar()

br.set_cookiejar(cj)##关联cookies

###设置一些参数,因为是模拟客户端请求,所以要支持客户端的一些常用功能,比如gzip,referer等

br.set_handle_equiv(True)

br.set_handle_gzip(True)

br.set_handle_redirect(True)

br.set_handle_referer(True)

br.set_handle_robots(False)

br.set_handle_refresh(mechanize._http.HTTPRefreshProcessor(), max_time=1)

###这个是degbug##你可以看到他中间的执行过程,对你调试代码有帮助

br.set_debug_http(True)

br.set_debug_redirects(True)

br.set_debug_responses(True)

br.addheaders = [('User-agent', 'Mozilla/5.0 (X11; U; Linux i686; en-US; rv:1.9.0.1) Gecko/2008071615 Fedora/3.0.1-1.fc9 Firefox/3.0.1')]

r = br.open(sys.argv[1])

query = sys.argv[2]

br.select_form(nr=0)

br.form['q'] = query

br.submit()

html = br.response().read()

data = parseHtml(html)

print data

if data != "":

    saveData(data)
使用
python crawler.py 好
说明:最后一个为查询词,最终写到文件”test“中。
参考
http://blog.chinaunix.net/uid-26722078-id-3507409.html
【python爬虫】根据查询词爬取网站返回结果的更多相关文章
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
- python爬虫入门10分钟爬取一个网站
一.基础入门 1.1什么是爬虫 爬虫(spider,又网络爬虫),是指向网站/网络发起请求,获取资源后分析并提取有用数据的程序. 从技术层面来说就是 通过程序模拟浏览器请求站点的行为,把站点返回的HT ...
- 吴裕雄--天生自然PYTHON爬虫:使用Selenium爬取大型电商网站数据
用python爬取动态网页时,普通的requests,urllib2无法实现.例如有些网站点击下一页时,会加载新的内容,但是网页的URL却没有改变(没有传入页码相关的参数),requests.urll ...
随机推荐
- 软件工程随堂小作业——随机四则运算(C++)
一.设计思路: 1.程序的主体部分是循环输出,次数即题目数目由用户输入: 2.三个整型变量+rand函数来实现随机数四则运算,一个变量代表加减乘除,另外两个用作运算数: 3.用户体验:题目分三列,排列 ...
- 小组开发项目针对性的NABC分析
单独就我们团队开发项目——重力解锁的功能特点而言,我们解决了智能手机屏幕解锁的乏味和繁琐的特点,显得更有趣味性和独特性,更符合现代人追随时尚的潮流:我们根据个人的不同喜好和便利性来设定一些动作,利用重 ...
- quartz2D简单使用
quartz2D绘图 1:上下文:context,这个翻译不好理解,其实翻译环境更好一点,就是给了你一个画板,你看不到而已 在: CGContextRef ctx = UIGraphicsGetCur ...
- Grails 1.2参考文档速读(10):Controller
转载:http://keyvalue.blog.51cto.com/1475446/303260 从本篇起,我们将开始进入Grails的Web层,首先让我们从Controller说起. G ...
- 【转载】Extjs 中id与itemId的区别
为了方便表示或是指定一个组件的名称,我们通常会使用id或者itemId进行标识命名.(推荐尽量使用itemId,这样可以减少页面唯一标识而产生的冲突) id: id是作为整个页面的Com ...
- 01.Apache FtpServer配置
1.解压Apache FTPServer 将下载下来的压缩包(ftpserver-1.0.6.zip)解压到本地,其目录结构如下图: 2.修改users.properties 修改 \apache-f ...
- Eclipse支持Jquery代码提示(JqeuryWTP)
问题描述: Eclipse支持Jquery代码提示 问题解决: 下载 JqueryWTP.jar文件 文件替换 在Eclipse/plugin 路径下, ...
- 各大公司广泛使用的在线学习算法FTRL详解
各大公司广泛使用的在线学习算法FTRL详解 现在做在线学习和CTR常常会用到逻辑回归( Logistic Regression),而传统的批量(batch)算法无法有效地处理超大规模的数据集和在线数据 ...
- Python3中的新特性(3)——代码迁移与2to3
1.将代码移植到Python2.6 建议任何要将代码移植到Python3的用户首先将代码移植到Python2.6.Python2.6不仅与Python2.5向后兼容,而且支持Python3中的部分新特 ...
- 设计模式之Builder模式
一.感性认识 二.Builder模式 1.定义 一个复杂对象的构建与其表示相分离,使得同样的构建过程可以创建不同的表示.即构建过程相同,但是子部件却不相同. 2.结构说明 Builder: 创建者接口 ...