
Hive 实战(2)--hive分区分桶实战
前言:
互联网应用, 当Mysql单机遇到性能瓶颈时, 往往采用的优化策略是分库分表. 由于互联网应用普遍的弱事务性, 这种优化效果非常的显著.而Hive作为数据仓库, 当数据量达到一定数量时, 查询性能会有所下降, 那如何利用数据的特点进行优化? 分区分桶作为Hive的优化的一个有力武器.
*). 分区(静态、动态)
Hive没有索引, 查询中一般会扫描整个表内容,会消耗很多时间做没必要的工作。倘若只需要扫描表中关心的一部分数据,因此建表时引入了partition概念。分区表指的是在创建表时指定的partition的分区空间。
1). 静态分区
hive默认采用静态分区, 数据的导入需至少指定一个分区字段
1.1). 创建分区表
CREATE TABLE tb_part_shop (

    shop_id int,

    shop_name string,

    shopkeeper string

) PARTITIONED BY (province_id int, city_id int)

ROW FORMAT DELIMITED

FIELDS TERMINATED BY '\t';
1.2). 描述分区表(describe extended <table_name>)
DESCRIBE EXTENDED tb_part_shop;
> DESCRIBE EXTENDED tb_part_shop;

OK

shop_id int None

shop_name string None

shopkeeper string None

province_id int None

city_id int None

# Partition Information

# col_name data_type comment

province_id int None

city_id int None
1.3). 导入分区和数据
ALTER TABLE tb_part_shop ADD PARTITION (province_id = 1001, city_id = 10001);
数据内容
33068201 Wal-Mart wal-mart
33068202 Carrefour carrefour
LOAD DATA LOCAL INPATH '/path/to/data.txt' INTO TABLE tb_part_shop PARTITION(province_id = 1001, city_id = 10001);
对于小数据量导入, 可采用如下的语句来实现
INSERT INTO VALUES() 等价实现 INSERT INTO TABLE <table_name> SELECT ... FORM <table_name> LIMIT 1;
1.4). 分区表的目录结构
分区表, 在hdfs中的目录结构如图所示: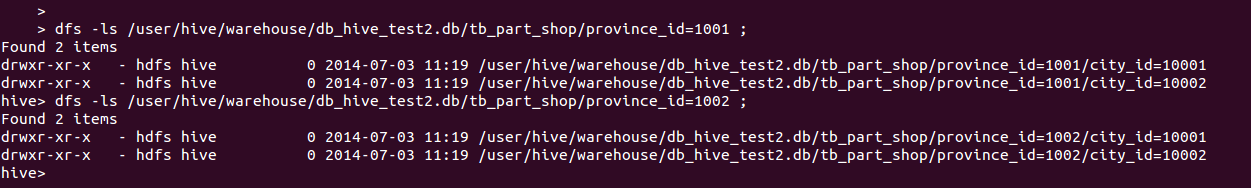
2). 动态分区表
2.1). 设置开启动态分区开关
set hive.exec.dynamic.partition=true;
2.2). 严格模式
set hive.exec.dynamic.partition.mode=strict; # strict/nonstrict
默认为strict, 对于分区表, 若插入语句没有指定至少一个静态分区字段, 则执行失败
如下例子:
set hive.exec.dynamic.partition.mode=strict;
hive> insert into table tb_part_shop select 1, "2haodian", "shopper", 1001, 20012 from tb_user limit 1;
FAILED: SemanticException 1:18 Need to specify partition columns because the destination table is partitioned. Error encountered near token 'tb_part_shop'
2.3). 其他限制条件
set hive.exec.max.dynamic.partitions=3000; # 具体的数值, 表示总共能创建的动态分区数
set hive.exec.max.dynamic.partitions.pernode=1000; # 在mapper/reducer节点中, 允许创建的分区数
SHOW PARTITIONS tb_part_shop;
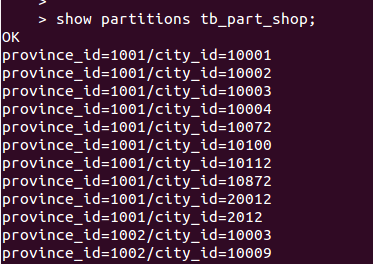
分区适合于字段值可枚举, 离散有限个数值, 比如按时间年/月/日, 省份/市区号编码, 而不适合取值特别多的应用场景, 因为一个值就对应一个目录, 目录无休止的增加对查询的性能, 反而是有害的.
*). 分桶
Hive采用对列值哈希来组织数据的方式, 称之为分桶, 适合采样和map-join.
看看分桶表如何建立
1). 创建分桶表
CREATE TABLE tb_bucket_shop (

    shop_id int,

    shop_name string,

    shopkeeper string

) CLUSTERED BY (shop_id) INTO 4 BUCKETS

ROW FORMAT DELIMITED

FIELDS TERMINATED BY '\t';
2). 数据导入
set hive.enforce.bucketing=true;
INSERT OVERWRITE TABLE tb_bucket_shop SELECT shop_id, shop_name, shopkeeper FROM tb_part_shop CLUSTER BY shop_id;
若没有使用hive.enforce.bucketing属性, 则需要设置和分桶个数相匹配的reducer个数, 同时SELECT后添加CLUSTER BY
set mapred.reduce.tasks=4;
INSERT OVERWRITE TABLE tb_bucket_shop SELECT shop_id, shop_name, shopkeeper FROM tb_part_shop CLUSTER BY shop_id;
分桶适合于sampling, 不过其数据正确的导入到hive表中, 需要用户自己来保证, 因为table中信息仅仅是元数据, 而不影响实际填充表的命令.
总结:
分区分桶是hive性能优化的一个手段, 不同的字段, 其数值属性不同, 其对应的优化方式也不同. 也不能简单的认为分区分桶对应传统关系型数据库的分库分表, 完全不一样.
Hive 实战(2)--hive分区分桶实战的更多相关文章
- 大数据入门第十一天——hive详解(二)基本操作与分区分桶
一.基本操作 1.DDL 官网的DDL语法教程:点击查看 建表语句 CREATE [EXTERNAL] TABLE [IF NOT EXISTS] table_name [(col_name data ...
- hive分区分桶
目录 1.分区 1.1.静态分区 1.1.1.一个分区 1.1.2.多个分区 1.2.动态分区 2.分桶 1.分区 如果一个表中数据很多,我们查询时就很慢,耗费大量时间,如果要查询其中部分数据该怎么办 ...
- 深入浅出Hadoop实战开发(HDFS实战图片、MapReduce、HBase实战微博、Hive应用)
Hadoop是什么,为什么要学习Hadoop? Hadoop是一个分布式系统基础架构,由Apache基金会开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序.充分利用集群的威力高速运 ...
- 【Hive学习之五】Hive 参数&动态分区&分桶
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk8 hadoop-3.1.1 apache-hive-3.1.1 ...
- 大数据开发实战:Hive优化实战2-大表join小表优化
4.大表join小表优化 和join相关的优化主要分为mapjoin可以解决的优化(即大表join小表)和mapjoin无法解决的优化(即大表join大表),前者相对容易解决,后者较难,比较麻烦. 首 ...
- Hive学习笔记——Hive中的分桶
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分.Hive也是针对某一列进行桶的组织.Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记 ...
- Hive动态分区和分桶(八)
Hive动态分区和分桶 1.Hive动态分区 1.hive的动态分区介绍 hive的静态分区需要用户在插入数据的时候必须手动指定hive的分区字段值,但是这样的话会导致用户的操作复杂度提高,而且在 ...
- 《OD大数据实战》Hive入门实例
官方参考文档:https://cwiki.apache.org/confluence/display/Hive/LanguageManual 一.命令行和客户端 1. 命令窗口 1)进入命令窗口 hi ...
- webpack4 中的最新 React全家桶实战使用配置指南!
最新React全家桶实战使用配置指南 这篇文档 是吕小明老师结合以往的项目经验 加上自己本身对react webpack redux理解写下的总结文档,总共耗时一周总结下来的,希望能对读者能够有收获, ...
随机推荐
- query判断值是否为空,针对前台提交数据的校验
1.<input type="hidden" id="key" name="key" value="123"> ...
- exception
SQL> -- 例外 exceptionSQL> -- 1/0SQL> ed已写入 file afiedt.buf 1 declare 2 pnum number := 0; ...
- docker部署tomcat
一.环境简介 宿主机版本:ubuntu-14.04.3-server-amd64.iso JDK版本:jdk-7u76-linux-x64.tar.gz TOMCAT版本:apache-tomcat- ...
- Java面向对象三大特点之封装
封装 含义:将对象的属性和行为封装起来,而将对象的属性和行为封装起来的载体是类,类通常对客户隐藏其实现细节,这就是封装的思想.封装最主要的功能在于我们能修改自己的实现代码,而不用修改那些调用我们代码的 ...
- 微软2017校招笔试题3 registration day
题目 It's H University's Registration Day for new students. There are M offices in H University, numbe ...
- Unsupported major.minor version 51.0解决
http://blog.csdn.net/justdb/article/details/7850212 解决:项目------>右键------>属性------>Java Comp ...
- 再说最后一次!关于不再更新SkySRS的理由!
再说最后一次!关于不再更新SkySRS的理由! https://www.itiankong.net/thread-195937-1-1.html Skyfree 发表于 2012-5-1 14:53: ...
- 亚马逊云服务器AWS安装CentOS
亚马逊云服务器默认创建的实例,在停止之后再启动的情况下,IP会发生改变.所以我们最好先创建一个弹性IP,即EIP,不过我也不清楚这个费用. 1.按如图操作创建一个弹性IP,弹性IP创建之后可以随便绑定 ...
- python——挖装饰器祖坟事件
装饰器是什么呢? 我们先来打一个比方,我写了一个python的插件,提供给用户使用,但是在使用的过程中我添加了一些功能,可是又不希望用户改变调用的方式,那么该怎么办呢? 这个时候就用到了装饰器.装饰器 ...
- mysql 删除重复数据保留一条
验证:mysql 5.6版本 方法一: delete a from table a left join( select (id) from table group by studentName,cla ...