
Lucene之查询索引
Query子类
TermQuery:根据域和关键词进行搜索
 /**

      * termQuery根据域和关键词进行搜索

      */

     @Test

    public  void termQuery() throws IOException {

        //1.创建Directory对象,指定索引库位置

        Directory directory = FSDirectory.open(new File("D:\\Luene资料\\Index").toPath());

        //2.创建IndexReader对象,读取索引库内容

        IndexReader indexReader= DirectoryReader.open(directory);

        //3.创建IndexSearcher对象

        IndexSearcher indexSearcher=new IndexSearcher(indexReader);

        //4.创建Query查询对象

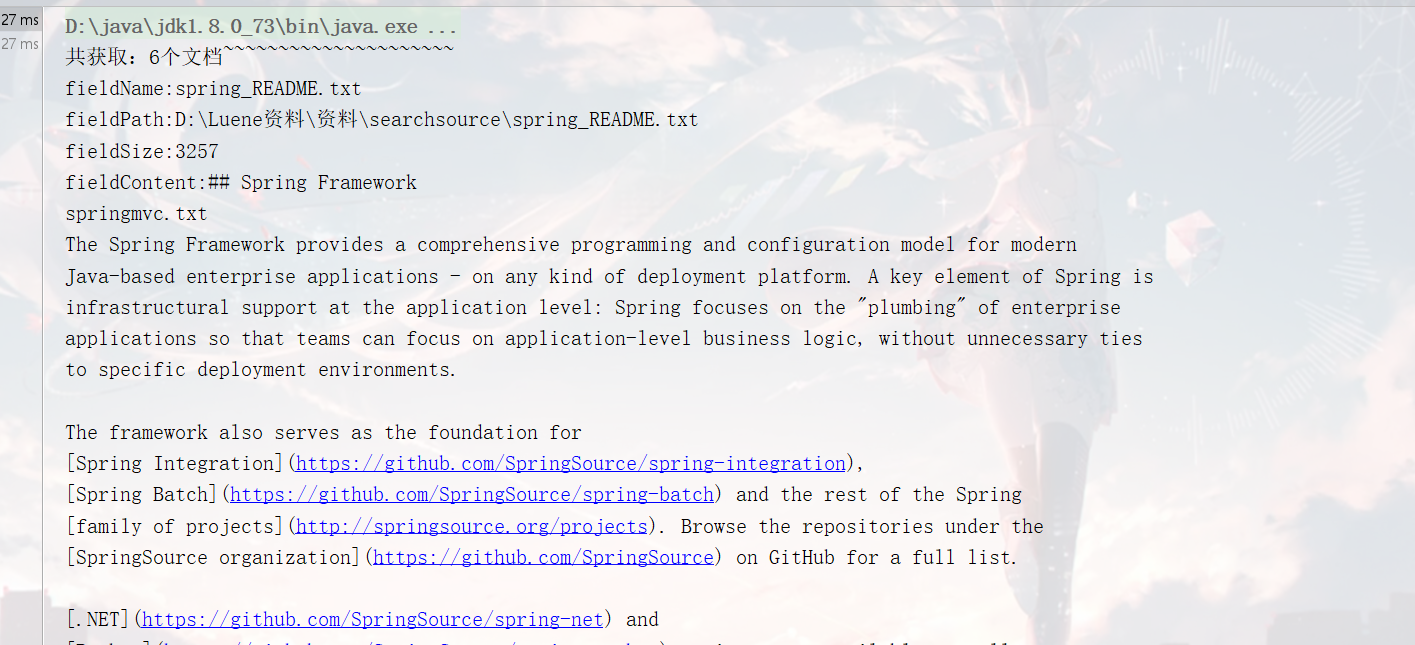
        Query query=new TermQuery(new Term("fieldContent","spring"));

        //5.执行查询,获取到文档对象

        TopDocs topDocs = indexSearcher.search(query, 10);

        System.out.println("共获取:"+topDocs.totalHits+"个文档~~~~~~~~~~~~~~~~~~~~~");

        //6.获取文档列表

        ScoreDoc[] scoreDocs=topDocs.scoreDocs;

        for (ScoreDoc item:scoreDocs) {

            //获取文档ID

            int docId=item.doc;

            //取出文档

            Document doc = indexSearcher.doc(docId);

            //获取到文档域中数据

            System.out.println("fieldName:"+doc.get("fieldName"));

            System.out.println("fieldPath:"+doc.get("fieldPath"));

            System.out.println("fieldSize:"+doc.get("fieldSize"));

            System.out.println("fieldContent:"+doc.get("fieldContent"));

            System.out.println("==============================================================");

        }

        //7.关闭资源

        indexReader.close();

    }
结果
RangeQuery:范围搜索
  /**

      * RangeQuery范围搜素

      */

     @Test

     public void RangeQuery() throws IOException {

         //创建Directory对象,指定索引库位置

         Directory directory = FSDirectory.open(new File("D:\\Luene资料\\Index").toPath());

         //创建IndexReader对象,读取索引库内容

         IndexReader indexReader= DirectoryReader.open(directory);

         //创建IndexSearcher对象

         IndexSearcher indexSearcher=new IndexSearcher(indexReader);

         //设置范围搜索的条件 参数一范围所在的域

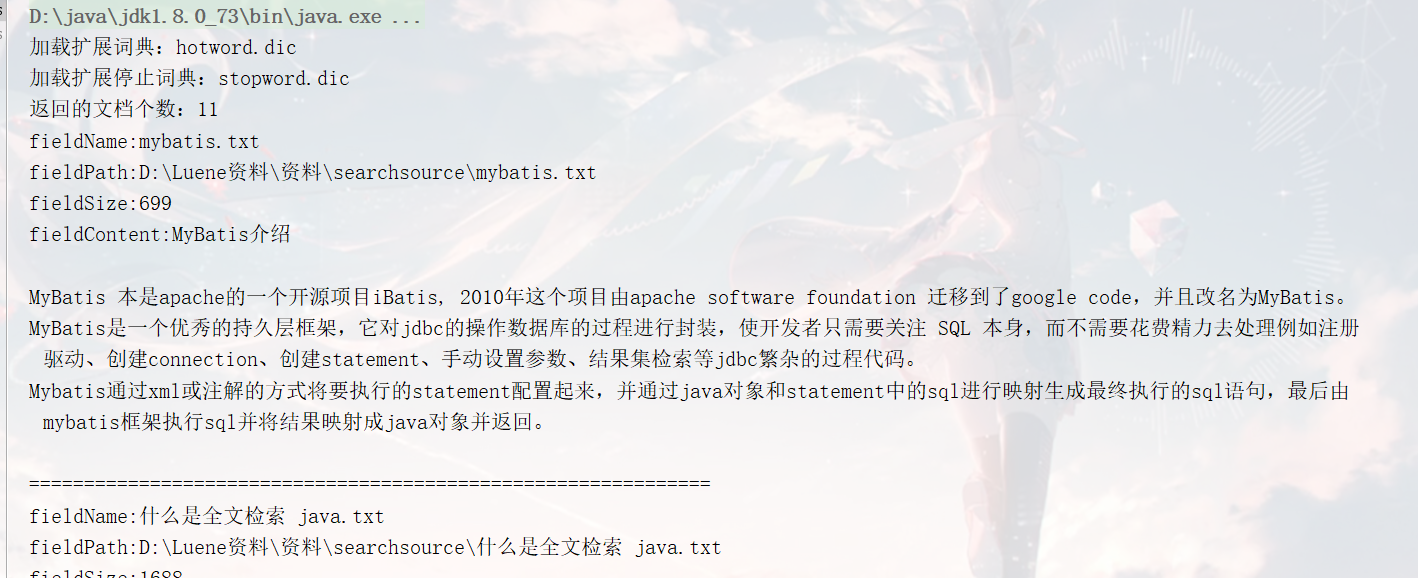
         Query query= LongPoint.newRangeQuery("fieldSize",0,50);

         //查询

         TopDocs topDocs = indexSearcher.search(query, 10);

         System.out.println("返回的文档个数:"+topDocs.totalHits);

         //获取到文档集合

         ScoreDoc [] scoreDocs=topDocs.scoreDocs;

         for (ScoreDoc doc:scoreDocs) {

             //获取到文档

             Document document = indexSearcher.doc(doc.doc);

             //获取到文档域中数据

             System.out.println("fieldName:"+document.get("fieldName"));

             System.out.println("fieldPath:"+document.get("fieldPath"));

             System.out.println("fieldSize:"+document.get("fieldSize"));

             System.out.println("fieldContent:"+document.get("fieldContent"));

             System.out.println("==============================================================");

         }

         //关闭

         indexReader.close();

     }
结果
QueryParser:匹配一行数据,这一行数据会自动进行分词
/**

      * queryparser搜素,会将搜索条件分词

      */

     @Test

     public void queryparser() throws IOException, ParseException {

         //创建Directory对象,指定索引库位置

         Directory directory = FSDirectory.open(new File("D:\\Luene资料\\Index").toPath());

         //创建IndexReader对象,读取索引库内容

         IndexReader indexReader= DirectoryReader.open(directory);

         //创建IndexSearcher对象

         IndexSearcher indexSearcher=new IndexSearcher(indexReader);

         //创建一个QueryParser对象 参数一:查询的域  参数二:使用哪种分析器

         QueryParser parser=new QueryParser("fieldContent",new IKAnalyzer());

         //设置匹配的数据条件

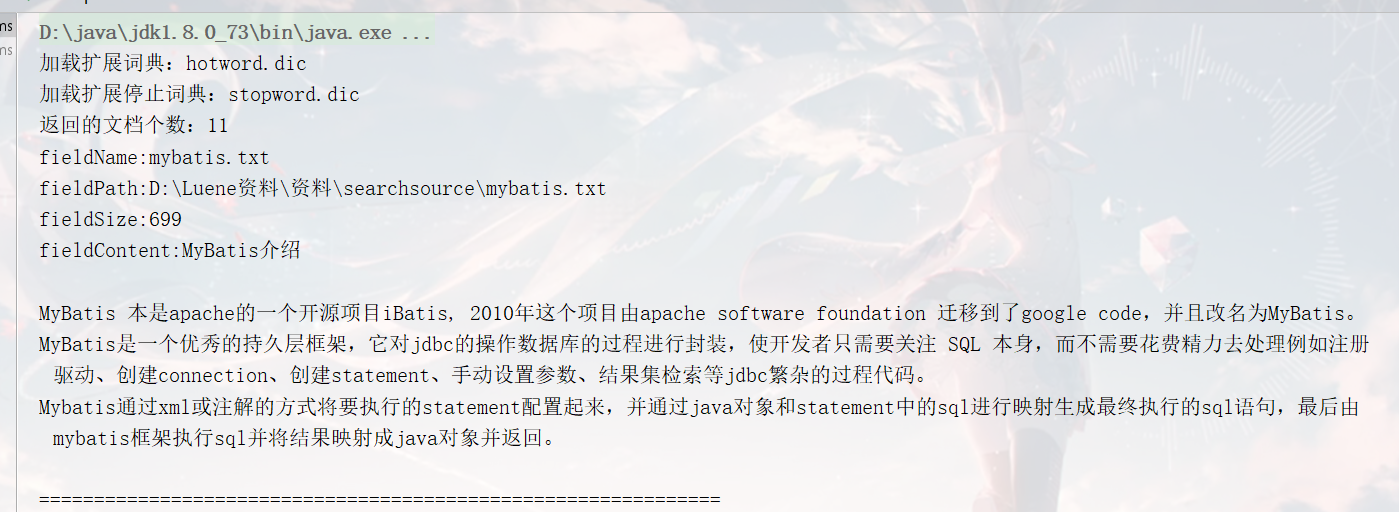
         Query query = parser.parse("Lucene是一个开源的基于Java的搜索库");

         //查询

         TopDocs topDocs = indexSearcher.search(query, 10);

         System.out.println("返回的文档个数:"+topDocs.totalHits);

         //获取到文档集合

         ScoreDoc [] scoreDocs=topDocs.scoreDocs;

         for (ScoreDoc doc:scoreDocs) {

             //获取到文档

             Document document = indexSearcher.doc(doc.doc);

             //获取到文档域中数据

             System.out.println("fieldName:"+document.get("fieldName"));

             System.out.println("fieldPath:"+document.get("fieldPath"));

             System.out.println("fieldSize:"+document.get("fieldSize"));

             System.out.println("fieldContent:"+document.get("fieldContent"));

             System.out.println("==============================================================");

         }

         //关闭

         indexReader.close();

     }
结果
Lucene之查询索引的更多相关文章
- 全文检索Lucene框架---查询索引
一. Lucene索引库查询 对要搜索的信息创建Query查询对象,Lucene会根据Query查询对象生成最终的查询语法,类似关系数据库Sql语法一样Lucene也有自己的查询语法,比如:“name ...
- lucene入门查询索引——(三)
1.用户接口(lucene不提供)
- 搜索引擎学习(三)Lucene查询索引
一.查询理论 创建查询:构建一个包含了文档域和语汇单元的文档查询对象.(例:fileName:lucene) 查询过程:根据查询对象的条件,在索引中找出相应的term,然后根据term找到对应的文档i ...
- Lucene查询索引(分页)
分页查询只需传入每页显示记录数和当前页就可以实现分页查询功能 Lucene分页查询是对搜索返回的结果进行分页,而不是对搜索结果的总数量进行分页,因此我们搜索的时候都是返回前n条记录 package c ...
- Lucene查询索引
索引创建 以新闻文档为例,每条新闻是一个document,新闻有news_id.news_title.news_source.news_url.news_abstract.news_keywords这 ...
- lucene查询索引库、分页、过滤、排序、高亮
2.查询索引库 插入测试数据 xx.xx. index. ArticleIndex @Test public void testCreateIndexBatch() throws Exception{ ...
- 学习笔记CB011:lucene搜索引擎库、IKAnalyzer中文切词工具、检索服务、查询索引、导流、word2vec
影视剧字幕聊天语料库特点,把影视剧说话内容一句一句以回车换行罗列三千多万条中国话,相邻第二句很可能是第一句最好回答.一个问句有很多种回答,可以根据相关程度以及历史聊天记录所有回答排序,找到最优,是一个 ...
- lucene查询索引之QueryParser解析查询——(八)
0.语法介绍:
- lucene查询索引之Query子类查询——(七)
0.文档名字:(根据名字索引查询文档)
随机推荐
- 使用Azure CLI创建Linux虚拟机
Azure提供了三种方式创建虚拟机,分别是Azure CLI.Azure PowerShell和Azure门户.本文介绍使用Azure CLI来创建Linux虚拟机. 使用Azure CLI创建Lin ...
- 龙芯 Fedora 28 设置 VNC
系统为龙芯版Fedora28 (床28) Fedora防火墙默认阻止了VNC所需的端口的访问,导致VNC客户端一直无法连接. 安装VNC Server sudo dnf install tigervn ...
- 面试系列-面试官:你能给我解释一下javascript中的this吗?
一.前言 关于javascript中的this对象,可能已经被大家说烂了. 即使是这样,我依然决定将这篇文章给水出来.毕竟全国在新型肺炎的影响下,公司没法正常复工. 除了刷刷手机,还是要适当的学习一下 ...
- 几种常见的排序方法总结(Python)
几种常见的排序算法总结(Python) 排序算法:是一种能将一串数据依照特定顺序进行排序的一种算法. 稳定性:稳定排序算法会让原本有相等键值的记录维持相对次序.也就是如果一个排序算法是稳定的,当有两个 ...
- Day9-Python3基础-多线程、多进程
1.进程.与线程区别 2.python GIL全局解释器锁 3.线程 语法 join 线程锁之Lock\Rlock\信号量 将线程变为守护进程 Event事件 queue队列 生产者消费者模型 Que ...
- linux--->阿里云centos6.9环境配置安装lnmp
阿里云centos6.9环境配置安装lnmp mysql安装 本人博客:http://www.cnblogs.com/frankltf/p/8615418.html PHP安装 1.安装依赖关系 yu ...
- .net core 认证与授权(一)
前言 .net core web并不是一个非常新的架构,很多文章提及到认证与授权这个过程,但是一般都会提及到里面的方法怎么用的,而不是模拟一个怎样的过程,所以我打算记录自己的理解. 什么是认证?我们大 ...
- Linux下启动/关闭Oracle
一.Linux下启动Oracle Linux下启动Oracle分为两步: 1)启动监听: 2)启动数据库实例: 1.登录服务器,切换到oracle用户,或者以oracle用户登录 [admin@dat ...
- 一份中规中矩的 iOS笔试题
一.背景 因为一些原因,我从公司离职,在此之前,我需要帮忙招聘一个新人来做我的工作,于是就有了这篇文章. 由于公司项目16年就已经上线了,前同事写的项目中,有用xib.storyBoard.代码自动布 ...
- Lambda 表达式入门,看这篇就够了
说出来怕你们不相信,刚接到物业通知,疫情防控升级了,车辆只能出不能进,每户家庭每天可指派 1 名成员上街采购生活用品.这不是谣言,截个图自证清白,出自洛阳市湖北路街道处. 看来事态严峻,这样看似好心, ...