
Python3.5:爬取网站上电影数据
首先我们导入几个pyhton3的库:
from urllib import request
import urllib
from html.parser import HTMLParser
在Python2和Python3之间一个重要区别就是,在Python2有urllib,urllib2两个库,在Python3整合到一起,里面的函数方式也有一点变,先定义一个函数,将header,url,request,都打包成一个函数方便调用,且看下面代码:
def print_movies(url):

    # 伪装成浏览器访问网站,但其实没啥用,很容易被中间件检测出来,但没有又不行,所以蛮写吧

    header = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36'}

    # Python3的urllib

    req = urllib.request.Request(url, headers=header)

    s = urllib.request.urlopen(req)

    parser = MovieParser()

    parser.feed((s.read()).decode('utf-8'))

    s.close()
再重载HTMLParser库的handle_starttag(self, tag, attrs),系统就会默认调用用户重载的,具体调用方式在官方文档里面详细介绍:HTMLParser,
class MovieParser(HTMLParser):

    def __init__(self):

        HTMLParser.__init__(self)

        self.movies = []

        # 重载HTMLParser自带的函数

    def handle_starttag(self, tag, attrs):

        def _attr(attrlist, attrname):

            for attr in attrlist:

                if attr[0] == attrname:

                    return attr[1]

            return None

        # 可以在这class后面找到每个li标签的特征属性比如catrgory在下面判断

        if tag == 'li' and _attr(attrs, 'data-title'):

            movie= {}

            movie['title'] = _attr(attrs, 'data-title')

            movie['rate'] = _attr(attrs, 'data-rate')

            movie['director'] = _attr(attrs, 'data-director')

            movie['actors'] = _attr(attrs, 'data-actors')

            self.movies.append(movie)

            print('%(title)s|%(rate)s|%(director)s|%(actors)s' % movie)
当我们执行到parser.feed((s.read()).decode('utf-8'))时,知道为什么要这样写,首先parser时HTMLParser的子类所以包括feed(),在注入数据时,s.read()是返回bytes类型,但feed()只接受str类型,所以直接在后面加个decode('utf-8')即转码(三个bytes转换为一个中文),又可以转换为str,基本获取数据就这么简单,要是想获取别的网站的数据,可以换个url和条件判断就可以了,我把全部代码贴上来:
from urllib import request

import urllib

from html.parser import HTMLParser

class MovieParser(HTMLParser):

    def __init__(self):

        HTMLParser.__init__(self)

        self.movies = []

        # 重载HTMLParser自带的函数

    def handle_starttag(self, tag, attrs):

        def _attr(attrlist, attrname):

            for attr in attrlist:

                if attr[0] == attrname:

                    return attr[1]

            return None

        # 可以在这class后面找到每个li标签的特征属性比如catrgory在下面判断

        if tag == 'li' and _attr(attrs, 'data-title'):

            movie= {}

            movie['title'] = _attr(attrs, 'data-title')

            movie['rate'] = _attr(attrs, 'data-rate')

            movie['director'] = _attr(attrs, 'data-director')

            movie['actors'] = _attr(attrs, 'data-actors')

            self.movies.append(movie)

            print('%(title)s|%(rate)s|%(director)s|%(actors)s' % movie)

def print_movies(url):

    # 伪装成浏览器访问网站,但其实没啥用,很容易被中间件检测出来,但没有又不行,所以蛮写吧

    header = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36'}

    # Python3的urllib

    req = urllib.request.Request(url, headers=header)

    s = urllib.request.urlopen(req)

    parser = MovieParser()

    parser.feed((s.read()).decode('utf-8'))

    s.close()

if __name__ == '__main__':

    url = 'https://movie.douban.com/'

    # 返回一个电影列表

    print_movies(url)
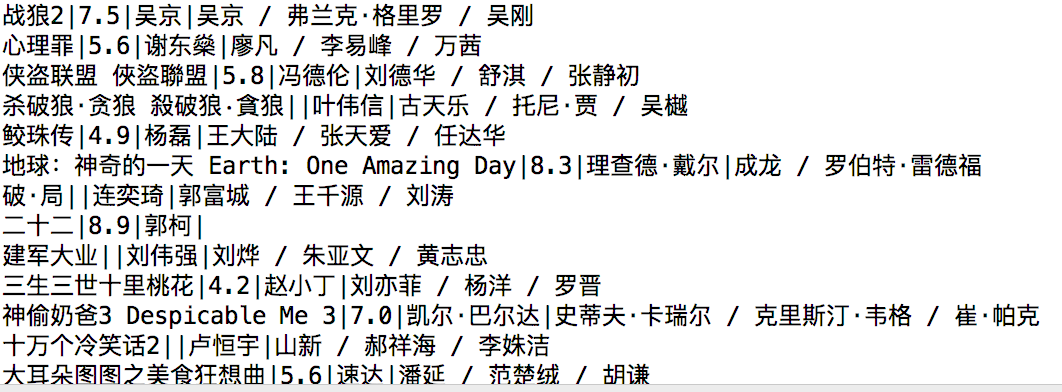
运行结果为:
Python3.5:爬取网站上电影数据的更多相关文章
- Python爬取网站上面的数据很简单,但是如何爬取APP上面的数据呢
- 使用scrapy爬取网站的商品数据
目标是爬取网站http://www.muyingzhijia.com/上全部的商品数据信息,包括商品的一级类别,二级类别,商品title,品牌,价格. 搜索了一下,python的scrapy是一个不错 ...
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
- 使用Selenium爬取网站表格类数据
本文转载自一下网站:Python爬虫(5):Selenium 爬取东方财富网股票财务报表 https://www.makcyun.top/web_scraping_withpython5.html 需 ...
- C# 爬取网页上的数据
最近工作中需求定时爬取不同城市每天的温度.其实就是通过编程的方法去抓取不同网站网页进行分析筛选的过程..NET提供了很多类去访问并获得远程网页的数据,比如WebClient类和HttpWebReque ...
- Python3爬虫爬取淘宝商品数据
这次的主要的目的是从淘宝的搜索页面获取商品的信息.其实分析页面找到信息很容易,页面信息的存放都是以静态的方式直接嵌套的页面上的,很容易找到.主要困难是将信息从HTML源码中剥离出来,数据和网页源码结合 ...
- python3 requests_html 爬取智联招聘数据(简易版)
PS重点:我回来了-----我回来了-----我回来了 1. 基础需要: python3 基础 html5 CS3 基础 2.库的选择: 原始库 urllib2 (这个库早些年的用过,后来淡忘了) ...
- python 实现爬取网站下所有URL
python3 实现爬取网站下所有URL 获取首页元素信息: 首页的URL链接获取: 遍历第一次返回的结果: 递归循环遍历: 全部代码如下: 小结: python3.6 requests && ...
- Python转页爬取某铝业网站上的数据
天行健,君子以自强不息:地势坤,君子以厚德载物! 好了废话不多说,正式进入主题,前段时间应朋友的请求,爬取了某铝业网站上的数据.刚开始呢,还是挺不愿意的(主要是自己没有完整的爬取过网上的数据哎,即是不 ...
随机推荐
- openvpn部署之快速入门实战+一键部署openvpn脚本
个人原创禁止转载 软件环境: Centos6.9 x64 openvpn-2.4.3-1.el6.x86_64.rpm easy-rsa-2.2.2-1.el6.noarch.rpm #推荐使用 ...
- 开始python成长之路
因为某种特殊原因很不幸的得了脱髓鞘 正要去实习 大展身手 甚至公司都选好了 可就在这个节骨眼..得了传说中的脱髓鞘.经过一年的修养 我决定还是要站起来 毕竟一生的时间很长 这一段时间 我都在玩游戏赚钱 ...
- 超级有用的Vim命令
你是否曾经烦恼,每次编辑vim文件,想要跳到一行结尾,需要按多次右键,每次想找到某个字符的位置,都得用肉眼去观察,每次想跳到文件结尾,都要按多次向下键.现在,你不必担心这些繁杂的过程,因为我们完全可以 ...
- 《Flask Web开发——基于Python的Web应用开发实践》一字一句上机实践(上)
目录 前言 第1章 安装 第2章 程序的基本结构 第3章 模板 第4章 Web表单 第5章 数据库 第6章 电子邮件 第7章 大型程序的结构 前言 学习Python也有一个半月时间了,学到现在感觉 ...
- ##5.1 Nova控制节点-- openstack pike
##5.1 Nova控制节点 openstack pike 安装 目录汇总 http://www.cnblogs.com/elvi/p/7613861.html ##5.1 Nova控制节点 # co ...
- 负载均衡之nginx
什么是负载均衡负载均衡(Load Balance)是分布式系统架构设计中必须考虑的因素之一,它通常是指,将请求/数据[均匀]分摊到多个操作单元上执行,负载均衡的关键在于[均匀].在使用nginx负载均 ...
- 分享一个好用的微信npmjs包
https://www.npmjs.com/package/jquery_wechat_sdk 安装 $ npm install jquery_wechat_sdk 使用 Browser Script ...
- Gitlab一键端的安装汉化及问题解决(2017/12/14目前版本为10.2.4)
Gitlab的安装汉化及问题解决 一.前言 Gitlab需要安装的包太TM多了,源码安装能愁死个人,一直出错,后来发现几行命令就装的真是遇到的新大陆一样... ... 装完之后感觉太简单,加了汉化补丁 ...
- python之 json里字典中的value去重
import simplejson as json with open(r'C:\Users\Desktop\test.txt', 'r' ) as f1, open(r'C:\Users\Deskt ...
- selenium webdriver使用click一直失效问题的几种解决方法
想要爬取动态网页,很莫名的click失效.被这个问题困扰了很久,基本上把网上提到的所有方法试遍了,最终终于有个方法成功了,在这里总结一下. 这是我想要点击的网页,初始时实在0.5km上,它的class ...