
【机器学习】--线性回归中L1正则和L2正则
一、前述
L1正则,L2正则的出现原因是为了推广模型的泛化能力。相当于一个惩罚系数。
二、原理
L1正则:Lasso Regression
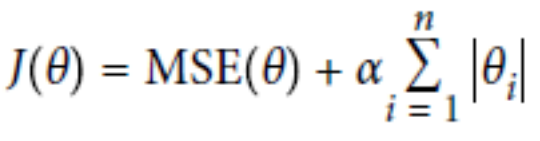
L2正则:Ridge Regression

总结:
经验值 MSE前系数为1 ,L1 , L2正则前面系数一般为0.4~0.5 更看重的是准确性。
L2正则会整体的把w变小。
L1正则会倾向于使得w要么取1,要么取0 ,稀疏矩阵 ,可以达到降维的角度。
ElasticNet函数(把L1正则和L2正则联合一起):

总结:
1.默认情况下选用L2正则。
2.如若认为少数特征有用,可以用L1正则。
3.如若认为少数特征有用,但特征数大于样本数,则选择ElasticNet函数。
代码一:L1正则
# L1正则

import numpy as np

from sklearn.linear_model import Lasso

from sklearn.linear_model import SGDRegressor

X = 2 * np.random.rand(100, 1)

y = 4 + 3 * X + np.random.randn(100, 1)

lasso_reg = Lasso(alpha=0.15)

lasso_reg.fit(X, y)

print(lasso_reg.predict(1.5))

sgd_reg = SGDRegressor(penalty='l1')

sgd_reg.fit(X, y.ravel())

print(sgd_reg.predict(1.5))
代码二:L2正则
# L2正则

import numpy as np

from sklearn.linear_model import Ridge

from sklearn.linear_model import SGDRegressor

X = 2 * np.random.rand(100, 1)

y = 4 + 3 * X + np.random.randn(100, 1)

#两种方式第一种岭回归

ridge_reg = Ridge(alpha=1, solver='auto')

ridge_reg.fit(X, y)

print(ridge_reg.predict(1.5))#预测1.5的值

#第二种 使用随机梯度下降中L2正则

sgd_reg = SGDRegressor(penalty='l2')

sgd_reg.fit(X, y.ravel())

print(sgd_reg.predict(1.5))
代码三:Elastic_Net函数
# elastic_net函数

import numpy as np

from sklearn.linear_model import ElasticNet

from sklearn.linear_model import SGDRegressor

X = 2 * np.random.rand(100, 1)

y = 4 + 3 * X + np.random.randn(100, 1)

#两种方式实现Elastic_net

elastic_net = ElasticNet(alpha=0.1, l1_ratio=0.5)

elastic_net.fit(X, y)

print(elastic_net.predict(1.5))

sgd_reg = SGDRegressor(penalty='elasticnet')

sgd_reg.fit(X, y.ravel())

print(sgd_reg.predict(1.5))
【机器学习】--线性回归中L1正则和L2正则的更多相关文章
- 【机器学习】--鲁棒性调优之L1正则,L2正则
一.前述 鲁棒性调优就是让模型有更好的泛化能力和推广力. 二.具体原理 1.背景 第一个更好,因为当把测试集带入到这个模型里去.如果测试集本来是100,带入的时候变成101,则第二个模型结果偏差很大, ...
- 贝叶斯先验解释l1正则和l2正则区别
这里讨论机器学习中L1正则和L2正则的区别. 在线性回归中我们最终的loss function如下: 那么如果我们为w增加一个高斯先验,假设这个先验分布是协方差为 的零均值高斯先验.我们在进行最大似然 ...
- L1正则和L2正则的比较分析详解
原文链接:https://blog.csdn.net/w5688414/article/details/78046960 范数(norm) 数学上,范数是一个向量空间或矩阵上所有向量的长度和大小的求和 ...
- L1正则与L2正则
L1正则是权值的绝对值之和,重点在于可以稀疏化,使得部分权值等于零. L1正则的含义是 ∥w∥≤c,如下图就可以解释为什么会出现权值为零的情况. L1正则在梯度下降的时候不可以直接求导,可以有以下几种 ...
- L1 正则 和 L2 正则的区别
L1,L2正则都可以看成是 条件限制,即 $\Vert w \Vert \leq c$ $\Vert w \Vert^2 \leq c$ 当w为2维向量时,可以看到,它们限定的取值范围如下图: 所以它 ...
- 大白话5分钟带你走进人工智能-第十四节过拟合解决手段L1和L2正则
第十四节过拟合解决手段L1和L2正则 第十三节中, ...
- 大白话5分钟带你走进人工智能-第十五节L1和L2正则几何解释和Ridge,Lasso,Elastic Net回归
第十五节L1和L2正则几何解释和Ridge,Lasso,Elastic Net回归 上一节中我们讲解了L1和L2正则的概念,知道了L1和L2都会使不重要的维度权重下降得多,重要的维度权重下降得少,引入 ...
- 机器学习中L1,L2正则化项
搞过机器学习的同学都知道,L1正则就是绝对值的方式,而L2正则是平方和的形式.L1能产生稀疏的特征,这对大规模的机器学习灰常灰常重要.但是L1的求解过程,实在是太过蛋疼.所以即使L1能产生稀疏特征,不 ...
- Spark2.0机器学习系列之12: 线性回归及L1、L2正则化区别与稀疏解
概述 线性回归拟合一个因变量与一个自变量之间的线性关系y=f(x). Spark中实现了: (1)普通最小二乘法 (2)岭回归(L2正规化) (3)La ...
随机推荐
- Docker 学习4 Docker容器虚拟化网络概述
一.docker 虚拟化网络概述 1.OVS: OpenVSwitch,不仅能模拟二层网络,还能模拟三层网络,或者VLAN,VXLAN,流控 SDN软件定义网络技术等. 2.overlay netwo ...
- 我把一些Linux的中英文命令做了对应翻译大家参考一下
本文我们把Linux的中英文命令做了对应翻译,给需要的朋友参考一下.(http://wap.0834jl.com) 很多朋友在论坛上找Linux英文命令,我们给大家整理了比较全的Linux英文命令,并 ...
- 记录几个爬取动态网页时的问题(下拉框,旧的元素无法获取,获取的源代码和f12看到的不一致,爬取延迟)
更新.....这个动态网页其实直接抓取ajax请求就可以了,很简单,我之前想复杂了,虽然也实现了,但是效率极低,不过没关系,就当作是对Selenium的一次学习吧 1.最近在爬取一个动态网页,其中为了 ...
- 关于Selenium3+python3.6自动化测试中iframe切换
本篇内容主要表述以下几个问题: 1.iframe 这个是什么? 2.定位iframe 标签时遇到的几个报错总结. 3.显示等待与隐示等待的原理与优缺点. 4.无name,ID可变情况下的处理方式 5. ...
- 随机生成UserAgent包之fake-useragent
一.安装 pip install fake-usragent 二.使用 .导包 from fake-useragent import UserAgent .实例化 ua = UserAgent() . ...
- 解析时间parse time
下面是一个解析时间的一个类 <?php /** * @purpose : 解析时间 * author: 袋鼠 * date: 2019/3/1 * time: 19:43 */ class Pa ...
- 关系数据库数据与hadoop数据进行转换的工具 - Sqoop
Sqoop 本文所使用的Sqoop版本为1.4.6 1.官网 http://sqoop.apache.org 2.作用 A:可以把hadoop数据导入到关系数据库里面(e.g. Hive -> ...
- python练习题目
1.查看本机安装python版本 2.用python打印"Hello World",给出源代码和执行结果 a.命令行窗口输出(前提:python程序加入PATH系统环境变量) b. ...
- Vue(二十九)页面加载过慢问题
1.使用按需加载 2.路由懒加载
- spark streaming中维护kafka偏移量到外部介质
spark streaming中维护kafka偏移量到外部介质 以kafka偏移量维护到redis为例. redis存储格式 使用的数据结构为string,其中key为topic:partition, ...