
hiveserver2和zookeeper的HA搭建(转)
最近公司新项目申请资源,虚拟机资源打开时候使用source login.sh的脚本来进行登录注册,好奇心驱使下看了看里面的shell脚本,使用到了hiveserver2的zookeeper连接,百度一下找了篇博客学习一下;
转自:https://blog.csdn.net/qq_30950329/article/details/78024282
在生产环境中使用Hive,强烈建议使用HiveServer2来提供服务,好处很多:
1. 在应用端不用部署Hadoop和Hive客户端;
2. 相比hive-cli方式,HiveServer2不用直接将HDFS和Metastore暴漏给用户;
3. 有安全认证机制,并且支持自定义权限校验;
4. 有HA机制,解决应用端的并发和负载均衡问题;
5. JDBC方式,可以使用任何语言,方便与应用进行数据交互;
6. 从2.0开始,HiveServer2提供了WEB UI。
如果使用HiveServer2的Client并发比较少,可以使用一个HiveServer2实例,没问题。

但如果这一个实例挂掉,那么会导致所有的应用连接失败。
Hive从0.14开始,使用Zookeeper实现了HiveServer2的HA功能(ZooKeeper Service Discovery),Client端可以通过指定一个nameSpace来连接HiveServer2,而不是指定某一个host和port。本文学习和研究HiveServer2的高可用配置。使用的Hive版本为apache-hive-2.0.0-bin。
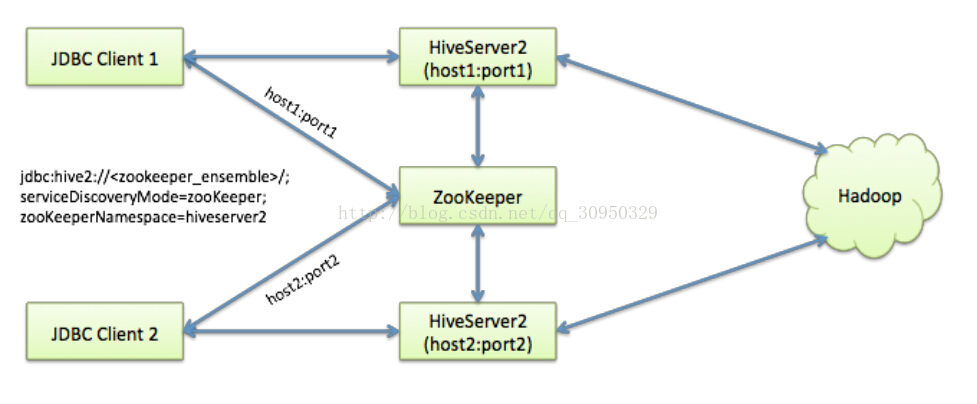
如上图,我准备在node1和node2上分别启用两个HiveServer2的实例,并通过zookeeper完成HA的配置。
Hive配置
注:这里假设你的Zookeeper已经安装好,并可用。
在两个安装了apache-hive-2.0.0-bin的机器上,分别编辑hive-site.xml,添加以下参数:
- <property>
- <name>hive.server2.support.dynamic.service.discovery</name>
- <value>true</value>
- </property>
- <property>
- <name>hive.server2.zookeeper.namespace</name>
- <value>hiveserver2_zk</value>
- </property>
- <property>
- <name>hive.zookeeper.quorum</name>
- <value> zkNode1:2181,zkNode2:2181,zkNode3:2181</value>
- </property>
- <property>
- <name>hive.zookeeper.client.port</name>
- <value>2181</value>
- </property>
- <property>
- <name>hive.server2.thrift.bind.host</name>
- <value>0.0.0.0</value>
- </property>
- <property>
- <name>hive.server2.thrift.port</name>
- <value>10001</value> //两个HiveServer2实例的端口号要一致
- </property>
先启动第一个HiveServer2 :
cd $HIVE_HOME/bin
./hiveserver2
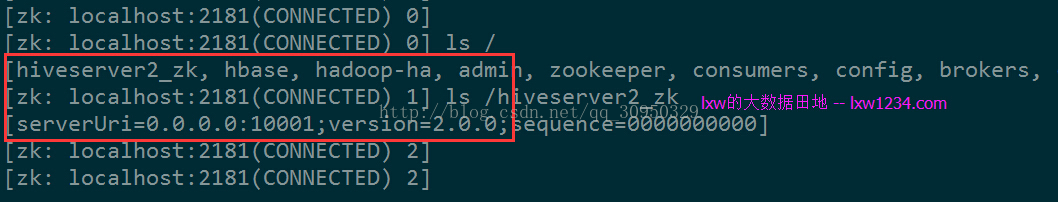
再启动另一个:

第二个实例启动后,ZK中可以看到两个都注册上来。
JDBC连接
JDBC连接的URL格式为:
jdbc:hive2://<zookeeper quorum>/<dbName>;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2
其中:
<zookeeper quorum> 为Zookeeper的集群链接串,如zkNode1:2181,zkNode2:2181,zkNode3:2181
<dbName> 为Hive数据库,默认为default
serviceDiscoveryMode=zooKeeper 指定模式为zooKeeper
zooKeeperNamespace=hiveserver2 指定ZK中的nameSpace,即参数hive.server2.zookeeper.namespace所定义,我定义为hiveserver2_zk
使用beeline测试连接:
- cd $HIVE_HOME/bin
- ./beeline
- !connect jdbc:hive2://zkNode1:2181,zkNode2:2181,zkNode3:2181/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2_zk liuxiaowen ""
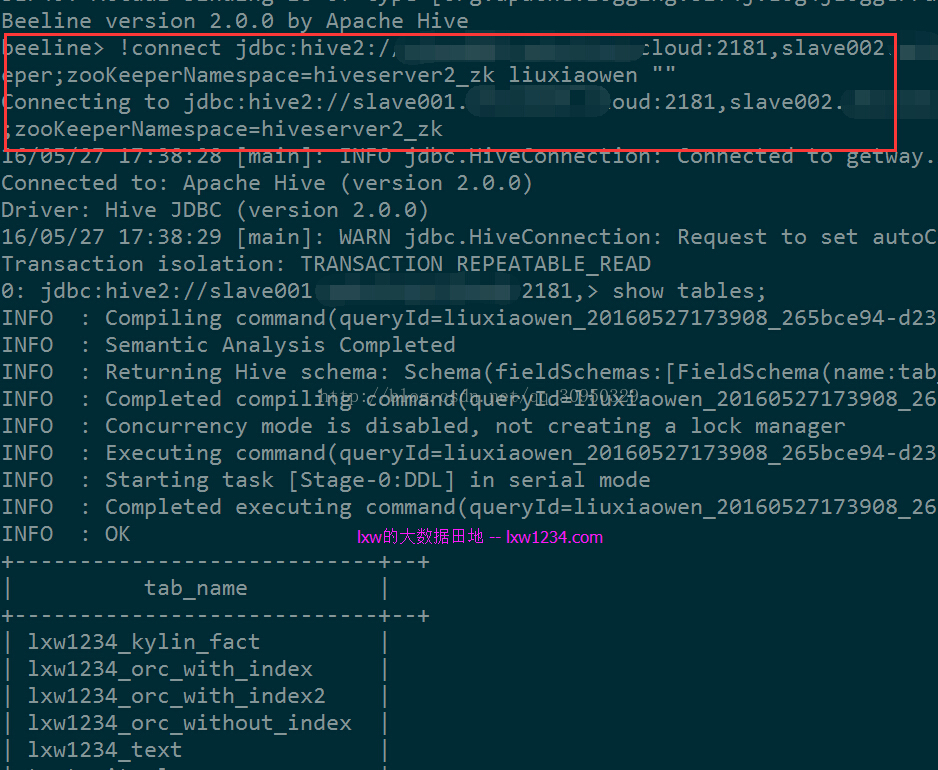
可以正常连接。
执行一个HQL查询,日志中显示连接到的HiveServer2实例为Node2,停掉Node2中的HiveServer2实例后,需要重新使用!connect命令连接,之后可以继续正常执行查询,日志显示连接到了Node1中的实例。
关于Hadoop2中的用户权限认证
本例中两个HiveServer2实例均使用普通用户liuxiaowen启动,
刚开始使用beeline链接时候报错:
1. Error: Failed to open new session:
2. java.lang.RuntimeException: org.apache.hadoop.ipc.RemoteException(org.apache.hadoop.security.authorize.AuthorizationException):
3. User: liuxiaowen is not allowed to impersonate liuxiaowen (state=,code=0)
这是由于Hadoop2中的用户权限认证导致的。
参考资料:
https://hadoop.apache.org/docs/current/hadoop-project-dist/hadoop-common/Superusers.html
http://dongxicheng.org/mapreduce-nextgen/hadoop-secure-impersonation/
解决办法:
在Hadoop的core-site.xml中增加配置:
- <property>
- <name>hadoop.proxyuser.liuxiaowen.groups</name>
- <value>*</value>
- </property>
- <property>
- <name>hadoop.proxyuser.liuxiaowen.hosts</name>
- <value>*</value>
- </property>
其中 liuxiaowen 为启动HiveServer2的用户。
使用超级用户hadoop刷新配置:
yarn rmadmin -refreshSuperUserGroupsConfiguration
hdfs dfsadmin -refreshSuperUserGroupsConfiguration
如果是对namenode做过HA,则需要在主备namenode上执行:
hdfs dfsadmin -fs hdfs://cdh5 -refreshSuperUserGroupsConfiguration
之后问题解决,后续再详细研究这块。
至此,HiveServer2的多实例高可用-Ha配置完成,的确能解决生产中的很多问题,比如:并发、负载均衡、单点故障、安全等等。
因此强烈建议在生产环境中使用该模式来提供Hive服务。
hiveserver2和zookeeper的HA搭建(转)的更多相关文章
- Spark集群基于Zookeeper的HA搭建部署笔记(转)
原文链接:Spark集群基于Zookeeper的HA搭建部署笔记 1.环境介绍 (1)操作系统RHEL6.2-64 (2)两个节点:spark1(192.168.232.147),spark2(192 ...
- ActiveMQ笔记(2):基于ZooKeeper的HA方案
activemq官网给出了3种master/slave的HA方案,详见:http://activemq.apache.org/masterslave.html,基于共享文件目录,db,zookeepe ...
- ZooKeeper一二事 - 搭建ZooKeeper伪分布式及正式集群 提供集群服务
集群真是好好玩,最近一段时间天天搞集群,redis缓存服务集群啦,solr搜索服务集群啦,,,巴拉巴拉 今天说说zookeeper,之前搭建了一个redis集群,用了6台机子,有些朋友电脑跑步起来,有 ...
- HBase HA + Hadoop HA 搭建
HBase 使用的是 1.2.9 的版本. Hadoop HA 的搭建见我的另外一篇:Hadoop 2.7.3 HA 搭建及遇到的一些问题 以下目录均为 HBase 解压后的目录. 1. 修改 co ...
- hadoop HA + HBase HA搭建:
hadoop HA搭建参考:https://www.cnblogs.com/NGames/p/11083640.html (本节:用不到YARN 所以可以不用考虑部署YARN部分) Hadoop 使用 ...
- Spark HA搭建
正文 下载Spark版本,这版本又要求必须和jdk与hadoop版本对应. http://spark.apache.org/downloads.html tar -zxvf 解压到指定目录,进入con ...
- 分布式架构中一致性解决方案——Zookeeper集群搭建
当我们的项目在不知不觉中做大了之后,各种问题就出来了,真jb头疼,比如性能,业务系统的并行计算的一致性协调问题,比如分布式架构的事务问题, 我们需要多台机器共同commit事务,经典的案例当然是银行转 ...
- kafka学习(二)-zookeeper集群搭建
zookeeper概念 ZooKeeper是一个分布式的,开放源码的分布式应用程序协调服务,它包含一个简单的原语集,分布式应用程序可以基于它实现同步服务,配置维护和命名 服务等.Zookeeper是h ...
- [ZooKeeper] 2 环境搭建
上一篇中我们介绍了 ZooKeeper 的一些基本概念,这篇我们讲一下 ZooKeeper 的环境搭建. ZooKeeper 安装模式 单机模式:ZooKeeper 运行在一台服务器上,适合测试环境: ...
随机推荐
- Spring JDBC最佳实践(3)
原文地址:https://my.oschina.net/u/218421/blog/38598 spring jdbc包提供了JdbcTemplate和它的两个兄弟SimpleJdbcTemplate ...
- javascript中的each遍历
each的用法 1.数组中的each 复制代码 var arr = [ "one", "two", "three", "four ...
- python 关于celery的异步任务队列的基本使用(celery+redis)【采用配置文件设置】
工程结构说明:源文件下载请访问https://i.cnblogs.com/Files.aspx __init__.py:实例化celery,并加载配置模块 celeryconfig.py:配置模块 t ...
- Akka-CQRS(12)- akka-http for http-web-service: Routing-服务项目接口
上篇提到,按当前对web-service功能需要,我们需要完成数据转换marshalling,服务接口routing这两部分的调研和示范.上篇已经完成了对序列化marshalling的讨论,这篇就介绍 ...
- ubuntu docker inflxudb(安装 使用 备份 还原 以及python编码) telegraf Grafana
inflxudb1.7.7 1.拉取最新的镜像 docker pull influxdb 2.运行实例: docker run -d --restart=always -p 8086:8086 -p ...
- trie、FSA、FST(转)
add by zhj: 在学习Lucene的存储结构时,看到其使用了FST,这篇文章写的不错. trie,FSA,FST都是用来解决有限状态机的存储,trie是树,它进一步演化为FSA和FST,这两者 ...
- FusionInsight大数据开发---Spark应用开发
Spark应用开发 要求: 了解Spark基本原理 搭建Spark开发环境 开发Spark应用程序 调试运行Spark应用程序 YARN资源调度,可以和Hadoop集群无缝对接 Spark适用场景大多 ...
- .Net Core 指定编码格式的问题
我们在读取txt文件时,如果文件格式不是utf8,则获取的中文会乱码,所以要么另存文件为utf8格式,要么使用和文件相同的编码来读取. 如果文件为utf8,则: //一种 StreamReader s ...
- .NET / C# HTTP中的GET和PSOT
需要引入using System.IO;using System.Net; public string GETs(string URL) { //创建httpWebRequest对象 HttpWebR ...
- 类型和变量(C#学习笔记02)
类型和变量 [C#类型和变量(原文参考官方教程)]https://docs.microsoft.com/zh-cn/dotnet/csharp/tour-of-csharp/types-and-var ...