
Java 抓取网页中的内容【持续更新】
背景:前几天复习Java的时候看到URL类,当时就想写个小程序试试,迫于考试没有动手,今天写了下,感觉还不错
内容1. 抓取网页中的URL
知识点:Java URL+ 正则表达式
 import java.io.BufferedReader;

 import java.io.InputStreamReader;

 import java.net.URL;

 import java.util.regex.Matcher;

 import java.util.regex.Pattern;

 public class URLReader {

     public static void main(String[] args) throws Exception {

         System.out.println("开始!");

         Pattern pattern = Pattern.compile("http(s)?://([\\w-]+\\.)+[\\w-]+(/[\\w- ./?%&=]*)?");

         URL baidu = new URL("http://www.cnblogs.com/A--Q/");

         BufferedReader br = new BufferedReader(new InputStreamReader(baidu.openStream(), "utf-8"));

         String inputLine;

         while ((inputLine = br.readLine()) != null) {

             Matcher matcher = pattern.matcher(inputLine);

             while (matcher.find()) {

                 System.out.println(matcher.group(0));

             }

         }

         br.close();

         System.out.println("程序执行结束!");

     }

 }
效果:
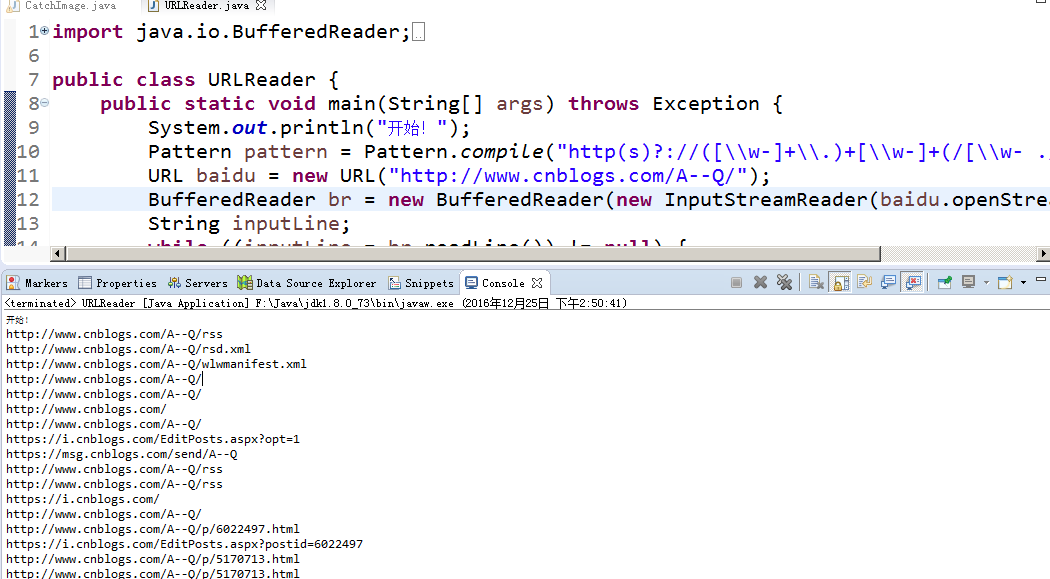
内容2. 抓取网页中的图片
 import java.io.File;

 import java.io.FileOutputStream;

 import java.io.InputStream;

 import java.net.URL;

 import java.net.URLConnection;

 import java.util.ArrayList;

 import java.util.List;

 import java.util.regex.Matcher;

 import java.util.regex.Pattern;

 public class CatchImage {

     private static final String URL = "http://www.cnblogs.com/A--Q/p/5170713.html";

     private static final String ECODING = "UTF-8";

     private static final String IMGURL_REG = "<img.*src=(.*?)[^>]*?>";

     private static final String IMGSRC_REG = "http:\"?(.*?)(\"|>|\\s+)";

     public static void main(String[] args) throws Exception {

         System.out.println("start");

         CatchImage cm = new CatchImage();

         String HTML = cm.getHTML(URL);

         List<String> imgUrl = cm.getImageUrl(HTML);

         List<String> imgSrc = cm.getImageSrc(imgUrl);

         cm.Download(imgSrc);

         System.out.println("END");

     }

     private String getHTML(String url) throws Exception {

         URL uri = new URL(url);

         URLConnection connection = uri.openConnection();

         InputStream in = connection.getInputStream();

         byte[] buf = new byte[1024];

         int length = 0;

         StringBuffer sb = new StringBuffer();

         while ((length = in.read(buf, 0, buf.length)) > 0) {

             sb.append(new String(buf, ECODING));

         }

         in.close();

         return sb.toString();

     }

     private List<String> getImageUrl(String HTML) {

         Matcher matcher = Pattern.compile(IMGURL_REG).matcher(HTML);

         List<String> listImgUrl = new ArrayList<String>();

         while (matcher.find()) {

             listImgUrl.add(matcher.group());

         }

         return listImgUrl;

     }

     private List<String> getImageSrc(List<String> listImageUrl) {

         List<String> listImgSrc = new ArrayList<String>();

         for (String image : listImageUrl) {

             Matcher matcher = Pattern.compile(IMGSRC_REG).matcher(image);

             while (matcher.find()) {

                 listImgSrc.add(matcher.group().substring(0, matcher.group().length() - 1));

             }

         }

         return listImgSrc;

     }

     private void Download(List<String> listImgSrc) {

         try {

             for (String url : listImgSrc) {

                 String imageName = url.substring(url.lastIndexOf("/") + 1, url.length());

                 URL uri = new URL(url);

                 InputStream in = uri.openStream();

                 FileOutputStream fo = new FileOutputStream(new File(imageName));

                 byte[] buf = new byte[1024];

                 int length = 0;

                 System.out.println("开始下载:" + url);

                 while ((length = in.read(buf, 0, buf.length)) != -1) {

                     fo.write(buf, 0, length);

                 }

                 in.close();

                 fo.close();

                 System.out.println(imageName + "下载完成");

             }

         } catch (Exception e) {

             System.out.println("下载失败");

         }

     }

 }
Java 抓取网页中的内容【持续更新】的更多相关文章
- php抓取网页中的内容
以下就是几种常用的用php抓取网页中的内容的方法.1.file_get_contentsPHP代码代码如下:>>>>>>>>>>>&g ...
- 走过路过不要错过~教你用java抓取网页中你想要的东东~~
学习了正则之后,打算用java玩一玩,所以就决定用它来实现一个好玩的idea import java.io.BufferedReader; import java.io.IOException; im ...
- java抓取网页数据,登录之后抓取数据。
最近做了一个从网络上抓取数据的一个小程序.主要关于信贷方面,收集的一些黑名单网站,从该网站上抓取到自己系统中. 也找了一些资料,觉得没有一个很好的,全面的例子.因此在这里做个笔记提醒自己. 首先需要一 ...
- Java抓取网页数据(原网页+Javascript返回数据)
有时候由于种种原因,我们需要采集某个网站的数据,但由于不同网站对数据的显示方式略有不同! 本文就用Java给大家演示如何抓取网站的数据:(1)抓取原网页数据:(2)抓取网页Javascript返回的数 ...
- Java抓取网页数据(原来的页面+Javascript返回数据)
转载请注明出处! 原文链接:http://blog.csdn.net/zgyulongfei/article/details/7909006 有时候因为种种原因,我们须要採集某个站点的数据,但因为不同 ...
- 浅谈如何使用python抓取网页中的动态数据
我们经常会发现网页中的许多数据并不是写死在HTML中的,而是通过js动态载入的.所以也就引出了什么是动态数据的概念, 动态数据在这里指的是网页中由Javascript动态生成的页面内容,是在页面加载到 ...
- Python抓取网页中的图片到本地
今天在网上找了个从网页中通过图片URL,抓取图片并保存到本地的例子: #!/usr/bin/env python # -*- coding:utf- -*- # Author: xixihuang # ...
- python 解决抓取网页中的中文显示乱码问题
关于爬虫乱码有很多各式各样的问题,这里不仅是中文乱码,编码转换.还包括一些如日文.韩文 .俄文.藏文之类的乱码处理,因为解决方式是一致的,故在此统一说明. 网络爬虫出现乱码的原因 源网页编码和爬取下来 ...
- java 抓取网页图片
import java.io.File; import java.io.FileOutputStream; import java.io.InputStream; import java.io.Out ...
随机推荐
- having过滤语句
having 对部分分组来进行过滤 跟在group by 后面 在having语句中不能包含未分组的列名, select FAge,COUNT(*) from T_Employee where FS ...
- MySQL备份原理详解
备份是数据安全的最后一道防线,对于任何数据丢失的场景,备份虽然不一定能恢复百分之百的数据(取决于备份周期),但至少能将损失降到最低.衡量备份恢复有两个重要的指标:恢复点目标(RPO)和恢复时间目标(R ...
- Linux之od命令详解
功能说明:输出文件内容.语 法:od [-abcdfhilovx][-A <字码基数>][-j <字符数目>][-N <字符数目>][-s <字符串字符数&g ...
- JS--遍历对象
var person = { Name:"Frank", Age:23 } Object.keys(person).forEach(function(key){ console.l ...
- Java实现office文档与pdf文档的在线预览功能
最近项目有个需求要java实现office文档与pdf文档的在线预览功能,刚刚接到的时候就觉得有点难,以自己的水平难以在三四天做完.压力略大.后面查找百度资料.以及在同事与网友的帮助下,四天多把它做完 ...
- eclipse启动优化,终于不那么卡了!
eclipse启动优化,终于不那么卡了! 网上找了好多都是myEclipse的优化的,跟eclipse有点区别,找了很多方法还是不能让这个eclipse(Version: Kepler Release ...
- web测试与app测试的区别
才开始做测试就接触的web端,后来也接触app端,所以在这里对于自己工作中所接触到的做一些总结(总要养成总结的好习惯). 对于web端和移动端app,功能方面的测试,例如测试设计方法这些都大同小异,都 ...
- JS中typeof与instanceof的区别
JavaScript 中 typeof 和 instanceof 常用来判断一个变量是否为空,或者是什么类型的.但它们之间还是有区别的: Typeof typeof 是一个一元运算,放在一个运算数之前 ...
- HTML 学习笔记 JQuery(DOM 操作)
一般来说,DOM操作分为三个方面,即:DOM Core(核心), HTML_DOM 和 CSS_DOM. 1.DOM Core DOM Core 并不专属于JavaScript,任何一种支持DOM的程 ...
- javascript中一些常见的兼容性问题
下面是一些Javascript的IE和Firefox(火狐)兼容性的常用例子 1. document.formName.item("itemName") 问题 说明:IE下,可以使 ...