
基于nodeJS的小说爬虫实战
背景与需求分析
最近迷恋于王者荣耀、斗鱼直播与B站吃播视频,中毒太深,下班之后无心看书。
为了摆脱现状,能习惯看书,我开始看小说了,然而小说网站广告多而烦,屌丝心态不愿充钱,于是想到了爬虫。
功能分析
为了将网上小说内容获取到本地,进行了功能分析:
1、获取每个章节列表地址
2、更加每个章节地址,获取每个章节的内容
3、将获取的各个章节内容有序的写入文件
技术调研
作为一个前端er,实现爬虫nodeJS必须是首选,虽然数据挖掘Python才是真理
npm依赖如下
1、爬取内容 superagent
2、分析爬取的内容 cheerio
3、并发 async
4、文件写入 fs
编码实现
xiaoshuo.js代码如下
const cheerio = require('cheerio')
const superagent = require('superagent')
require('superagent-charset')(superagent)
const async = require('async');
const fs = require('fs');
let baseUrl = 'http://www.xxx.com/book/14435/';
let infos = [];
let urls = [];
let titles = [];
let fileName = '';
superagent.get(baseUrl).charset('UTF-8').end((err,res)=>{
var $ = cheerio.load(res.text);
// 读取章节列表页面
$('.am-book-list').eq(1).find('.am-u-lg-4 a').each((i, v) => {
let link = 'http://www.xxx.com' + $(v).attr('href')
urls.push(link);
fileName = $('.am-book-info h2').text()+'.txt';
})
let id = 0;
//获取每个章节列表
async.mapLimit(urls,urls.length,(url,callback)=>{
id++
fetchUrl(url,callback,id);
},(err,results)=>{
//将文件写入本地
fs.existsSync(fileName);
for(var i = 0;i<results.length-1;i++){
fs.appendFileSync(fileName, results[i].title) //
fs.appendFileSync(fileName, results[i].content)
}
})
})
function fetchUrl(url,callback,id){
superagent.get(url)
.charset('UTF-8')
.end(function(err,res){
let $ = cheerio.load(res.text);
let arr = []
let content = reconvert($("#am-read-centent").text())
const obj = {
id: id,
err: 0,
title: '\n'+$('#am-book-h3').text(), //标题
content: '\n'+trim(content.toString()) //内容
}
callback(null,obj)
})
}
function reconvert(str) {
str = str.replace(/(&#x)(\w{1,4});/gi, function ($0) {
return String.fromCharCode(parseInt(escape($0).replace(/(%26%23x)(\w{1,4})(%3B)/g, "$2"), 16));
});
return str
}
function trim(str){
return str.replace(/(^\s*)|(\s*$)/g, '').replace(/ /g, '')
}
为了避免坐牢,站点使用xxx代替,
运行效果
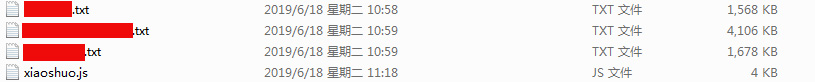
在命令行运行 node xiaoshuo,试验了本小说,好像还是ok的,哈哈哈
基于nodeJS的小说爬虫实战的更多相关文章
- python 基于aiohttp的异步爬虫实战
钢铁知识库,一个学习python爬虫.数据分析的知识库.人生苦短,快用python. 之前我们使用requests库爬取某个站点的时候,每发出一个请求,程序必须等待网站返回响应才能接着运行,而在整个爬 ...
- 基于NodeJs的网页爬虫的构建(二)
好久没写博客了,这段时间已经忙成狗,半年时间就这么没了,必须得做一下总结否则白忙.接下去可能会有一系列的总结,都是关于定向爬虫(干了好几个月后才知道这个名词)的构建方法,实现平台是Node.JS. 背 ...
- 基于NodeJs的网页爬虫的构建(一)
好久没写博客了,这段时间已经忙成狗,半年时间就这么没了,必须得做一下总结否则白忙.接下去可能会有一系列的总结,都是关于定向爬虫(干了好几个月后才知道这个名词)的构建方法,实现平台是Node.JS. 背 ...
- 浏览器自动刷新——基于Nodejs的Gulp LiveReload与VisualStudio完美结合。
本文版权桂博客园和作者吴双共同所有,转载和爬虫请注明原文地址 http://www.cnblogs.com/tdws/p/6016055.html 写在前面 大家好我是博客园的蜗牛,博客园的蜗牛就是我 ...
- 基于nodejs模拟浏览器post请求爬取json数据
今天想爬取某网站的后台传来的数据,中间遇到了很多阻碍,花了2个小时才请求到数据,所以我在此总结了一些经验. 首先,放上我所爬取的请求地址http://api.chuchujie.com/api/?v= ...
- 爬虫实战:爬虫之 web 自动化终极杀手 ( 上)
欢迎大家前往腾讯云技术社区,获取更多腾讯海量技术实践干货哦~ 作者:陈象 导语: 最近写了好几个简单的爬虫,踩了好几个深坑,在这里总结一下,给大家在编写爬虫时候能给点思路.本次爬虫内容有:静态页面的爬 ...
- iKcamp团队制作|基于Koa2搭建Node.js实战项目教学(含视频)☞ 环境准备
安装搭建项目的开发环境 视频地址:https://www.cctalk.com/v/15114357764004 文章 Koa 起手 - 环境准备 由于 koa2 已经开始使用 async/await ...
- 32个Python爬虫实战项目,满足你的项目慌
爬虫项目名称及简介 一些项目名称涉及企业名词,小编用拼写代替 1.[WechatSogou]- weixin公众号爬虫.基于weixin公众号爬虫接口,可以扩展成其他搜索引擎的爬虫,返回结果是列表,每 ...
- Python爬虫实战---抓取图书馆借阅信息
Python爬虫实战---抓取图书馆借阅信息 原创作品,引用请表明出处:Python爬虫实战---抓取图书馆借阅信息 前段时间在图书馆借了很多书,借得多了就容易忘记每本书的应还日期,老是担心自己会违约 ...
随机推荐
- 使用IDA Pro逆向C++程序
使用IDA Pro逆向C++程序 附:中科院李_硕博 : IDA用来做二进制分析还是很强大的 .lib程序是不是很容易分析出源码? 这个得看编译选项是怎么设置的 如果没混淆 没太过优化 大体能恢复源码 ...
- Python 判断文件是否存在,不存在则将名称写入指定文件
import os filename = '15464657761111111.pdf' pathDir = 'F:/tqcs/sr' # 判断文件是否存在 if os.path.exists(pat ...
- spark写数据入kafka示范代码
一.pom文件 <?xml version="1.0" encoding="UTF-8"?> <project xmlns="htt ...
- ListView如何添加数据如何不闪烁
public class DoubleBufferListView : ListView { public DoubleBufferListView() ...
- 《剑指offer》算法题第七天
今日题目: 复杂链表的复制 二叉搜索树与双向链表 序列化二叉树 字符串的排序 1.复杂链表的复制 题目描述: 输入一个复杂链表(每个节点中有节点值,以及两个指针,一个指向下一个节点,另一个特殊指针指向 ...
- Struts增删改查
1.导入相关的pom依赖(struts.自定义标签库的依赖) <dependency> <groupId>jstl</groupId> <artifactId ...
- 洛谷比赛 U5442 买(最长链)
U5442 买 题目提供者bqsgwys 标签 树形结构 树的遍历 洛谷原创 题目背景 小E是个可爱的电路编码员. 题目描述 一天小E又要准备做电路了,他准备了一个电路板,上面有很多个电路元器件要安装 ...
- 2019牛客暑期多校训练营(第一场)H 线性基+计算贡献
题意 给n个整数,求满足子集异或和为0的子集大小之和. 分析 将问题转化为求每个元素的贡献次数之和. 先对n个数求线性基,设线性基大小为r,即插入线性基的数字个数为r,可以分别计算线性基内数的贡献和线 ...
- node链接mongoDB及封装
// 这个模块中封装所有对数据库的常用操作 const MongoClient = require('mongodb').MongoClient; const assert = require('as ...
- IDEA:Process finished with exit code -1073741819 (0xC0000005)
出门左转:https://www.cnblogs.com/virgosnail/p/10335224.html