
SSIS数据同步实践
背景
测试环境
测试步骤
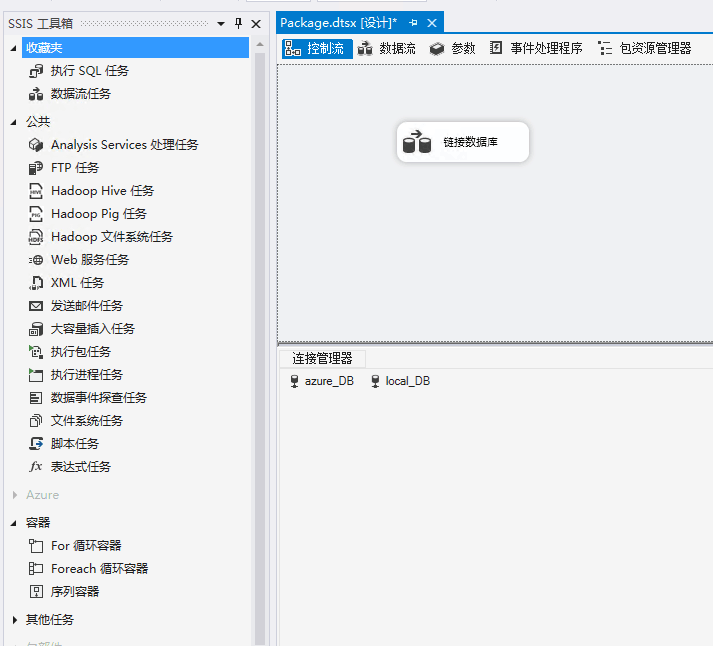
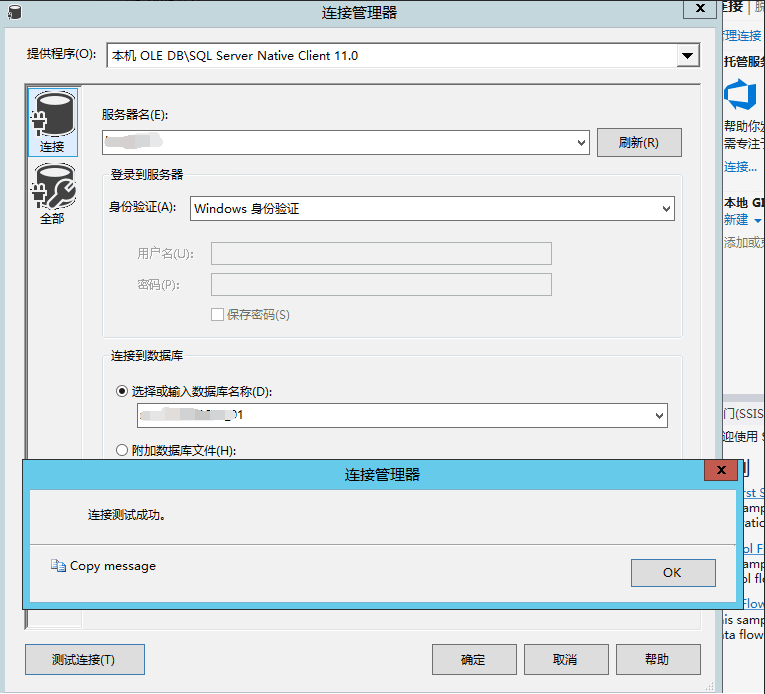
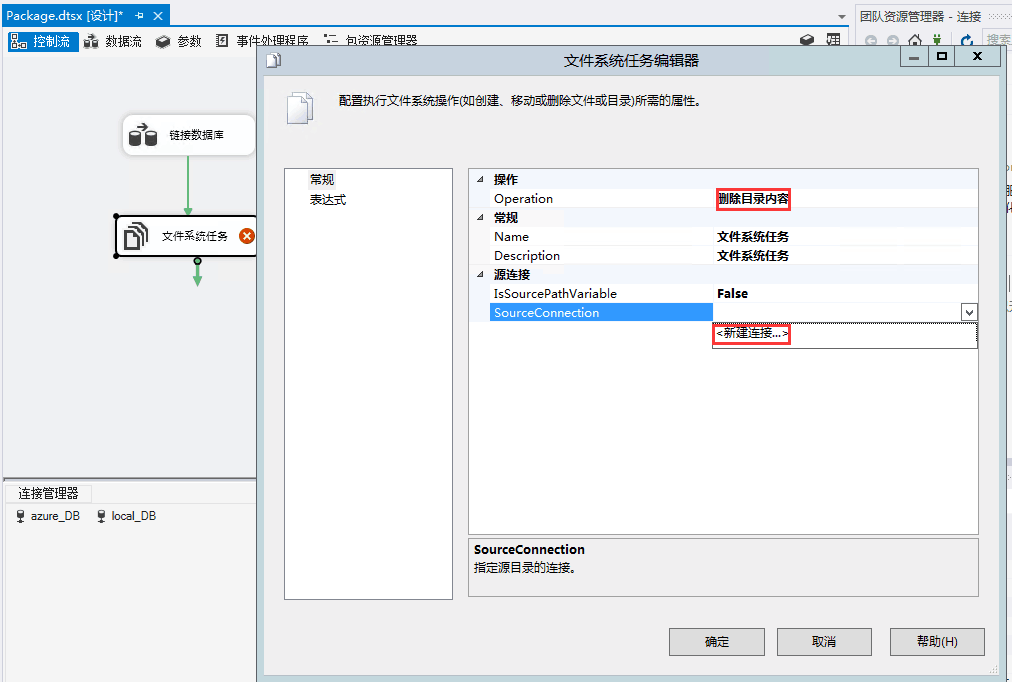
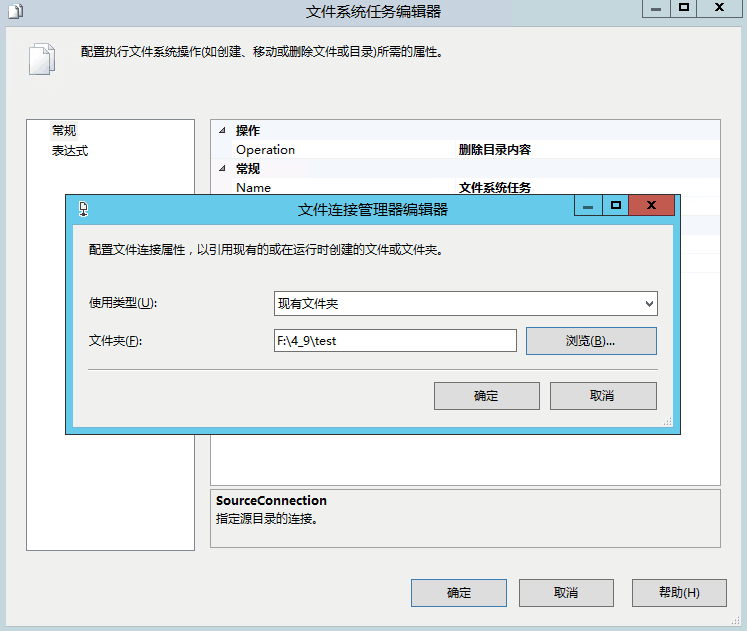
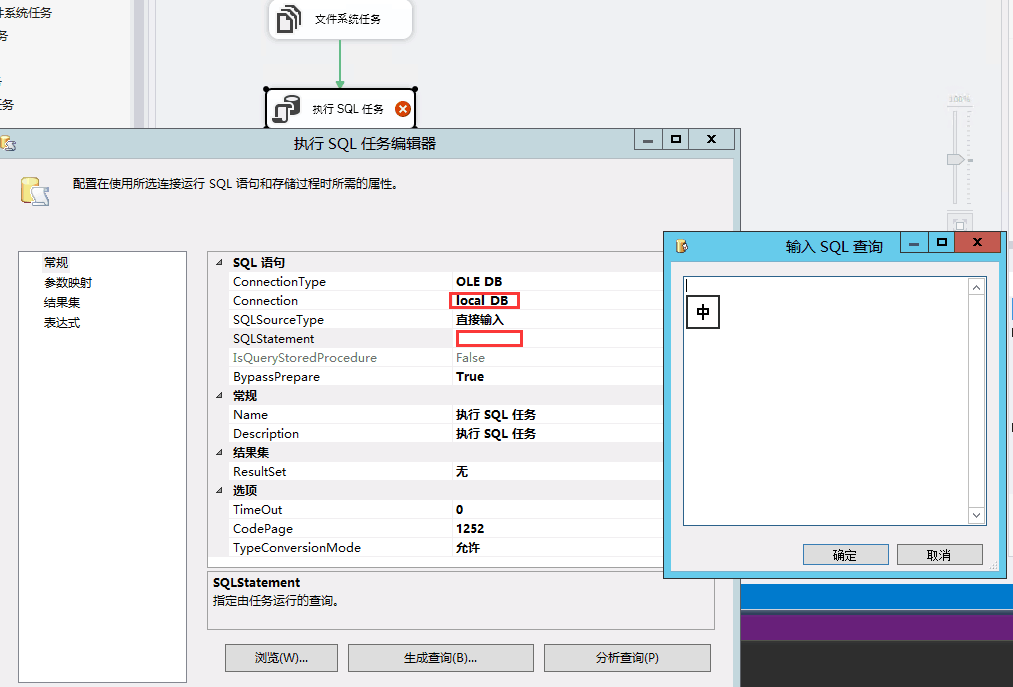
DECLARE @TableNames AS TABLE

(

    id INT IDENTITY(1, 1),

    tableName VARCHAR(100)

);

DECLARE @sTableDiff NVARCHAR(1000);

DECLARE @tableName VARCHAR(100);

DECLARE @counter INT;

DECLARE @maxCount INT;

INSERT INTO @TableNames

SELECT a.name

FROM sys.sysobjects a

    INNER JOIN

     (

         SELECT object_id

         FROM sys.columns

         WHERE is_rowguidcol = 1

               OR is_identity = 1

         UNION

         SELECT object_id

         FROM sys.indexes

         WHERE index_id = 1

     ) b

        ON a.id = b.object_id

WHERE a.type = 'U' --and a.name='TMonStoreCheck';

SET @counter = 1;

SELECT @maxCount = COUNT(name)

FROM sys.sysobjects a

    INNER JOIN

     (

         SELECT object_id

         FROM sys.columns

         WHERE is_rowguidcol = 1

               OR is_identity = 1

         UNION

         SELECT object_id

         FROM sys.indexes

         WHERE index_id = 1

     ) b

        ON a.id = b.object_id

WHERE a.type = 'U' --and a.name='TMonStoreCheck';

WHILE @counter <= @maxCount

BEGIN

    SELECT @tableName = tableName

    FROM @TableNames

    WHERE id = @counter;

    SELECT @sTableDiff = '';

    SET @sTableDiff

        =  ' "C:\Program Files\Microsoft SQL Server\130\COM\tablediff.exe" -sourceserver  [faqb6n86e4.database.chinacloudapi.cn]  -sourceuser  ymjj -sourcepassword  ***** -sourcedatabase xw_dl_1009676_01 -sourcetable ' + @tableName + ' -destinationserver [butt-joint] -destinationuser sa -destinationpassword ****** -destinationdatabase xw_dl_1009676_01 -destinationtable '+@tableName+'  -f F:\4_9\test\'+@tableName

    EXEC master..XP_CMDSHELL  @sTableDiff

    SET @counter = @counter + 1;

END;
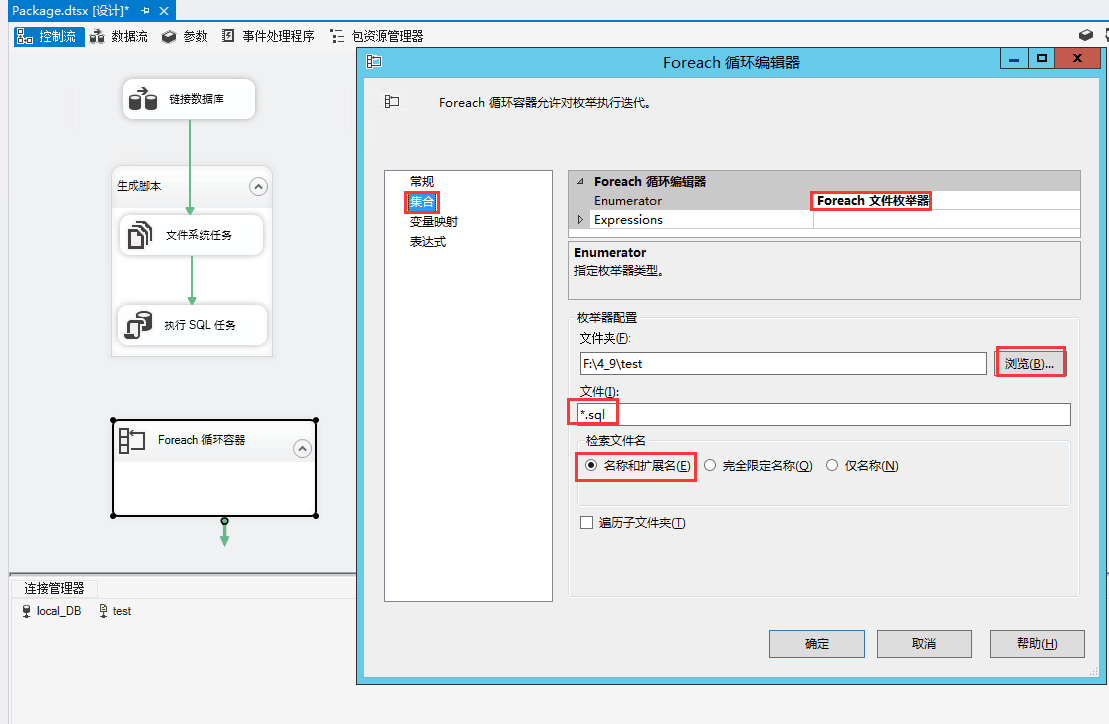
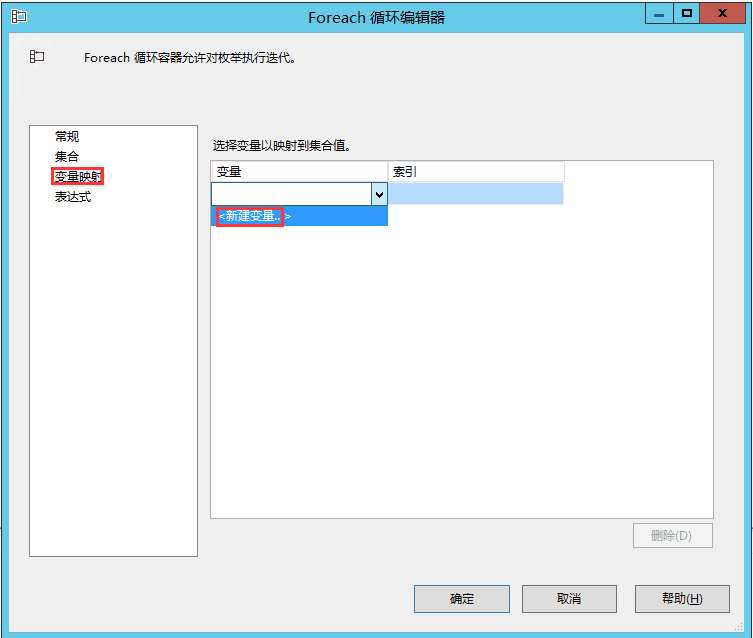

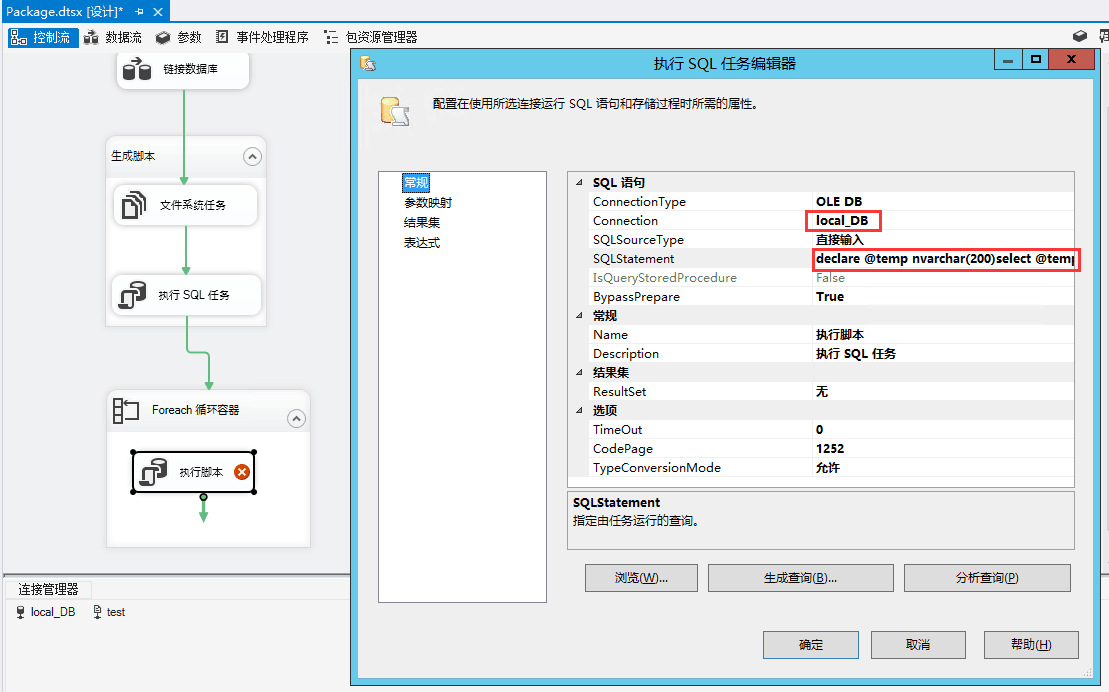
declare @temp nvarchar(200)

select @temp ='"F:\Program Files\Microsoft SQL Server\Client SDK\ODBC\130\Tools\Binn\sqlcmd.exe" -a 32576 -S butt-joint -d xw_dl_1009676_01  -i F:\4_9\test\'+ ? +'  -f 65001'

EXEC master..xp_cmdshell @temp
- 可能需要安装NET Framework 3.5, 否则sqlcmd无法正常执行;
- sqlcmd 的前期测试,为了方便问题定位可以使用 -o 选项把错误信息打印出文本;
- sqlcmd 后面切记加 -f 65001,避免中文在数据库中插入后,select显示乱码的情形;
- 当插入的脚本文件非常大比如超100M+的时候建议加上-a选项,并保障内存富裕;
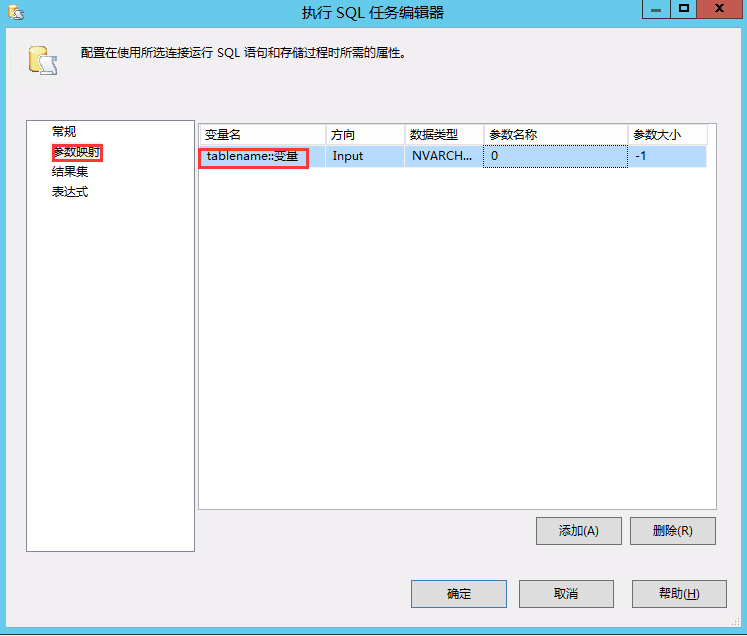
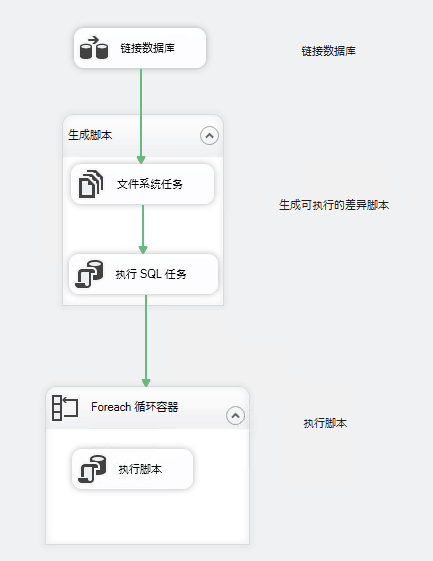
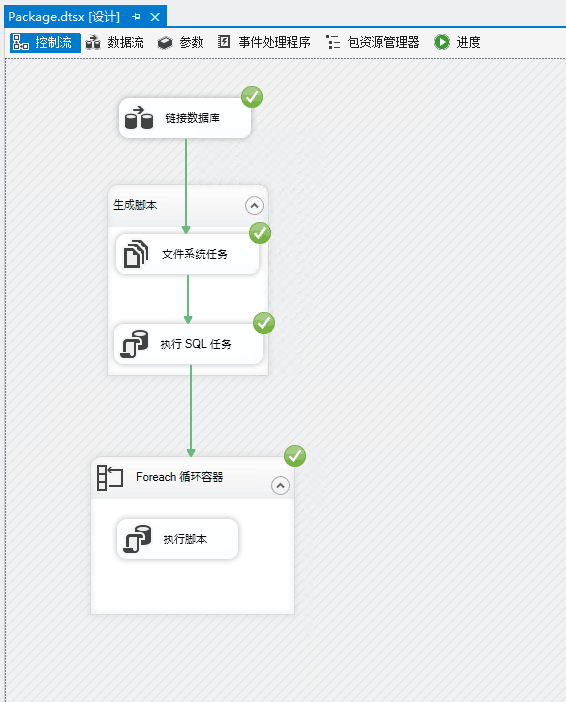
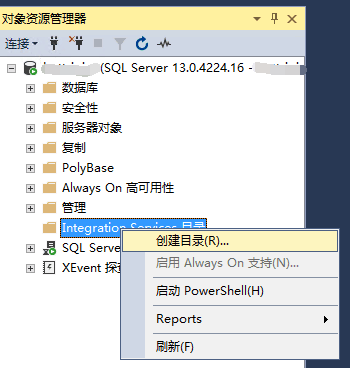
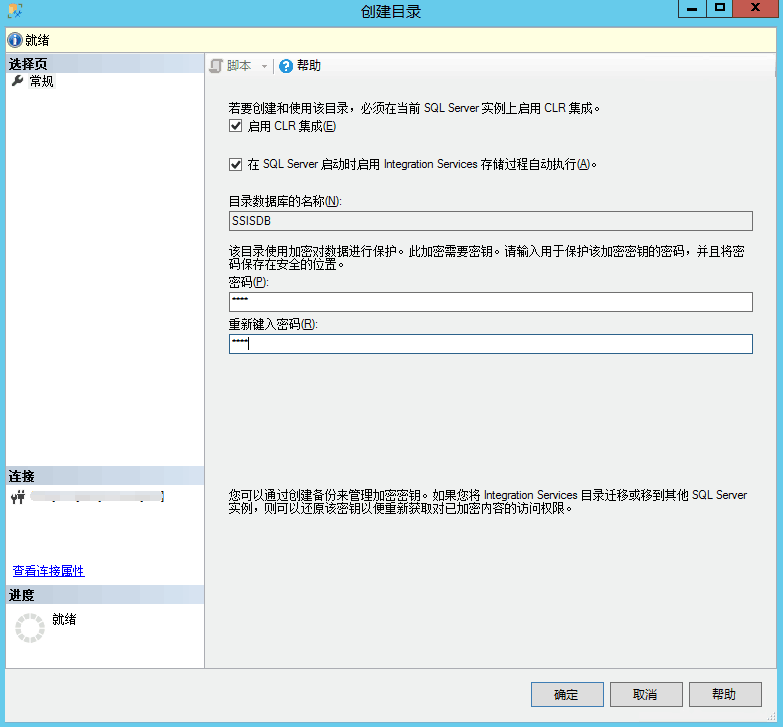
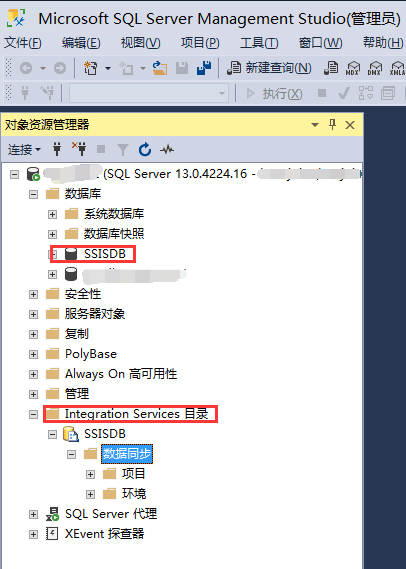
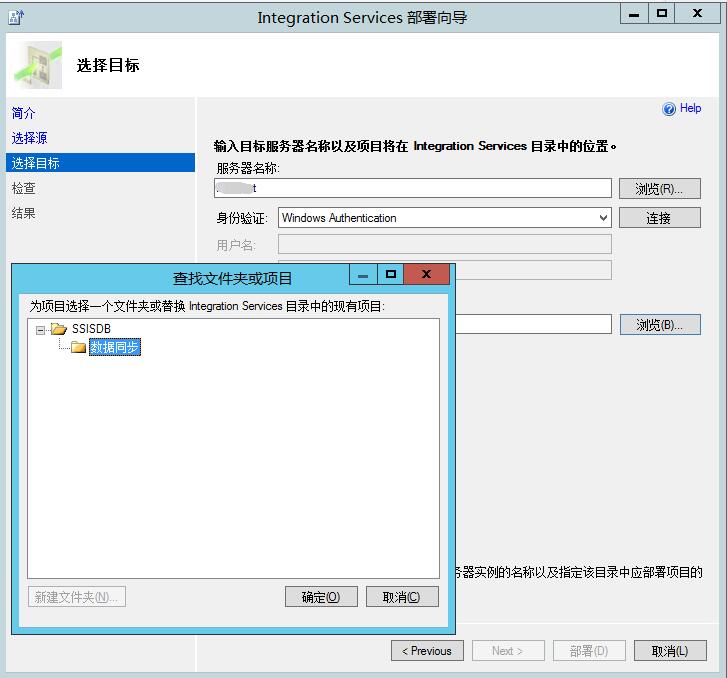
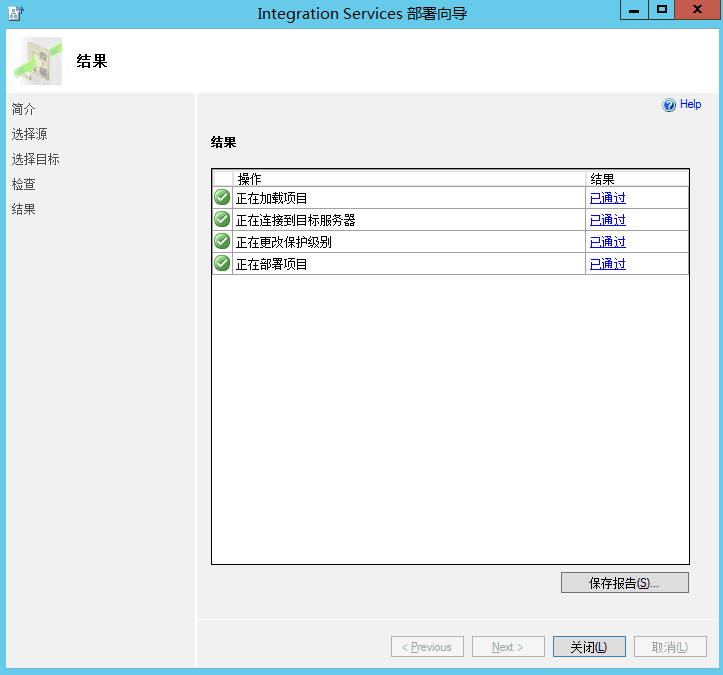
- SQL Server Integration Services 服务是否已正常启动;
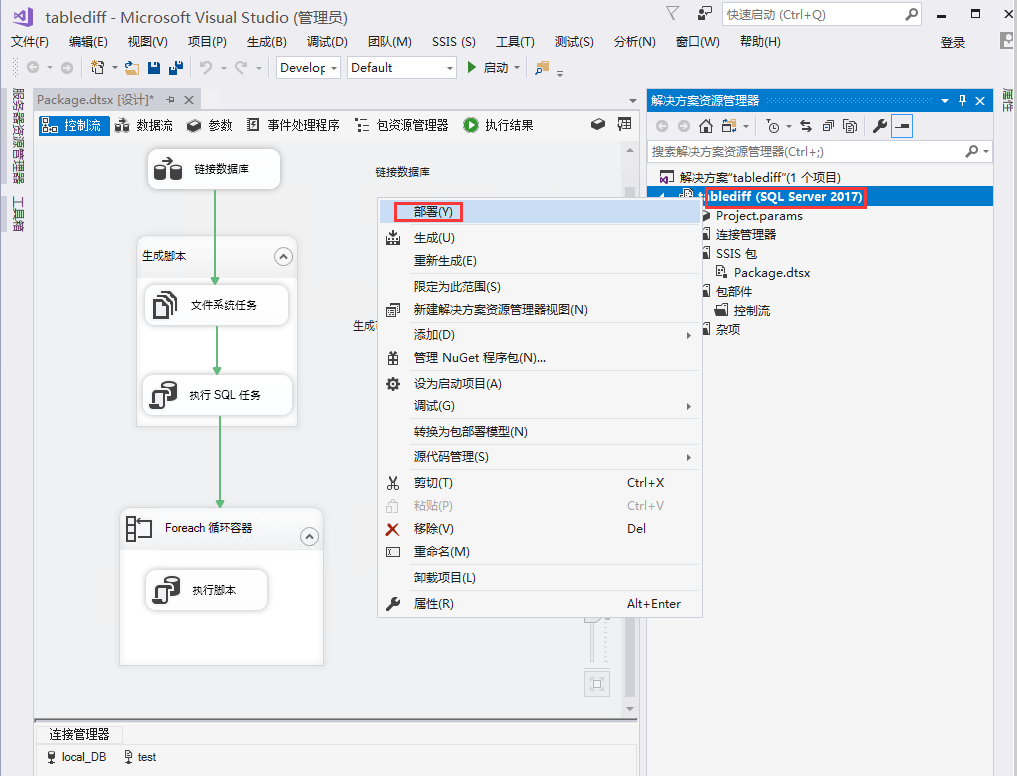
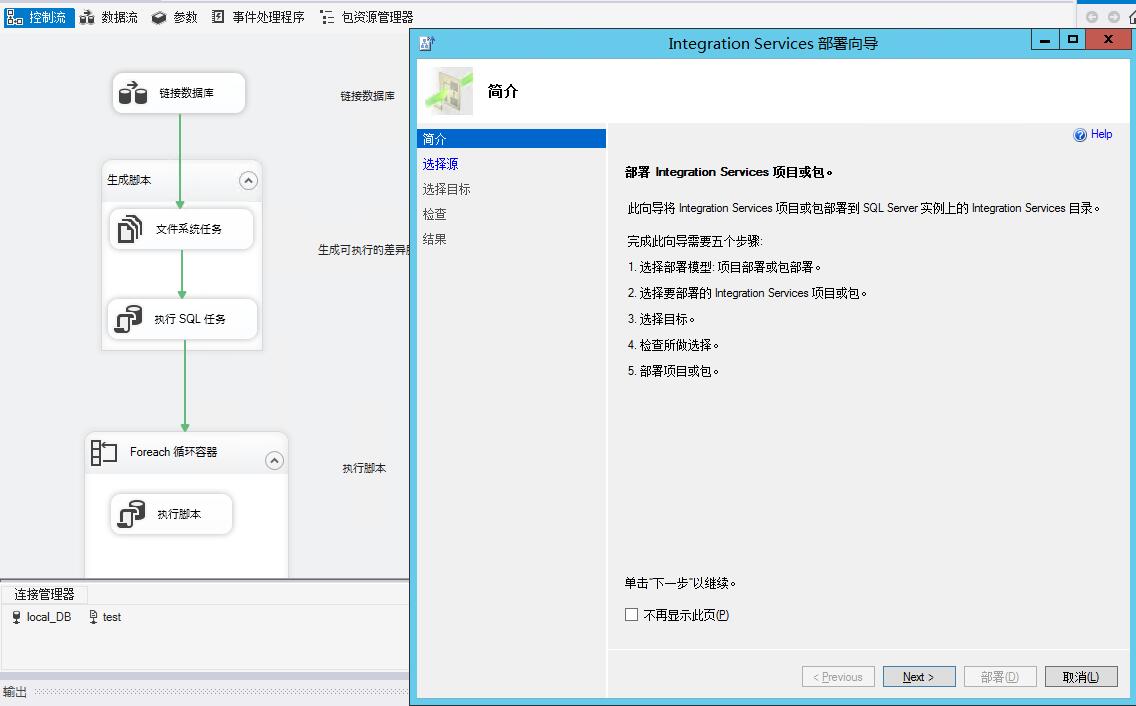

结论
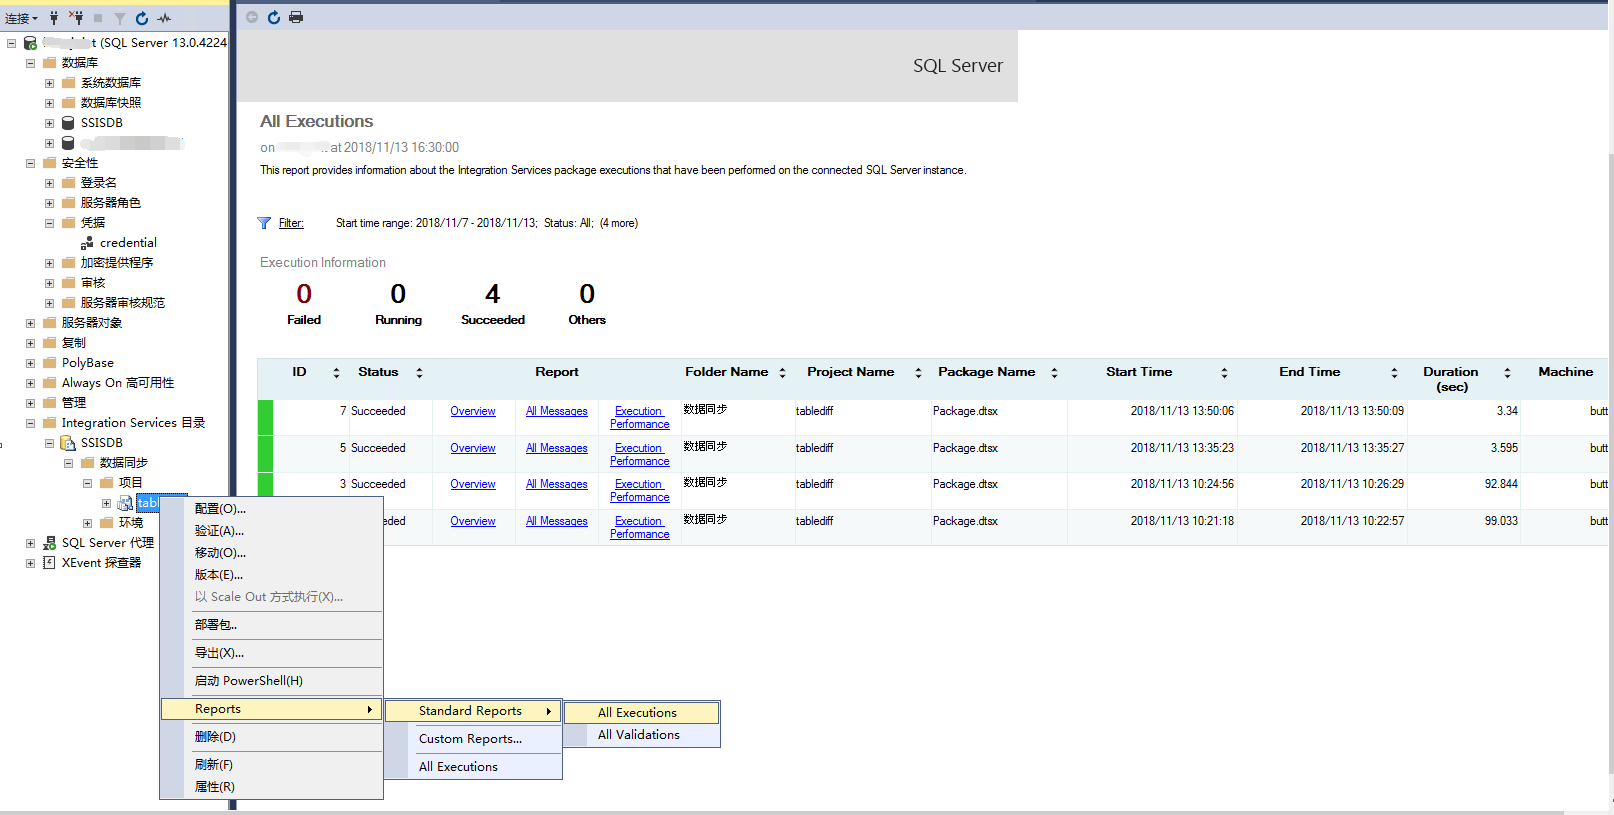
- 上述是一个简单的SSIS数据同步实践,不同的业务需求的业务逻辑都可在3)中自定义;
- sqlcmd执行可能需要安装NET Framework 3.5, 否则sqlcmd无法正常执行;
- sqlcmd 的前期测试,为了方便问题定位可以使用 -o 选项把错误信息打印出文本;
- sqlcmd 后面建议加 -f 65001,避免中文在数据库中插入后,select原本是中文而显示乱码的情形;
- 确保部署的机器上SQL Server Integration Services 服务已安装并且正常启动;
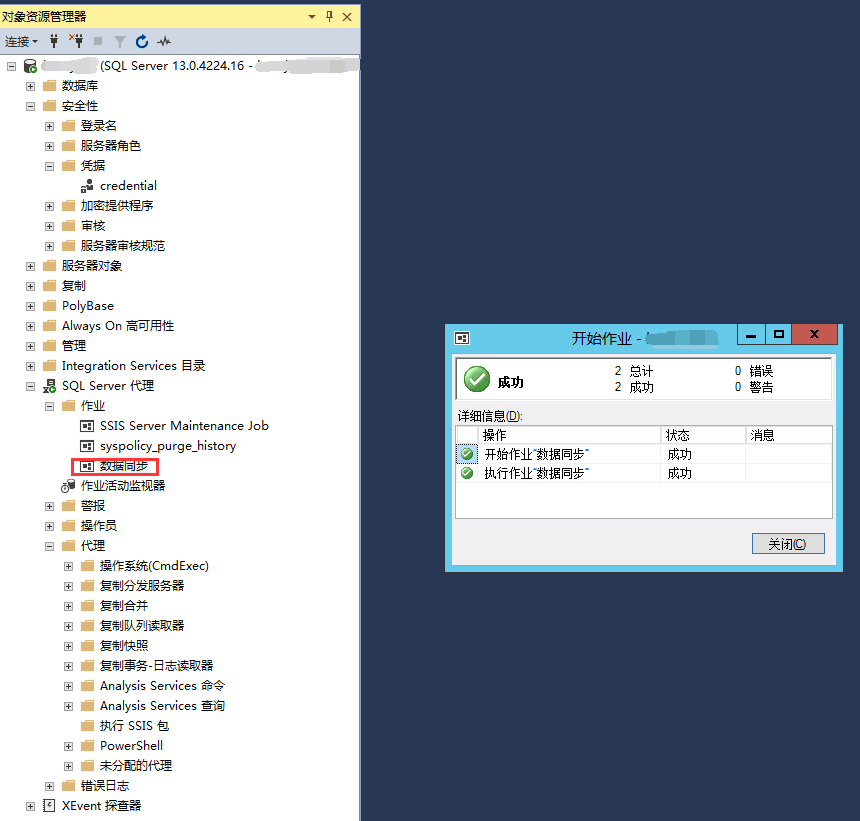
- 确保SQL Server Agent 服务已正常启动;
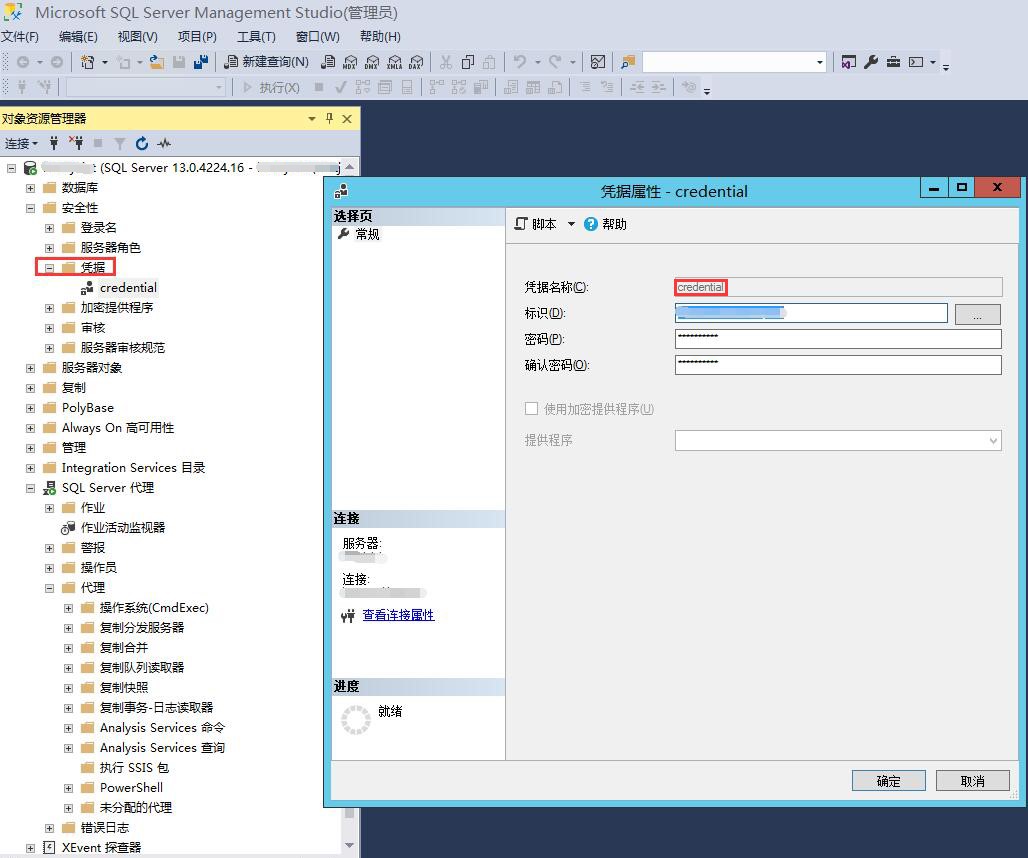
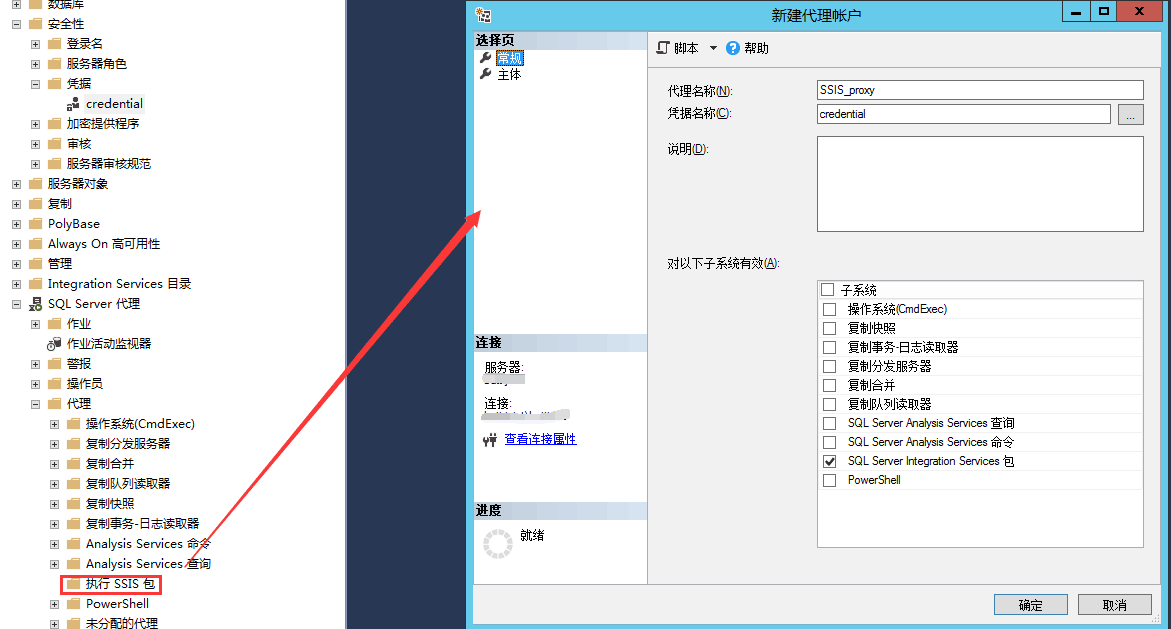
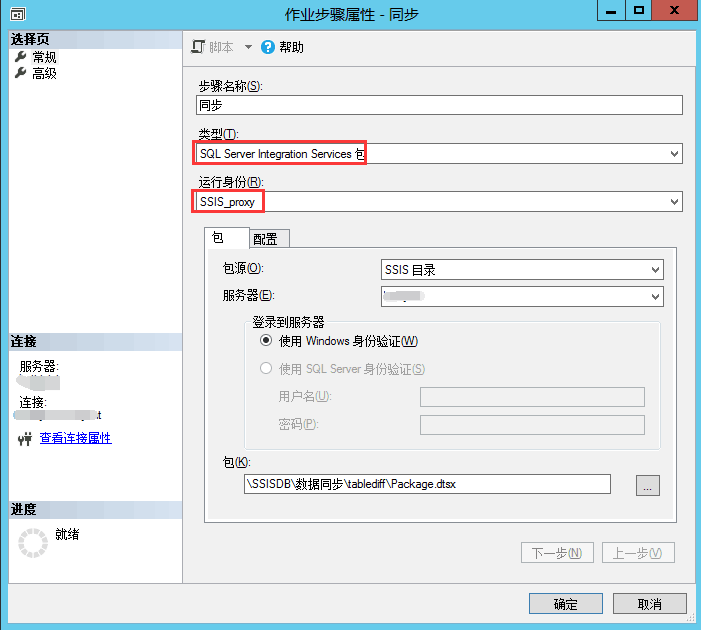
- 在配置包的JOB的时候注意提前新建SSIS的代理,否则会有执行权限相关的问题;
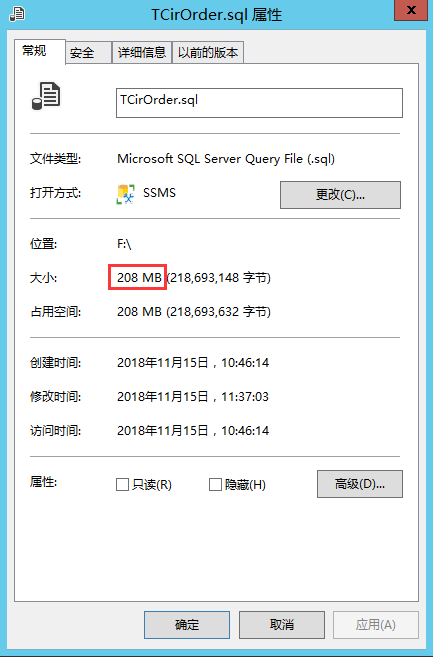
- 当生成的执行脚本文件比较大的时候(比如超100M或更大),sqlcmd会报如下错误,建议在sqlcmd 加上 -a 选项,并保障执行sqlcmd的服务器有足够富裕的内存 ;
Shared Memory Provider: No process is on the other end of the pipe.

Communication link failure

---or

Msg 701, Level 17, State 139, Server *******, Line -5057

资源池“default”没有足够的系统内存来运行此查询。
后记
exec master..xp_cmdshell '"F:\Program Files\Microsoft SQL Server\Client SDK\ODBC\130\Tools\Binn\bcp.exe" test.dbo.TCirOrder in F:\TCirOrder.sql -E -n -C RAW -b 1000 -a 4096 -q -S butt-joint -T'
NULL

Starting copy...

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

SQLState = 22001, NativeError = 0

Error = [Microsoft][ODBC Driver 13 for SQL Server]String data, right truncation

NULL

BCP copy in failed

NULL
SSIS数据同步实践的更多相关文章
- 基于 MySQL Binlog 的 Elasticsearch 数据同步实践 原
一.背景 随着马蜂窝的逐渐发展,我们的业务数据越来越多,单纯使用 MySQL 已经不能满足我们的数据查询需求,例如对于商品.订单等数据的多维度检索. 使用 Elasticsearch 存储业务数据可以 ...
- 基于MySQL Binlog的Elasticsearch数据同步实践
一.为什么要做 随着马蜂窝的逐渐发展,我们的业务数据越来越多,单纯使用 MySQL 已经不能满足我们的数据查询需求,例如对于商品.订单等数据的多维度检索. 使用 Elasticsearch 存储业务数 ...
- SSIS 学习之旅 数据同步
这一章 别人也有写过但是我觉得还是写写比较好.数据同步其实就是想仿照 数据库的发布订阅功能 第一章:SSIS 学习之旅 第一个SSIS 示例(一)(上) 第二章:SSIS 学习之旅 第一个SSIS 示 ...
- 美团DB数据同步到数据仓库的架构与实践
背景 在数据仓库建模中,未经任何加工处理的原始业务层数据,我们称之为ODS(Operational Data Store)数据.在互联网企业中,常见的ODS数据有业务日志数据(Log)和业务DB数据( ...
- DB 数据同步到数据仓库的架构与实践
背景 在数据仓库建模中,未经任何加工处理的原始业务层数据,我们称之为ODS(Operational Data Store)数据.在互联网企业中,常见的ODS数据有业务日志数据(Log)和业务DB数据( ...
- 大数据实践-数据同步篇tungsten-relicator(mysql->mongo)
// mongo)";digg_bgcolor = "#FFFFFF";digg_skin = "normal"; // ]]> // [导读] ...
- ElasticStack系列之十一 & 同步 mysql 数据的实践与思考
问题 1. jdbc-input-plugin 只能实现数据库的追加,对于 elasticsearch 增量写入,但经常 jdbc 源一端的数据库可能会做数据库删除或者更新操作.这样一来数据库与搜索引 ...
- MongoDB DBA 实践5-----复制集集群的数据同步和故障转移
(1)复制集集群的数据同步 1>主节点数据库test,在其中goods集合中加入一个文档. 2>在副节点中查看 注意:SECONDARY是不允许读写的,要使用rs.slaveOk()获得读 ...
- 阿里Canal框架(数据同步中间件)初步实践
最近在工作中需要处理一些大数据量同步的场景,正好运用到了canal这款数据库中间件,因此特意花了点时间来进行该中间件的的学习和总结. 背景介绍 早期,阿里巴巴B2B公司因为存在杭州和美国双机房部署,存 ...
随机推荐
- Python的安装和配置(windowns 双版本)
1.去官网上下载python,注意版本. 官网地址:https://www.python.org/downloads/windows 2.下载安装版或者zip包都可以.安装就按向导一步一步完成即可.z ...
- R的数据结构--向量
向量:用于存储数值型.字符型或逻辑型数据的一维数组,只可以包含一种数据 向量的创建与运算 创建向量 # 创建简单向量 l <- c(2, 2, 1, 3, 8) # [1] 2 2 1 3 8 ...
- Jmeter设置集合点(并发测试)
什么是集合点? 让所有请求在不满足条件的时候处于等待状态. 如何实现? 使用jmeter中的同步计时器Synchronizing Timer来实现 集合点的位置 因为集合点是在取样器sampler(例 ...
- 第四章 Jinja2模版
模板简介: 在之前的章节中,视图函数只是直接返回文本,而在实际生产环境中的页面大多是带有样式和复杂逻辑的HTML代码,这可以让浏览器渲染出非常漂亮的页面.目前市面上有非常多的模板系统,其中最知名好用的 ...
- google chrome调试
1,同样的代码使用firefox运行不会报错,正常运行. 2,同样的代码使用google chrome 有时候会误报网页? 如下:代码可以在 firfox edge正常运行,在chrome oper ...
- neo4j︱与python结合的py2neo使用教程
—- 目前的几篇相关:—– neo4j︱图数据库基本概念.操作罗列与整理(一) neo4j︱Cypher 查询语言简单案例(二) neo4j︱Cypher完整案例csv导入.关系联通.高级查询(三) ...
- BDD行为驱动简介及Pytest-bdd基础使用
目录 BDD介绍 需求描述/用户场景 场景解析/实现 场景测试 Pytest-bdd的参数化 运行环境: pip insall pytest pytest-bdd pytest-selenium BD ...
- putty ssh 证书登录及问题
1.用PUTTYGEN.exe生成密钥,生成的时候鼠标在进度条下面的空白处移动,为什么?就理解成随机得厉害点吧. 2.保存私钥,请看下面的图片说明 3.把公钥的内容想办法放到用户目录的.ssh/aut ...
- Jquery 2.0+版本不支持IE8,如何解决?
用了JQuery2.0+以后,在IE8下会报错,下面是我的方法. 先看代码: <!--[if !IE]> --> <script src="/Scrip ...
- Docker容器常用命令汇总
Docker常用命令总结如下: # 查看docker详细信息 docker info # 获取当前节点所有容器 docker ps -a # 管理容器生命周期 docker [start|stop|r ...