
IDEA配置Hadoop开发环境&编译运行WordCount程序
有关hadoop及java安装配置请见:https://www.cnblogs.com/lxc1910/p/11734477.html
1、新建Java project:
选择合适的jdk,如图所示:

将工程命名为WordCount。
2、添加WordCount类文件:
在src中添加新的Java类文件,类名为WordCount,代码如下:
 import java.io.IOException;

 import java.util.StringTokenizer;

 import org.apache.hadoop.conf.Configuration;

 import org.apache.hadoop.fs.Path;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Job;

 import org.apache.hadoop.mapreduce.Mapper;

 import org.apache.hadoop.mapreduce.Reducer;

 import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

 import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

 import org.apache.hadoop.util.GenericOptionsParser;

 public class WordCount {

     public static class TokenizerMapper //定义Map类实现字符串分解

             extends Mapper<Object, Text, Text, IntWritable>

     {

         private final static IntWritable one = new IntWritable(1);

         private Text word = new Text();

         //实现map()函数

         public void map(Object key, Text value, Context context)

                 throws IOException, InterruptedException

         { //将字符串拆解成单词

             StringTokenizer itr = new StringTokenizer(value.toString());

             while (itr.hasMoreTokens())

             { word.set(itr.nextToken()); //将分解后的一个单词写入word类

                 context.write(word, one); //收集<key, value>

             }

         }

     }

     //定义Reduce类规约同一key的value

     public static class IntSumReducer extends Reducer<Text,IntWritable,Text,IntWritable>

     {

         private IntWritable result = new IntWritable();

         //实现reduce()函数

         public void reduce(Text key, Iterable<IntWritable> values, Context context )

                 throws IOException, InterruptedException

         {

             int sum = 0;

             //遍历迭代values,得到同一key的所有value

             for (IntWritable val : values) { sum += val.get(); }

             result.set(sum);

             //产生输出对<key, value>

             context.write(key, result);

         }

     }

     public static void main(String[] args) throws Exception

     { //为任务设定配置文件

         Configuration conf = new Configuration();

         //命令行参数

         String[] otherArgs = new GenericOptionsParser(conf, args).getRemainingArgs();

         if (otherArgs.length != 2)

         { System.err.println("Usage: wordcount <in> <out>");

             System.exit(2);

         }

         Job job = Job.getInstance(conf, "word count");//新建一个用户定义的Job

         job.setJarByClass(WordCount.class); //设置执行任务的jar

         job.setMapperClass(TokenizerMapper.class); //设置Mapper类

         job.setCombinerClass(IntSumReducer.class); //设置Combine类

         job.setReducerClass(IntSumReducer.class); //设置Reducer类

         job.setOutputKeyClass(Text.class); //设置job输出的key

         //设置job输出的value

         job.setOutputValueClass(IntWritable.class);

         //设置输入文件的路径

         FileInputFormat.addInputPath(job, new Path(otherArgs[0]));

         //设置输出文件的路径

         FileOutputFormat.setOutputPath(job, new Path(otherArgs[1]));

         //提交任务并等待任务完成

         System.exit(job.waitForCompletion(true) ? 0 : 1);

     }

 }
3、添加依赖库:
点击 File -> Project Structure -> Modules,选择Dependencies,点击加号,添加以下依赖库:

4、编译生成JAR包:
点击 File -> Project Structure ->Artifacts,点击加号->JAR->from modules with dependencies,
Mainclass选择WordCount类:
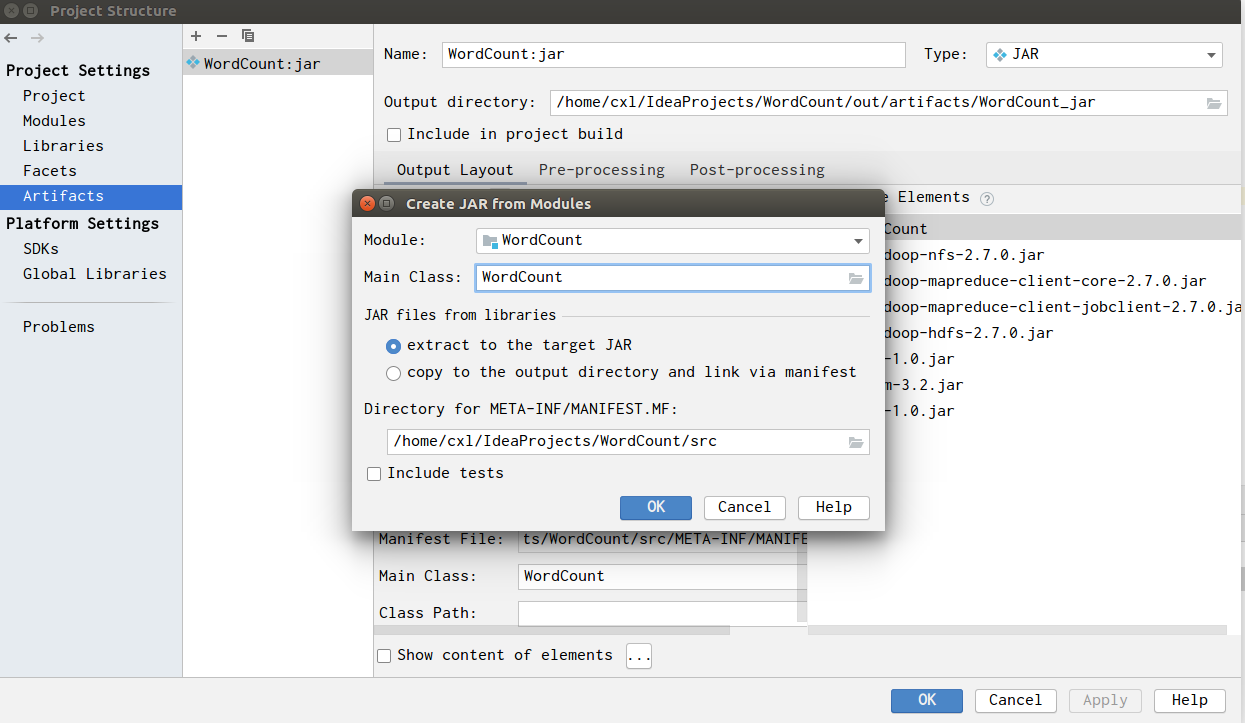
下面开始编译生成JAR包:
点击 build->build Artifacts->build,完成编译后,会发现多出一个目录output.
5、在hadoop系统中运行JAR包:
我之前在hadoop用户下安装了伪分布式的hadoop系统,因此首先把JAR包复制到hadoop用户目录下。
启动hadoop服务:(在hadoop安装目录的sbin文件夹下)
./start-all.sh
在hdfs下新建test-in文件夹,并放入file1.txt、file2.txt两个文件,
 hadoop fs -mkdir test-in

 hadoop fs -put file1.txt file2.txt test-in/
执行jar包:
hadoop jar WordCount.jar test-in test-out
因为之前生成JAR包时设置了主类,所以WordCount.jar后面不需要再加WordCount.
另外需要注意运行JAR包之前hdfs中不能有test-out文件夹。
6、查看运行结果
可通过http://localhost:50070/查看hadoop系统状况,
点击Utilities->Browse the file system即可查看hdfs文件系统:
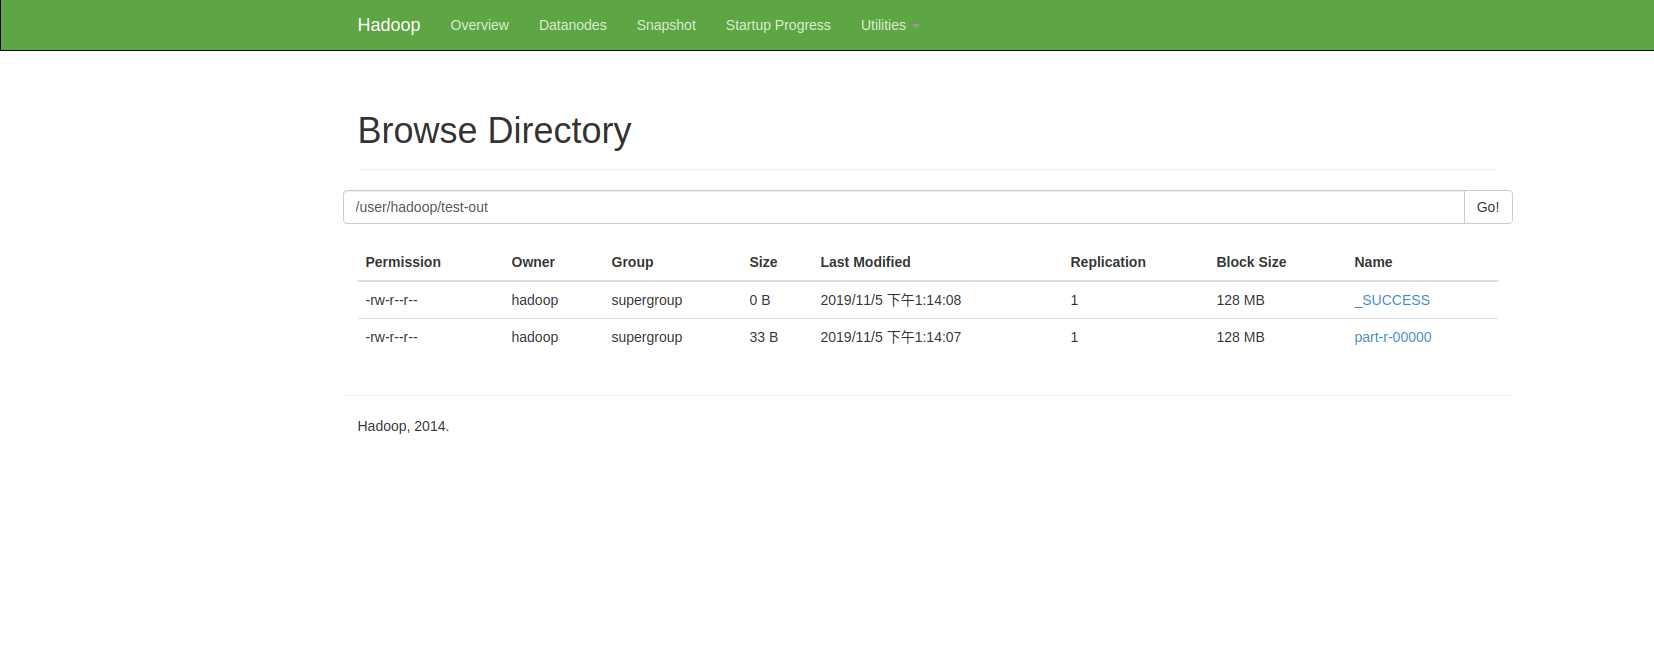
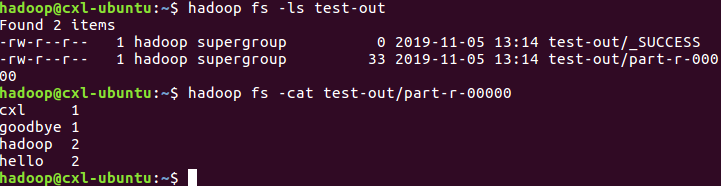
可以看到test-out文件下有输出文件,可通过命令:
hadoop fs -cat test-out/part-r-
查看文件输出情况:
7、参考
https://blog.csdn.net/chaoping315/article/details/78904970
https://blog.csdn.net/napoay/article/details/68491469
https://blog.csdn.net/ouyang111222/article/details/73105086
IDEA配置Hadoop开发环境&编译运行WordCount程序的更多相关文章
- myeclipse配置hadoop开发环境
1.安装Hadoop开发插件 hadoop安装包contrib/目录下有个插件hadoop-0.20.2-eclipse-plugin.jar,拷贝到myeclipse根目录下/dropins目录下. ...
- Hadoop_配置Hadoop开发环境(Eclipse)
通常我们可以用Eclipse作为Hadoop程序的开发平台. 1) 下载Eclipse 下载地址:http://www.eclipse.org/downloads/ 根据操作系统类型,选择合适的版本 ...
- Eclipse配置Hadoop开发环境
Step 1:选择Hadoop版本对应的Eclipse插件jar包(可自行编译),我的Hadoop版本是hadoop-0.20.2,对应的插件应该是:hadoop-0.20.2-eclipse-plu ...
- Eclipse安装Hadoop插件配置Hadoop开发环境
一.编译Hadoop插件 首先需要编译Hadoop 插件:hadoop-eclipse-plugin-2.6.0.jar,然后才可以安装使用. 第三方的编译教程:https://github.com/ ...
- 配置Hadoop开发环境(Eclipse)
参考博文: http://blog.csdn.net/zythy/article/details/17397153 http://www.tuicool.com/articles/AjUZrq 注意事 ...
- 第五章 MyEclipse配置hadoop开发环境
1.首先要下载相应的hadoop版本的插件,我这里就给2个例子: hadoop-1.2.1插件:http://download.csdn.net/download/hanyongan300/62381 ...
- 分布式集群环境下运行Wordcount程序
1.分布式环境的Hadoop提交作业方式与本地安装的Hadoop作业提交方式相似,但有两点不同: 1)作业输入输出都存储在HDFS 2)本地Hadoop提交作业时将作业放在本地JVM执行,而分布式集群 ...
- (三)配置Hadoop1.2.1+eclipse(Juno版)开发环境,并运行WordCount程序
配置Hadoop1.2.1+eclipse(Juno版)开发环境,并运行WordCount程序 一. 需求部分 在ubuntu上用Eclipse IDE进行hadoop相关的开发,需要在Eclip ...
- 在Fedora18上配置个人的Hadoop开发环境
在Fedora18上配置个人的Hadoop开发环境 1. 背景 文章中讲述了类似于"personalcondor"的一种"personal hadoop" ...
随机推荐
- 关于微信小程序发布新版本后的提示用户更新的方法详解
当小程序发布新的版本后 ,用户如果之前访问过该小程序,通过已打开的小程序进入(未手动删除),则会检测新版本,提醒用户更新新的版本 话不多说,上代码 App({ onLaunch: function ( ...
- cygwin_exception::open_stackdumpfile: Dumping stack trace to HttpServer.exe.stackdump错误
本来,我在Windows下使用Cygwin编译运行c程序,在执行*.exe时报出如题错误,我在Linux环境下使用gcc编译运行,则正常. 所以,当你无法解决上述问题时,换系统吧!
- h5常见
Meta基础知识: H5页面窗口自动调整到设备宽度,并禁止用户缩放页面//一.HTML页面结构<meta name="viewport" content="widt ...
- curl: (7) couldn't connect to host 解决方法
使用curl命令访问网站时报错: [root@bqh-119 ~]# curl -I www.test.com curl: (7) couldn't connect to host [root@bqh ...
- MyBaties --day1
今天就来聊聊这个东西 今天的主角相信大家也看到了 MyBaties 是个什么东东 它有什么作用?怎么用?好不好用今天来说说 .说到MyBaties 就不得不谈到JDBC大家可能都知道 JDBC用来操 ...
- strconv:各种数据类型和字符串之间的相互转换
介绍 strconv包实现了基本数据类型和其对应字符串之间的相互转换.主要有一下常用函数:Atoi,Itoa,Parse系列,Formart系列,Append系列 string和int之间的转换 这一 ...
- net.exe和net1.exe的区别&联系.
system32文件夹下有一个net.exe和net1.exe,一般做渗透的时候,很多情况下管理员只知道删除net.exe而遗漏net1.exe,导致我们能继续do evil..... 一直没弄明白它 ...
- 【ZZNU-oj-2116:人间不值得】(1亿以内的货币拼音转数值求折扣价原价)--hash+String大法好+字符串处理+超大暴力模拟题
B : 人间不值得 概览问题列表状态排名编辑 Progress Bar 时间限制:1 Sec 内存限制:256 MiB提交:146 答案正确:12 提交 编辑 题目描述 家缠万贯来几时,我今停杯一问之 ...
- MATLAB中.m文件生成.dll
1.配置编译环境 在命令行窗口输入: mbuild -setup 如果出现以下提示信息说明成功: 如果提示信息为: 错误使用mbuild(line 164) Unable to complete su ...
- Java 实现简单的SQL动态组装工具类
第一版 package com.zh.oukele.util; import java.util.HashMap; import java.util.Iterator; import java.uti ...