
论文笔记:Learning how to Active Learn: A Deep Reinforcement Learning Approach
Learning how to Active Learn: A Deep Reinforcement Learning Approach
2018-03-11 12:56:04
1. Introduction:
对于大部分 NLP 的任务,得到足够的标注文本来进行模型的训练是一个关键的瓶颈。所以,active learning 被引入到 NLP 任务中以最小化标注数据的代价。AL 的目标是通过识别一小部分数据来进行标注,以此来降低 cost,选来最小化监督模型的精度。
毫无疑问的是,AL 对于其他语言来说,特别是 low-resource languages,是非常重要的,因为其 annotation 通常很难获取,标注预算不太大。这种设置是 AL 很自然的应用,然而,很少有工作完成这个部分。一个潜在的原因是:大部分AL algorithm 需要 data 的一小部分作为 “seed set” 来学习一个基础的分类器,可以用于后续的主动数据选择(Active data selection)。然而,在低资源设定下给定匮乏的数据,这个假设使得标准的方法变的不可实施。
本文中,我们提出 PAL,简称:Policy based Active Learning,是一种新颖的方法来从数据中,学习一个 dynamic AL strategy。这使得该策略可以应用于其他设定,如:cross-lingual applications。我们的算法不需要一个固定的 heuristic,而是去学习如何主动地选择数据,构成了一个强化学习问题。一个智能的 agent,必须决定是否序列的选择数据进行标注,其中,决策策略是利用 deep Q-network 来学习的。该策略是利用观测到的:句子的内容信息(content information),监督模型的分类及其置信度(the supervised model's classifications and its confidence)。对应的,一个丰富、动态的策略可以通过标注决策的历史序列来进行标注新的数据中进行学习。
此外, 为了降低目标语言对数据的依赖,而且可能是 low resource,我们可以在另一个语言中AL的策略迁移到目标语言当中(we first learn the policy of active learning on another language and then transfer it to the target language)。在一个 high resource language 上学一个策略是很简单的,因为有大量的数据,如:English。我们构建cross-lingual word embeddings 来学习匹配的数据表示,使得学习到的策略可以轻易地移植到其他语言中。
我们的工作与前人在 NLP 上 AL 的探索不同。大部分前人的 AL algorithms 是研发以基于一种语言用于 NER tasks,然后用于该语言。另一个主要的不同在于,许多 AL algorithms 利用固定数据的启发式选择(use a fixed data selection heuristic),例如:不确定性采样(uncertainty sampling)。然而,在我们的算法中,我们显示的利用 uncertainty information 作为RL agent 的一个主要观测。
2. Methodology:
2.1 Active learning as a decision process
AL 是用于标注数据的简单算法,首先从一个未标注的数据集中选择一些 instances,然后通过一个人工环节来进行标注,然后依次循环,直至满足某一停止标准,即:the annotation budget is exhausted。通常,这个选择函数是基于某一预先训练模型的估计,此时已经在每一个阶段拟合标注的数据集,其中,数据点,是依赖于该模型的预测不确定性进行选择的(the datapoints are selected based on the model's predictive uncertainty),or divergence in predictions over an ensemble。这些方法的关键 idea 在于:find the instances on which the model is most likely to make errors, 即:找到使得模型最可能犯错的那些数据点。这样,在他们的标注以及包含后,该模型在此类 unseen data 上变的鲁棒。
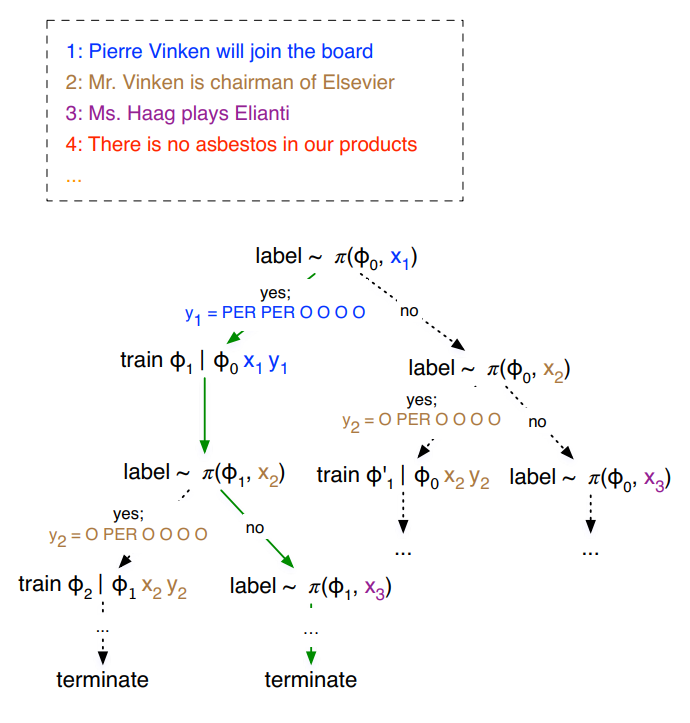
AL 算法的过程可以看做是 decision process,将 AL algorithm 看做是序列决策过程,AL的阶段对应系统的状态(the stages of active learning corresponding to the state of the system)。Accordingly,the state corresponds to the selected data for labelling and their labels, and each step in the active learning algorithm corresponding to a selction action, wherein the heuristic selects the next items from a pool. 当预算消耗完毕的时候,该过程终止。
2.2 Steam-based learning:
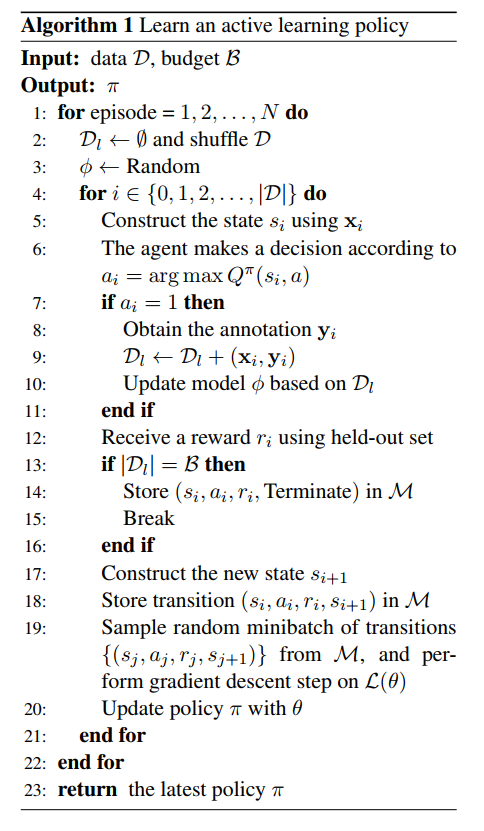
之所以会有这个假设,是因为想把 active learning 看做是序列决策问题,用 DRL 来解决。所以,这里抛弃了传统的基于 pool 的那种思路,用这种顺序处理的做法。
2.2.1 State:
由三个部分构成:
content representation : 用现有的 CNN 来提取句子的feature;
representation of marginals :
confidence of sequential prediction : 序列估计的置信度
2.2.2 Action:
动作就是选择 或者 不选择
2.2.3 Reward:
奖励是根据 held-out performance 进行评价的,即:根据选择某一动作后,是否使得验证集的性能得到了提升,给予 pos or neg 的奖励;
2.2.4 Budget:
总得需要标注的 instance 的个数
2.2.5 Reinforcement Learning:
这里用的就是 DQN 算法,具体可以参考其他博客。
2.3 Cross-lingual policy transfer :
这里进行跨语言策略迁移的目的是:为了处理数据量比较少的语言中的 active learning 问题。作者采用 Transfer learning 的方法,在数据量丰富的数据集上学习一个比较好的 policy,然后将这种策略应用到 数据量较少的 domain 或者 task 上。
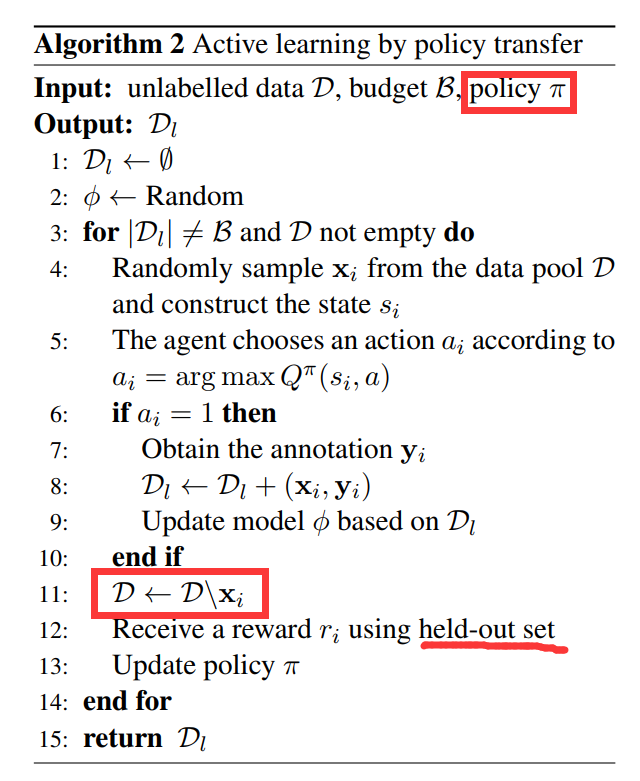
可以看到这个 Algorithm 2 与 Algorithm 1 很大的不同在于输入多了一个 policy,而这个 policy 是在 source language 上学习出来的。
2.4 Cold-start transfer :
以上迁移学习方法有如下两个局限性:
1. the requirement for held-out evaluation data ; 需要 held-out 数据
2. the embedding of the oracle annotation inside the learning loop 循环内部需要手动标注
前者意味着需要更多的监督信息,后者需要实时处理,并且需要人工参与。
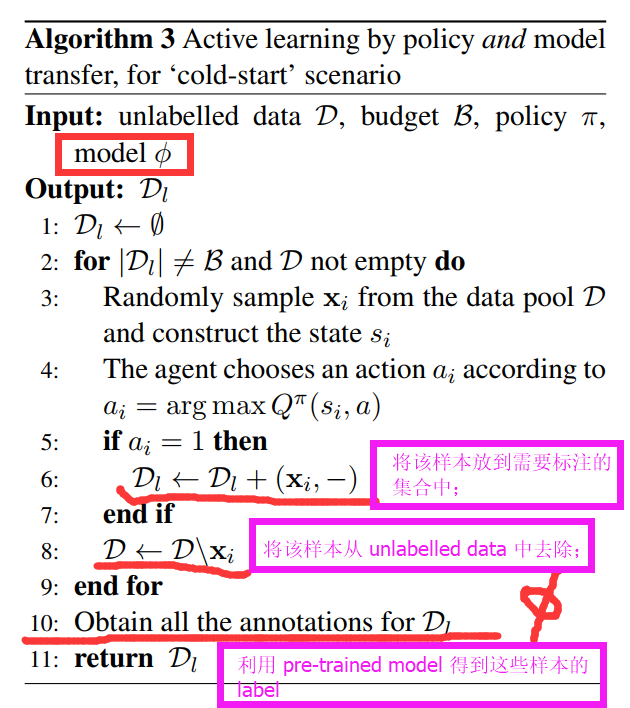
For this data and -communication-impverished setting, denoted as cold-start ,
==>> 我们仅仅允许一次给 target data 请求标注的机会;
==>> 不用 held-out data,不进行策略更新; 即: the agent can select a batch of unlabeled target instances for annotations, but can not use these resulting annotations or any other feedback to refine the selection.
在这种更加困难的情况下,我们采用 pre-trained model,使得 the agent 可以在缺乏 feedback 的情况下,做出更加具有信息量的决策。
论文笔记:Learning how to Active Learn: A Deep Reinforcement Learning Approach的更多相关文章
- 论文笔记之:Dueling Network Architectures for Deep Reinforcement Learning
Dueling Network Architectures for Deep Reinforcement Learning ICML 2016 Best Paper 摘要:本文的贡献点主要是在 DQN ...
- 论文笔记之:Active Object Localization with Deep Reinforcement Learning
Active Object Localization with Deep Reinforcement Learning ICCV 2015 最近Deep Reinforcement Learning算 ...
- 18 Issues in Current Deep Reinforcement Learning from ZhiHu
深度强化学习的18个关键问题 from: https://zhuanlan.zhihu.com/p/32153603 85 人赞了该文章 深度强化学习的问题在哪里?未来怎么走?哪些方面可以突破? 这两 ...
- 论文笔记之:Action-Decision Networks for Visual Tracking with Deep Reinforcement Learning
论文笔记之:Action-Decision Networks for Visual Tracking with Deep Reinforcement Learning 2017-06-06 21: ...
- Deep Reinforcement Learning for Visual Object Tracking in Videos 论文笔记
Deep Reinforcement Learning for Visual Object Tracking in Videos 论文笔记 arXiv 摘要:本文提出了一种 DRL 算法进行单目标跟踪 ...
- 论文笔记之:Asynchronous Methods for Deep Reinforcement Learning
Asynchronous Methods for Deep Reinforcement Learning ICML 2016 深度强化学习最近被人发现貌似不太稳定,有人提出很多改善的方法,这些方法有很 ...
- 论文笔记之:Deep Reinforcement Learning with Double Q-learning
Deep Reinforcement Learning with Double Q-learning Google DeepMind Abstract 主流的 Q-learning 算法过高的估计在特 ...
- 论文笔记之:Playing Atari with Deep Reinforcement Learning
Playing Atari with Deep Reinforcement Learning <Computer Science>, 2013 Abstract: 本文提出了一种深度学习方 ...
- 论文笔记之:Human-level control through deep reinforcement learning
Human-level control through deep reinforcement learning Nature 2015 Google DeepMind Abstract RL 理论 在 ...
随机推荐
- html5-块元素和内联元素
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8&qu ...
- 线程&进程
扯淡的yuan 并发&并行 并发:是指系统具有处理多个任务(动作)的能力. 并行:是指系统具有 同时 处理多个任务(动作)的能力. 同步&异步 同步:当进程执行到一个IO(等待外部数据 ...
- 反射--> 解析JSON数据
方法一 Persons.json文件 [ { "name": "Chris", "age": 18, "city": & ...
- .net nancy
官网 文档 入门教程 参考
- spring 源码导入eclipse
使用 gradle: ..opensource\v3.: 错误: 程序包org.apache.commons.pool.impl不存在 最后发现是依赖的包commons-pool没有配置.关键是刚用 ...
- python pprint
使用 pprint 模块 pprint 模块( pretty printer ) 用于打印 Python 数据结构. 当你在命令行下打印特定数据结构时你会发现它很有用(输出格式比较整齐, 便于阅读). ...
- python 文件路径名,文件名,后缀名的操作
需要使用路径名来获取文件名,目录名,绝对路径等等. 使用os.path 模块中的函数来操作路径名.下面是一个交互式例子来演示一些关键的特性: >>> import os >&g ...
- python mmap对象
----使用内存映射的原因 为了随机访问文件的内容,使用mmap将文件映射到内存中是一个高效和优雅的方法.例如,无需打开一个文件并执行大量的seek(),read(),write()调用,只需要简单的 ...
- 20165305 苏振龙《Java程序设计》第四周课上测试补做
第一次测试 第二次测试 第三次测试 上传代码 第四次测试 总结 之前我一直在git bash进行程序设计,但是对于我来说操作起来有点困难,所以我改用了虚拟机,之后之前一直困扰我的问题在虚拟机下就没有了 ...
- SQL表分区之一
一般情况下,我们建立数据库表时,表数据都存放在一个文件里. 但是如果是分区表的话,表数据就会按照你指定的规则分放到不同的文件里,把一个大的数据文件拆分为多个小文件,还可以把这些小文件放在不同的磁盘下由 ...