
Spark 2.0 PCA主成份分析
PCA在Spark2.0中用法比较简单,只需要设置:
.setInputCol(“features”)//保证输入是特征值向量

.setOutputCol(“pcaFeatures”)//输出

.setK()//主成分个数
注意:PCA前一定要对特征向量进行规范化(标准化)!!!
//Spark 2.0 PCA主成分分析

//注意:PCA降维前必须对原始数据(特征向量)进行标准化处理

package my.spark.ml.practice;

import org.apache.spark.ml.feature.PCA;

import org.apache.spark.ml.feature.PCAModel;//不是mllib

import org.apache.spark.ml.feature.StandardScaler;

import org.apache.spark.sql.Dataset;

import org.apache.spark.sql.Row;

import org.apache.spark.sql.SparkSession;

public class myPCA {

    public static void main(String[] args) {

        SparkSession spark=SparkSession

                .builder()

                .appName("myLR")

                .master("local[4]")

                .getOrCreate();

        Dataset<Row> rawDataFrame=spark.read().format("libsvm")

          .load("/home/hadoop/spark/spark-2.0.0-bin-hadoop2.6" +

                "/data/mllib/sample_libsvm_data.txt");

        //首先对特征向量进行标准化

        Dataset<Row> scaledDataFrame=new StandardScaler()

                  .setInputCol("features")

                  .setOutputCol("scaledFeatures")

                  .setWithMean(false)//对于稀疏数据(如本次使用的数据),不要使用平均值

                  .setWithStd(true)

                  .fit(rawDataFrame)

                  .transform(rawDataFrame);

        //PCA Model

        PCAModel pcaModel=new PCA()

                      .setInputCol("scaledFeatures")

                      .setOutputCol("pcaFeatures")

                      .setK()//

                      .fit(scaledDataFrame);

        //进行PCA降维

        pcaModel.transform(scaledDataFrame).select("label","pcaFeatures").show(,false);

    }

}

/**

 * 没有标准化特征向量,直接进行PCA主成分:各主成分之间值变化太大,有数量级的差别。

+-----+------------------------------------------------------------+

|label|pcaFeatures                                                 |

+-----+------------------------------------------------------------+

|0.0  |[-1730.496937303442,6.811910953794295,2.8044962135250024]   |

|1.0  |[290.7950975587044,21.14756134360174,0.7002807351637692]    |

|1.0  |[149.4029441007031,-13.733854376555671,9.844080682283838]   |

|1.0  |[200.47507801105797,18.739201694569232,22.061802015132024]  |

|1.0  |[236.57576401934855,36.32142445435475,56.49778957910826]    |

|0.0  |[-1720.2537550195714,25.318146742090196,2.8289957152580136] |

|1.0  |[285.94940382351075,-6.729431266185428,-33.69780131162192]  |

|1.0  |[-323.70613777909136,2.72250162998038,-0.528081577573507]   |

|0.0  |[-1150.8358810584655,5.438673892459839,3.3725913786301804]  |

 */

/**

 * 标准化特征向量后PCA主成分,各主成分之间值基本上在同一水平上,结果更合理

 |label|pcaFeatures                                                  |

+-----+-------------------------------------------------------------+

|0.0  |[-14.998868464839624,-10.137788261664621,-3.042873539670117] |

|1.0  |[2.1965800525589754,-4.139257418439533,-11.386135042845101]  |

|1.0  |[1.0254645688925883,-0.8905813756164163,7.168759904518129]   |

|1.0  |[1.5069317554093433,-0.7289177578028571,5.23152743564543]    |

|1.0  |[1.6938250375084654,-0.4350617717494331,4.770263568537382]   |

|0.0  |[-15.870371979062549,-9.999445137658528,-6.521920373215663]  |

|1.0  |[3.023279951602481,-4.102323190311296,-9.451729897327345]    |

|1.0  |[3.500670997961283,-4.1791886802435805,-9.306353932746568]   |

|0.0  |[-15.323114679599747,-16.83241059234951,2.0282183995400374]  |

*/
如何选择k值?
//PCA Model

        PCAModel pcaModel=new PCA()

                      .setInputCol("scaledFeatures")

                      .setOutputCol("pcaFeatures")

                      .setK()//

                      .fit(scaledDataFrame);

        int i=;

        for(double x:pcaModel.explainedVariance().toArray()){

        System.out.println(i+"\t"+x+"  ");

        i++;

        }

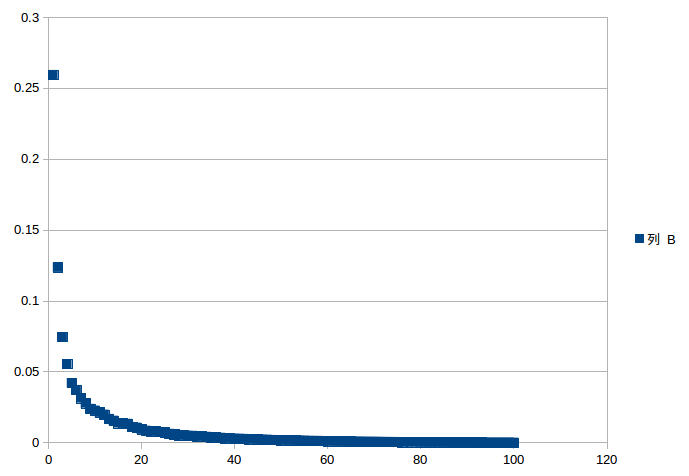
输出100个降序的explainedVariance(和scikit-learn中PCA一样):

   0.25934799275530857

   0.12355355301486977

   0.07447670060988294

   0.0554545717486928

   0.04207050513264405

   0.03715986573644129

   0.031350566055423544

   0.027797304129489515

   0.023825873477496748

  0.02268054946233242

  0.021320060154167115

  0.019764029918116235

  0.016789082901450734

  0.015502412597350008

  0.01378190652256973

  0.013539546429755526

  0.013283518226716669

  0.01110412833334044

...
大约选择20个主成分就足够了
随便做一个图可以选择了(详细可参考Scikit-learn例子)
http://scikit-learn.org/stable/auto_examples/plot_digits_pipe.html
Spark 2.0 PCA主成份分析的更多相关文章
- PCA主成份分析
1 背景介绍 真实的训练数据总是存在各种各样的问题: 1. 比如拿到一个汽车的样本,里面既有以“千米/每小时”度量的最大速度特征,也有“英里/小时”的最大速度特征,显然这两个特征有一个多余. 2. ...
- pca主成份分析方法
1.应用pca的前提 应用pca的前提是,连续信号具有相关性.相关性是什么,是冗余.就是要利用pca去除冗余. 2.pca的定义 pca是一种去除随机变量间相关性的线性变换.是一种常用的多元数据分析方 ...
- 【主成份分析】PCA推导
### 主成份分析(Pricipal components analysis PCA) 假设空间$R^{n}$中有m个点{$x^{1},......,x^{n}$},希望压缩,对每个$x^{i}$都有 ...
- PCA主成份分析学习记要
前言 主成份分析,简写为PCA(Principle Component Analysis).用于提取矩阵中的最主要成分,剔除冗余数据,同时降低数据纬度.现实世界中的数据可能是多种因数叠加的结果,如果这 ...
- principal components analysis 主成份分析
w http://deeplearning.stanford.edu/wiki/index.php/主成份分析 主成分分析(PCA)及其在R里的实现 - jicf的日志 - 网易博客 http:// ...
- 主成份分析PCA
Data Mining 主成分分析PCA 降维的必要性 1.多重共线性--预测变量之间相互关联.多重共线性会导致解空间的不稳定,从而可能导致结果的不连贯. 2.高维空间本身具有稀疏性.一维正态分布有6 ...
- 吴裕雄 python 机器学习——主成份分析PCA降维
# -*- coding: utf-8 -*- import numpy as np import matplotlib.pyplot as plt from sklearn import datas ...
- PCA(主成分析)
PCA通过将高维空间向量映射到低维,对于数据进行处理
- PCA--主成份分析
主成份分析(Principle Component Analysis)主要用来对数据进行降维.对于高维数据,处理起来比较麻烦,而且高维数据可能含有相关的维度,数据存在冗余,PCA通过把高维数据向低维映 ...
随机推荐
- jQuery中ajax的使用与缓存问题的解决方法
http://www.jb51.net/article/44620.htm —————————————————————————————————————————————————————————————— ...
- MySQL5.0、5.1、5.5、5.6功能进化
目前线上使用的版本情况:新上线端口统一使用5.5,不说别的,一个快速恢复重启就值回票价. 但因为历史原因还有大量5.1的版本,甚至,I’am sorry,还有少数5.0的版本. 至于5.0以前的版本, ...
- WebService的初级学习
复习准备 1. Schema约束: 1.1 namespace相当于Schema文件的id: 1.2 targetNamespace属性用来指定schema文件的namespace的值; 1. ...
- MFC存储图片到SQL Server数据库
第一步:建立数据库表,比如:id char,pic image. 第二步:建立MFC单文档应用程序,再添加类CMyRecordset,基类选择CRecordset,导入数据库的刚建立的表. 第三步:在 ...
- MFC WinInetHttp抓取网页代码内容
Windows Internet编程主要包括两方面: l 服务器端 l 客户端 WinInet编程 Internet客户端主要实现的功能,主要是通过Internet协议(HTTP.FTP等)获 ...
- 使用cordova+Ionic+AngularJs进行Hybird App开发的环境搭建手冊
一.所需工具 1,JDK:生成 2.安卓SDK开发环境 3,NodeJs:主要使用的还是npm 4,Python开发环境 5.VS 2012(2008,2015也能够,已亲測):安装这个主要是须要一些 ...
- UE4 Multiplayer多人局域网LAN联机打包参数设置
需要注意几点: A. 建好后我们先到项目根目录,在Config文件夹中的DefaultEngine.ini文件加上两行: [OnlineSubsystem] DefaultPlatformServi ...
- 了解 IMyInterface.Stub
Service中的IBinder 还记得我们在MyService中利用new IMyInterface.Stub()向上转型成了IBinder然后在onBind方法中返回的.那我们就看看IMyInte ...
- C语言二维数组
上节讲解的数组可以看作是一行连续的数据,只有一个下标,称为一维数组.在实际问题中有很多数据是二维的或多维的,因此C语言允许构造多维数组.多维数组元素有多个下标,以确定它在数组中的位置.本节只介绍二维数 ...
- Leetcode-Bianry Tree Maximum Path Sum
Given a binary tree, find the maximum path sum. The path may start and end at any node in the tree. ...