
6、DRN-----深度强化学习在新闻推荐上的应用
1、摘要:
提出了一种新的深度强化学习框架的新闻推荐。由于新闻特征和用户喜好的动态特性,在线个性化新闻推荐是一个极具挑战性的问题。
虽然已经提出了一些在线推荐模型来解决新闻推荐的动态特性,但是这些方法主要存在三个问题:①只尝试模拟当前的奖励(eg:点击率)②很少考虑使用除了点击 / 不点击标签之外的用户反馈来帮助改进推荐。③ 这些方法往往会向用户推荐类似消息,这可能会导致用户感到厌烦。
基于深度强化学习的推荐框架,该框架可以模拟未来的奖励(点击率)
2、引言:
新闻推荐三个问题:
(1)新闻推荐的动态变化是难以处理的。
(2)用户的兴趣可能随着时间的变化而变化。
(3)创新
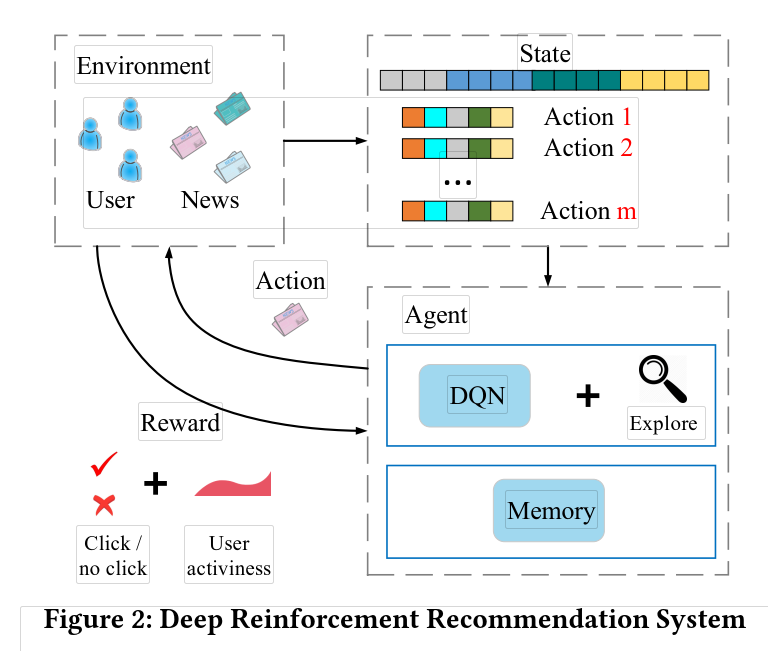
强化学习:假定一个智能体(agent),在一个未知的环境中(当前状态state),采取了一个行动(action),然后收获了一个回报(reward),并进入了下一个状态。最终目的是求解一个策略让agent的回报最大化。
因此,本文提出了基于深度强化学习的推荐系统框架来解决上述提到的三个问题:
(1)首先,使用DQN网络来有效建模新闻推荐的动态变化属性,DQN可以将短期回报和长期回报进行有效的模拟。
(2)将用户活跃度作为一种新的反馈信息。
(3)使用Dueling Bandit Gradient Descent 方法来进行有效的探索。
算法的框架如下图所示:
3、问题描述:
当一个用户 u 在时间 t 向推荐系统 G 发送一个新闻请求,系统会利用一个给定的新闻候选集 I 给用户推荐一个 top-k 列表给用户。
4、模型方法:
4.1 整体架构图:
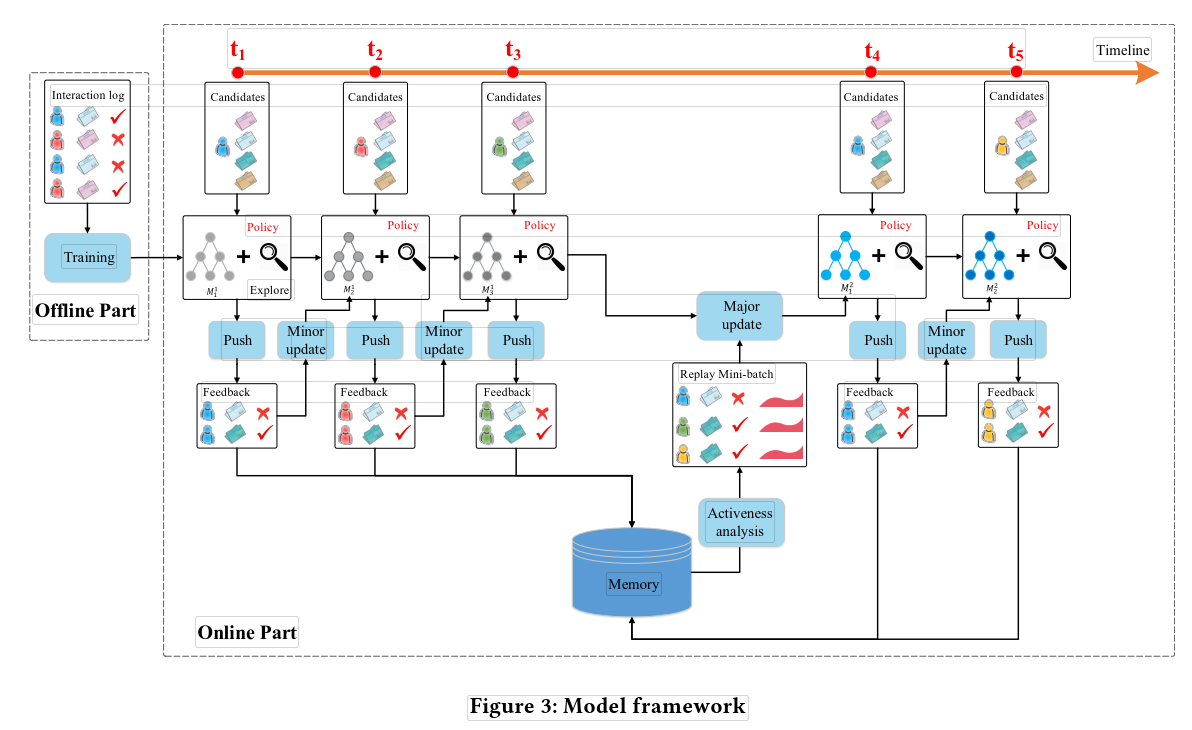
几个关键环节:
push:在每一个时刻,用户发送请求时,agent根据当前的state产生k篇新闻推荐给用户。
Feedback:通过用户对推荐新闻的点击行为得到反馈结果。
minor update:在每个时间点过后,根据用户的信息(state)和推荐的新闻(action)以及得到的反馈(reward),更新参数。
major update:在一段时间后,根据DQN的经验池中存放的历史经验,对模型参数进行更新。
6、DRN-----深度强化学习在新闻推荐上的应用的更多相关文章
- 一文读懂 深度强化学习算法 A3C (Actor-Critic Algorithm)
一文读懂 深度强化学习算法 A3C (Actor-Critic Algorithm) 2017-12-25 16:29:19 对于 A3C 算法感觉自己总是一知半解,现将其梳理一下,记录在此,也 ...
- (转) 深度强化学习综述:从AlphaGo背后的力量到学习资源分享(附论文)
本文转自:http://mp.weixin.qq.com/s/aAHbybdbs_GtY8OyU6h5WA 专题 | 深度强化学习综述:从AlphaGo背后的力量到学习资源分享(附论文) 原创 201 ...
- 深度强化学习(Deep Reinforcement Learning)入门:RL base & DQN-DDPG-A3C introduction
转自https://zhuanlan.zhihu.com/p/25239682 过去的一段时间在深度强化学习领域投入了不少精力,工作中也在应用DRL解决业务问题.子曰:温故而知新,在进一步深入研究和应 ...
- 深度强化学习(DRL)专栏(一)
目录: 1. 引言 专栏知识结构 从AlphaGo看深度强化学习 2. 强化学习基础知识 强化学习问题 马尔科夫决策过程 最优价值函数和贝尔曼方程 3. 有模型的强化学习方法 价值迭代 策略迭代 4. ...
- 深度强化学习(DRL)专栏开篇
2015年,DeepMind团队在Nature杂志上发表了一篇文章名为"Human-level control through deep reinforcement learning&quo ...
- 深度强化学习中稀疏奖励问题Sparse Reward
Sparse Reward 推荐资料 <深度强化学习中稀疏奖励问题研究综述>1 李宏毅深度强化学习Sparse Reward4 强化学习算法在被引入深度神经网络后,对大量样本的需求更加 ...
- 【资料总结】| Deep Reinforcement Learning 深度强化学习
在机器学习中,我们经常会分类为有监督学习和无监督学习,但是尝尝会忽略一个重要的分支,强化学习.有监督学习和无监督学习非常好去区分,学习的目标,有无标签等都是区分标准.如果说监督学习的目标是预测,那么强 ...
- 深度学习课程笔记(十四)深度强化学习 --- Proximal Policy Optimization (PPO)
深度学习课程笔记(十四)深度强化学习 --- Proximal Policy Optimization (PPO) 2018-07-17 16:54:51 Reference: https://b ...
- 深度学习课程笔记(十三)深度强化学习 --- 策略梯度方法(Policy Gradient Methods)
深度学习课程笔记(十三)深度强化学习 --- 策略梯度方法(Policy Gradient Methods) 2018-07-17 16:50:12 Reference:https://www.you ...
随机推荐
- Spark作业执行
Spark中一个action触发一个job的执行,在job提交过程中主要涉及Driver和Executor两个节点. Driver主要解决 1. RDD 依赖性分析,生成DAG. 2. 根据RDD D ...
- C语言基础 (4) 原码反码补码与数据类型
1.回顾 使用gcc编译代码 gcc hello.c -o hello windows下编译代码 C语言编译步骤: 预处理(头文件展开,干掉注释) gcc -E hello.c -o hello.i ...
- Shell(一)变量
一.简介 Shell 是一个用 C 语言编写的程序,它是用户使用 Linux 的桥梁.Shell 既是一种命令语言,又是一种程序设计语言. Shell 是指一种应用程序,这个应用程序提供了一个界面,用 ...
- 利用GitHub搭建Hexo博客并开启HTTPS
Hexo 是一个快速.简洁且高效的博客框架.Hexo 使用 Markdown(或其他渲染引擎)解析文章,在几秒内,即可利用靓丽的主题生成静态网页. GitHub 是一个面向开源及私有软件项目的托管平台 ...
- STM32利用TIM3产生一个1--100Hz可调频率
目标:利用TIM3结合普通GPIO实现一个1--100HZ的可控频率,误差在0.5HZ以内 核心:要实现该功能首先要明确频率的定义,频率就是1秒内发生周期性变化的次数,例如一个正弦波,1S内,走了15 ...
- iText、poi操作word2007(读取,生成)
关于生成word文件以及插入文字.表格.图片等功能,我使用了poi和itext,因为poi插入图片的jar包我在网上查并不是太完全,也可能我没找到如何使用,所以插入图片我用的是itext iText所 ...
- POI 详细介绍
Apache POI是一个开源的Java读写Excel.WORD等微软OLE2组件文档的项目.目前POI已经有了Ruby版本. 结构: HSSF - 提供读写Microsoft Excel XLS格式 ...
- springmvc 异常Interceptor
无论做什么项目,进行异常处理都是非常有必要的,而且你不能把一些只有程序员才能看懂的错误代码抛给用户去看,所以这时候进行统一的异常处理,展现一个比较友好的错误页面就显得很有必要了. springMVC提 ...
- spring boot基础
1.ANT下面典型的项目层次结构.(1) src存放文件.(2) class存放编译后的文件.(3) lib存放第三方JAR包.(4) dist存放打包,发布以后的代码. 2.Source Folde ...
- 从零開始学android<TabHost标签组件.二十九.>
TabHost主要特点是能够在一个窗体中显示多组标签栏的内容,在Android系统之中每一个标签栏就称为一个Tab.而包括这多个标签栏的容器就将其称为TabHost.TabHost类的继承结构例如以下 ...