
python-爬虫(3)---lxml匹配css
百度首页 部分代码
<div class="s_tab_inner">
<b>网页</b>
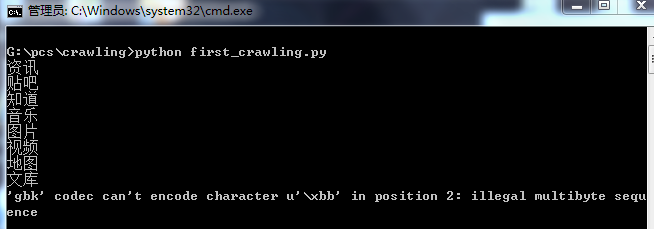
<a href="//www.baidu.com/s?rtt=1&bsst=1&cl=2&tn=news&word=" wdfield="word" onmousedown="return c({'fm':'tab','tab':'news'})" sync="true">资讯</a>
<a href="http://tieba.baidu.com/f?kw=&fr=wwwt" wdfield="kw" onmousedown="return c({'fm':'tab','tab':'tieba'})">贴吧</a>
<a href="http://zhidao.baidu.com/q?ct=17&pn=0&tn=ikaslist&rn=10&word=&fr=wwwt" wdfield="word" onmousedown="return c({'fm':'tab','tab':'zhidao'})">知道</a>
<a href="http://music.taihe.com/search?fr=ps&ie=utf-8&key=" wdfield="key" onmousedown="return c({'fm':'tab','tab':'music'})">音乐</a>
<a href="http://image.baidu.com/search/index?tn=baiduimage&ps=1&ct=201326592&lm=-1&cl=2&nc=1&ie=utf-8&word=" wdfield="word" onmousedown="return c({'fm':'tab','tab':'pic'})">图片</a>
<a href="http://v.baidu.com/v?ct=301989888&rn=20&pn=0&db=0&s=25&ie=utf-8&word=" wdfield="word" onmousedown="return c({'fm':'tab','tab':'video'})">视频</a>
<a href="http://map.baidu.com/m?word=&fr=ps01000" wdfield="word" onmousedown="return c({'fm':'tab','tab':'map'})">地图</a>
<a href="http://wenku.baidu.com/search?word=&lm=0&od=0&ie=utf-8" wdfield="word" onmousedown="return c({'fm':'tab','tab':'wenku'})">文库</a>
<a href="//www.baidu.com/more/" onmousedown="return c({'fm':'tab','tab':'more'})">更多»</a>
</div>

根据css查找符合条件的内容
python-爬虫(3)---lxml匹配css的更多相关文章
- Python爬虫——使用 lxml 解析器爬取汽车之家二手车信息
本次爬虫的目标是汽车之家的二手车销售信息,范围是全国,不过很可惜,汽车之家只显示100页信息,每页48条,也就是说最多只能够爬取4800条信息. 由于这次爬虫的主要目的是使用lxml解析器,所以在信息 ...
- Python爬虫基础——HTML、CSS、JavaScript、JQuery网页前端技术
一.HTML HTML是Hyper Text Markup Language(超文本标记语言)的缩写. HTML不是一种编程语言,而是标记语言. HTML的语法 双标签: 单标签: HTML的元素和属 ...
- Python爬虫-换行的匹配
之前在学习爬虫的时候遇到了匹配内容时发现存在换行,这时没法匹配了,后来在网上找到了一种方法,当时懒得记录,今天突然有遇到了这种情况,想想还是在这里记录一下吧. 当时爬取的时csdn首页博客,如下图 看 ...
- Python爬虫使用lxml模块爬取豆瓣读书排行榜并分析
上次使用了BeautifulSoup库爬取电影排行榜,爬取相对来说有点麻烦,爬取的速度也较慢.本次使用的lxml库,我个人是最喜欢的,爬取的语法很简单,爬取速度也快. 本次爬取的豆瓣书籍排行榜的首页地 ...
- python爬虫网页解析之lxml模块
08.06自我总结 python爬虫网页解析之lxml模块 一.模块的安装 windows系统下的安装: 方法一:pip3 install lxml 方法二:下载对应系统版本的wheel文件:http ...
- [爬虫]Windows下如何安装python第三方库lxml
lxml是个非常有用的python库,它可以灵活高效地解析xml与BeautifulSoup.requests结合,是编写爬虫的标准姿势. 但是,当lxml遇上Windows,简直是个巨坑.掉在安装陷 ...
- python爬虫入门(三)XPATH和BeautifulSoup4
XML和XPATH 用正则处理HTML文档很麻烦,我们可以先将 HTML文件 转换成 XML文档,然后用 XPath 查找 HTML 节点或元素. XML 指可扩展标记语言(EXtensible Ma ...
- 【转】Python爬虫:抓取新浪新闻数据
案例一 抓取对象: 新浪国内新闻(http://news.sina.com.cn/china/),该列表中的标题名称.时间.链接. 完整代码: from bs4 import BeautifulSou ...
- Python爬虫与数据分析之爬虫技能:urlib库、xpath选择器、正则表达式
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
随机推荐
- nodejs入门篇之linux版的nodejs简易环境安装部署
第一步:下载二进制安装包 根据linux的不同版本选择32位或64位,因为我的linux的虚拟机是64位的,所以我选择的是64位二进制安装文件(Linux Binariesx64),可以右键选择在新窗 ...
- IDEA 2018.2.5最新版破解到2100年图解教程
先看下我破解后的效果图 把下载的破解补丁放在你的idea的安装目录下的bin的目录下面(如下图所示),本文示例为F:\ProgramFiles\JetBrains\IntelliJ IDEA 2018 ...
- 友元(friend)
1.友元类的关系不能传递和继承 ...待续
- with(window) onload=onresize=function(){} 写法
with(window) onload=onresize=function(){} 写法 with的用法: with(对象A) { 语句块 } 语句块中可以直接使用 对象A中的属性和方法 ------ ...
- vue_v-for_遍历数组_遍历对象
1. v-for 遍历数组 html <div id="test"> <ul> <li v-for="(p, index) in perso ...
- Windows 2012 下Redmine安装和环境搭建
公司在过去一年中处于高速发展创业期,对于技术管理和项目管理没有找到一个很好的管理工具,使用过Teanbition+禅道+SVM的集成管理工具,但是明显各工具之间联系性差,断层严重,不能很好的形成团队成 ...
- WordCount测试项目小结
一.本文对应项目GitHub地址 https://github.com/ReWr1te/WCProject 请参照最新版本(WCProject4.0) 二.项目PSP表格 PSP2.1 PSP阶段 预 ...
- apache-2.4.6 mod_bw-0.92 实现限速上传或下载
下载 mod_bw wget http://ivn.cl/files/source/mod_bw-0.92.tgz 解压到mod_bw tar -zxvf mod_bw-0.92.tgz -C mo ...
- 字符串Hash || BZOJ 3555: [Ctsc2014]企鹅QQ || P4503 [CTSC2014]企鹅QQ
题面:[CTSC2014]企鹅QQ 题解:无 代码: #include<iostream> #include<cstring> #include<cstdio> # ...
- 报文分析5、UDP协议的头结构
UDP协议的头结构 源端口(2字节) 目的端口(2字节) 封报长度(2字节) 校验和(2字节) 数据 (1)源端口(Source Port):16位的源端口域包含初始化通信的端口号.源端口和IP地址的 ...