
MySQL查询优化之性能提升一个数量级
这段时间一直在用kettle做数据抽取和报表,写SQL便是家常便饭了,200行+SQL经常要写。甚至写过最长的一个SQL500多行将近600行。这么长的SQL估计大部分人连看的意愿都没有,读起来也比较坑爹,我一般是把这种长SQL分成几个子SQL,测试好了再组装起来。SQL语句写的越多也就越可能出现性能问题。优化SQL可以从很多细节入手,比如加索引,但也不是万能的,当SQL达到一定规模,从结构上优化才是根本解决问题的办法,当然前提是改加的索引已经加了,大部分可以从局部优化的细节已经注意到了。
和往常一样,一个新的需求需要从大概10个表中抽取数据,大部分表数据量都在四十万左右,最多的表有100万左右。说真的数据并不算多,但是这么多遍连接后,如果SQL有的有问题查询效率也是非常低的。一开始我按照自己的思路写了一个SQL,只考虑需求和最短时间内实现。
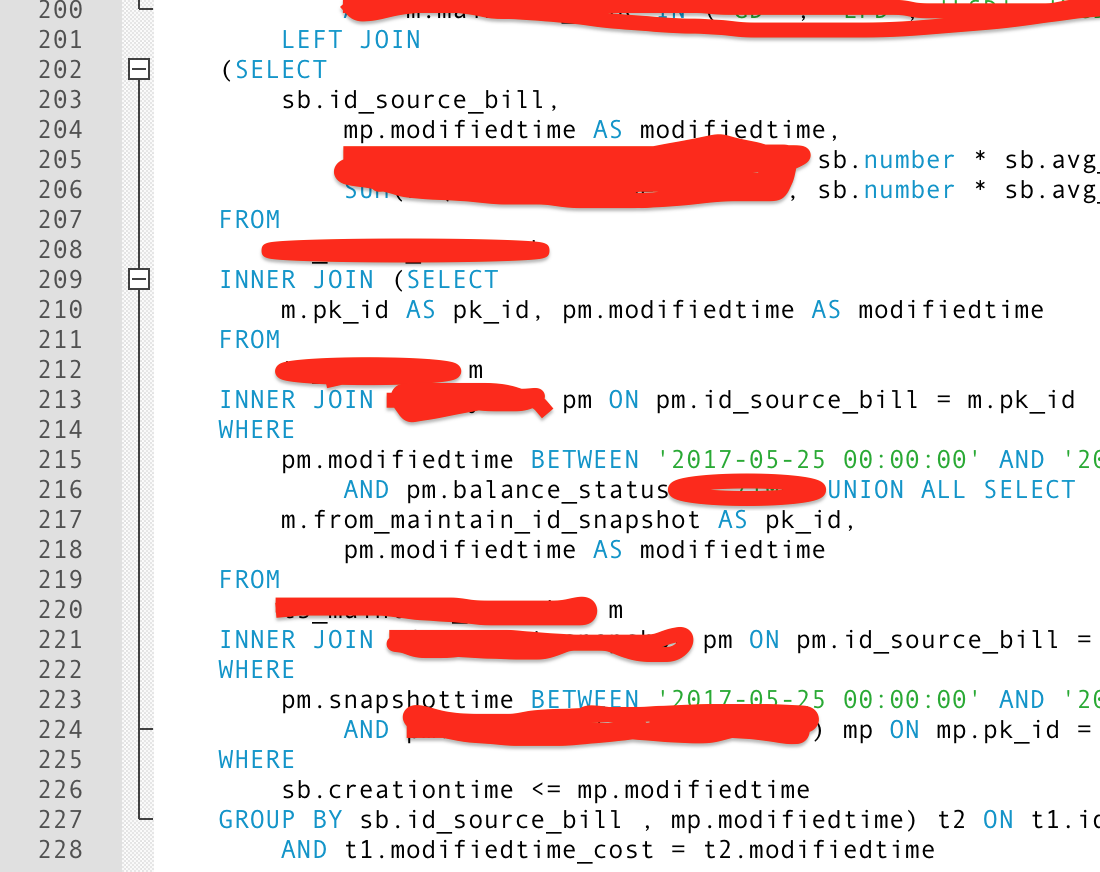
部分SQL如下图,SQL已经超过200行了:
执行结果如下图:

只查询了38行记录,尽然花了将近10s,感觉已经很慢了。
此时我精简SQL的大概结构如下:
 SELECT

    *

FROM

    (SELECT

        *

    FROM

        A m

    INNER JOIN B pm ON pm.id_sour = m.pk_id

    LEFT JOIN (SELECT

        *

    FROM

        C

    WHERE

        is_bring IS NULL OR is_bring = 0

    GROUP BY id_m) pd ON m.pk_id = pd.id_m

    LEFT JOIN (SELECT

        *

    FROM

        D sd

    INNER JOIN E si ON sd.id_ser = si.pk_id

    GROUP BY sd.id_m) sd ON m.pk_id = sd.id_m

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('') UNION ALL SELECT

        *

    FROM

        F m

    INNER JOIN G pm ON pm.id_sour = m.pk_id

    LEFT JOIN (SELECT

        *

    FROM

        H

    WHERE

        is_bring IS NULL OR is_bring = 0

    GROUP BY id_m) pd ON m.pk_id = pd.id_m

    LEFT JOIN (SELECT

        *

    FROM

        I sd

    INNER JOIN E si ON sd.id_ser = si.pk_id

    GROUP BY sd.id_m) sd ON m.pk_id = sd.id_m

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('') UNION ALL SELECT

            *

    FROM

        F m

    INNER JOIN G pm ON pm.id_sour = m.pk_id

    LEFT JOIN (SELECT

        *

    FROM

        H

    WHERE

        is_bring IS NULL OR is_bring = 0

    GROUP BY id_m) pd ON m.pk_id = pd.id_m

    LEFT JOIN (SELECT

        *

    FROM

        I sd

    INNER JOIN E si ON sd.id_ser = si.pk_id

    GROUP BY sd.id_m) sd ON m.pk_id = sd.id_m

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('')) t1

        LEFT JOIN

    (SELECT

        *

    FROM

        J sb

    INNER JOIN (SELECT

        m.pk_id AS pk_id, pm.m_time AS m_time

    FROM

        A m

    INNER JOIN B pm ON pm.id_sour = m.pk_id

    WHERE

        pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND pm.status = '' UNION ALL SELECT

        m.from_mid_sn AS pk_id,

            pm.m_time AS m_time

    FROM

        F m

    INNER JOIN G pm ON pm.id_sour = m.pk_id

    WHERE

        pm.time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND pm.status = '') mp ON mp.pk_id = sb.id_sour

    WHERE

        sb.c_time <= mp.m_time

    GROUP BY sb.id_sour , mp.m_time) t2 ON t1.id_m = CAST(t2.id_sour AS CHAR)

        AND t1.m_time_cost = t2.m_time
再精简一下结构如下:
SELECT

    *

FROM

    (SELECT

        *

    FROM

        A UNION ALL SELECT

        *

    FROM

        B UNION ALL SELECT

        *

    FROM

        C) t1

        LEFT JOIN

    ((SELECT

        *

    FROM

        D)

    INNER JOIN (SELECT

        *

    FROM

        E UNION ALL SELECT

        *

    FROM

        F) t2 ON t1.id = t2.id) t3 ON t1.tid = t3.id
其中上面的A、B、C、D、E、F都是10个表中多个表的连接查询的结果。其实以上SQL在我们实现的时候就做过简单的优化了,t3其实可以放进t1中分别和A、B、C连接。但其实A、B、C、已经连接好多表了,在分别连接t3性能会产生更多的数据,效率会更低。
由于是数据抽取,数据只是存储到指定的事实表中。因此对效率没太高的要求,一分钟之内都是可以接受的。本来想这样就算了,还有堆事要干。恰好手里有一段类似逻辑的SQL,但是不完全一样。然后我就跑了一下。发现比我写的快一个数量级,大吃一惊之余我决定探索一下原因。
精简优化过的SQL代码如下:
SELECT

    *

FROM

    (SELECT

        *

    FROM

        A m

    INNER JOIN (SELECT * FROM B where is_del = 0 AND m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('') UNION ALL SELECT

        *

    FROM

        F m

    INNER JOIN (SELECT * FROM G where is_del = 0 AND m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.s_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('')) mm

        LEFT JOIN

    (SELECT

        *

    FROM

        J sb

    INNER JOIN (SELECT

        m.pk_id AS pk_id, pm.m_time AS m_time

    FROM

        A m

    INNER JOIN B pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND m.type IN ('')

            AND m.is_del = 0

            AND m.is_mig = 0

            AND pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59' UNION ALL SELECT

        m.from_mid_sn AS pk_id,

            pm.m_time AS m_time

    FROM

        F m

    INNER JOIN (SELECT * FROM G where is_del = 0 AND m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND m.type IN ('')

            AND m.is_del = 0

            AND m.is_mig = 0

            AND pm.s_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') mp ON mp.pk_id = sb.id_sour

    WHERE

        sb.c_time <= mp.m_time

    GROUP BY sb.id_sour , mp.m_time) cost ON cost.id_sour = mm.id_m

        AND cost.m_time = mm.m_time_cost

        LEFT JOIN

    (SELECT

        *

    FROM

        D sd

    INNER JOIN E si ON sd.id_ser = si.pk_id

    INNER JOIN (SELECT DISTINCT

        *

    FROM

        A m

    INNER JOIN B pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND m.type IN ('')

            AND m.is_del = 0

            AND m.is_mig = 0

            AND pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') ms ON sd.id_m = ms.pk_id

    GROUP BY sd.id_m UNION ALL SELECT

        *

    FROM

        I sd

    INNER JOIN E si ON sd.id_ser = si.pk_id

    INNER JOIN (SELECT DISTINCT

        m.pk_id, from_mid_sn, pm.m_time

    FROM

        F m

    INNER JOIN G pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND m.type IN ('')

            AND m.is_del = 0

            AND m.is_mig = 0

            AND pm.s_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') ms ON sd.id_m = ms.pk_id

    GROUP BY sd.id_m) ser ON ser.id_m = mm.id_m

        AND ser.m_time = mm.m_time_cost

        LEFT JOIN

    (SELECT

        *

    FROM

        C pd

    INNER JOIN (SELECT DISTINCT

        m.pk_id, pm.m_time

    FROM

        A m

    INNER JOIN B pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND m.type IN ('')

            AND m.is_del = 0

            AND m.is_mig = 0

            AND pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') ms ON ms.pk_id = pd.id_m

    WHERE

        is_bring IS NULL OR is_bring = 0

    GROUP BY pd.id_m , ms.m_time UNION ALL SELECT

        *

    FROM

        H pd

    INNER JOIN (SELECT DISTINCT

        m.pk_id, pm.m_time, from_mid_sn

    FROM

        F m

    INNER JOIN G pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND m.type IN ('')

            AND m.is_del = 0

            AND m.is_mig = 0

            AND pm.s_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') ms ON ms.pk_id = pd.id_m

    WHERE

        is_bring IS NULL OR is_bring = 0

    GROUP BY pd.id_m) part ON part.id_m = mm.id_m

        AND part.m_time = mm.m_time_cost
运行此代码结果如下:

同样的结果,效率整整提升了一个数量级,哇咔咔。。。其实写出之前让我参考的效率较高的SQL的一位妹子。在我公司,大家称之为SQL女神,果然名不虚传。佩服之余我要要要学习一下。
仔细分析以上优化过的SQL,其实是巧妙的使用了某种规律,我称之为---SQL分配率和结合律。
最左侧的子SQL(或者临时表:mm)如下:
SELECT

        *

    FROM

        A m

    INNER JOIN (SELECT * FROM B where is_del = 0 AND m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('') UNION ALL SELECT

        *

    FROM

        F m

    INNER JOIN (SELECT * FROM G where is_del = 0 AND m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.s_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('') UNION ALL SELECT

        *

    FROM

        F m

    INNER JOIN (SELECT * FROM G where is_del = 0 AND m_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59') pm ON pm.id_sour = m.pk_id

    WHERE

        pm.status = ''

            AND pm.is_del = 0

            AND pm.s_time BETWEEN '2017-05-25 00:00:00' AND '2017-05-25 23:59:59'

            AND m.type IN ('')
其实38条数据的结果,在以上子SQL就已经确定了,因此后面的LEFT JOIN或INNER JOIN,JOIN的数据都会比较少,效率自然高。相对于优化前的写法,以上子SQL各自还连接了一堆相同的表。现在把这堆相同的表提到最外面做一次连接。这里体现的是SQL结合律。
总结:当SQL规模比较庞大时,良好的SQL结构能大大提升执行的效率。并且SQL的优化也不是一蹴而就,也是一个循序渐进不断尝试的过程。以上SQL不一定就是最优,此处并没有谈SQL语法最佳使用细节。具体可参考以下链接。
https://dev.mysql.com/doc/refman/5.7/en/optimization.html
MySQL查询优化之性能提升一个数量级的更多相关文章
- 如何把 MySQL 备份验证性能提升 10 倍
JuiceFS 非常适合用来做 MySQL 物理备份,具体使用参考我们的官方文档.最近有个客户在测试时反馈,备份验证的数据准备(xtrabackup --prepare)过程非常慢.我们借助 Juic ...
- MySQL 8.0 —— CATS事务调度算法的性能提升
原文地址:https://mysqlserverteam.com/contention-aware-transaction-scheduling-arriving-in-innodb-to-boost ...
- oracle 11g亿级复杂SQL优化一例(数量级性能提升)
自从16年之后,因为工作原因,项目中就没有再使用oracle了,最近最近支持一个项目,又要开始负责这块事情了.最近在跑性能测试,配置全部调好之后,不少sql还存在性能低下的问题,主要涉及执行计划的不合 ...
- huge page 能给MySQL 带来性能提升吗?
最近一直在做性能压测相关的事情,有公众号的读者朋友咨询有赞的数据库服务器有没有开启huge page,我听说过huge page会对性能有所提升,本文就一探究竟.对过程没有兴趣的可以直接看结论. 二 ...
- 用一个性能提升了666倍的小案例说明在TiDB中正确使用索引的重要性
背景 最近在给一个物流系统做TiDB POC测试,这个系统是基于MySQL开发的,本次投入测试的业务数据大概10个库约900张表,最大单表6千多万行. 这个规模不算大,测试数据以及库表结构是用Dump ...
- 在MongoDB中创建一个索引而性能提升1000倍的小例子
在https://www.cnblogs.com/xuliuzai/p/9965229.html的博文中我们介绍了MongoDB的常见索引的创建语法.部分同学还想看看MongoDB的威力到底有多大,所 ...
- 如何提升mysql replication的性能&多线程传输二进制日志
1,最好使用内网或者专线链路传输binlog数据 (千兆网卡.还不够的话,bounding 技术,扩展带宽) 在my.cnf中强制使用内网ip传输数据bind-address=ip2,将二进制保存在独 ...
- 查询性能提升3倍!Apache Hudi 查询优化了解下?
从 Hudi 0.10.0版本开始,我们很高兴推出在数据库领域中称为 Z-Order 和 Hilbert 空间填充曲线的高级数据布局优化技术的支持. 1. 背景 Amazon EMR 团队最近发表了一 ...
- mysql查询优化之二:查询优化器的局限性
在<mysql查询优化之一:mysql查询优化常用方式>一文中列出了一些优化器常用的优化手段.查询优化器在提供这些特性的同时,也存在一定的局限性,这些局限性往往会随着MySQL版本的升级而 ...
随机推荐
- go-001-环境部署,IDEA插件
一.下载安装 https://golang.org/dl/ 下载之后安装即可 官网地址:https://golang.org/ 1.1.mac上安装go 1.安装Homebrew 安装命令: ruby ...
- Scala系统学习(五):Scala访问修辞符
本章将介绍Scala访问修饰符.包,类或对象的成员可以使用私有(private)和受保护(protected)的访问修饰符进行标注,如果不使用这两个关键字的其中一个,那么访问将被视为公开(public ...
- 图文解析Spark2.0核心技术(转载)
导语 Spark2.0于2016-07-27正式发布,伴随着更简单.更快速.更智慧的新特性,spark 已经逐步替代 hadoop 在大数据中的地位,成为大数据处理的主流标准.本文主要以代码和绘图的方 ...
- CentOS6.7上安装Mysql5.7
CentOS6.7上安装Mysql5.7 2017年07月22日 18:27:05 阅读数:564 环境的配置总是令人作呕,所以这次表明版本条件: 首先,这是一台新机器 其次,CentOS版本如下: ...
- [LeetCode] 256. Paint House_Easy tag: Dynamic Programming
There are a row of n houses, each house can be painted with one of the three colors: red, blue or gr ...
- “在引用COM组件时,出现了无法嵌入互操作类型。。。”的错误
这两天在做一个需要将wps文档转换成word文档的程序,在调用wps的com组件时项目编译是没有问题的,但当运行的时候却弹出了下面的错误提示: 从网上百度一番后,找到了正确的解决方法. 先从Com组件 ...
- keras自定义padding大小
1.keras卷积操作中border_mode的实现 def conv_output_length(input_length, filter_size, border_mode, stride): i ...
- 奋斗史-IT女生是怎样炼成的
IT女生的奋斗史 终于来到了毕业季,感觉有点伤感! 记得11年来到大学的时候,还是那么懵懂,什么都不懂,几乎连电脑的基本操作都不会!自己小时候虽然家里穷,但是从小就觉得“软件”是个很神奇的东西,很了不 ...
- php mysqli query 查询数据库后读取内容的方法
php mysqli query 查询数据库后读取内容的方法 <?php$mysqli = new mysqli("localhost", "my_user&quo ...
- ACM题目————区间覆盖问题
题目描述 设x1 , x2,... , xn是实直线上的n个点.用固定长度的闭区间覆盖这n个点,至少需要多少个这样的固定长度闭区间?设计解此问题的有效算法,并证明算法的正确性.编程任务:对于给定的实直 ...