
Spark MLib 基本统计汇总 2
4. 假设检验
基础回顾:
- 假设检验,用于判断一个结果是否在统计上是显著的、这个结果是否有机会发生。
- 显著性检验
- 原假设与备择假设
常把一个要检验的假设记作 H0,称为原假设(或零假设) (null hypothesis)
与H0对立的假设记作H1,称为备择假设(alternative hypothesis)
- 拟合优度Goodness of Fit,是指回归直线对观测值的拟合程度。
对非线性方程:
(1)计算残差平方和 Q =∑(y-y*)2 和 ∑y2 ,其中,y 代表的是实测值,y* 代表的是预测值
(2)拟合度指标 RNew=1-(Q/∑y2)1/2
角标new就是为了和线性回归方程的判定系数R2、adjusted R2进行区别。在对方程拟合程度的解释上,Rnew和R2、adjusted R2是等价的,其意义也相同。
对线性方程:
R2 = ∑(y预测-y)2/∑(y实际-y)2,y是平均数。
如果R2=0.775,则说明变量y的变异中有77.5%是由变量X引起的。
当R2=1时,表示所有的观测点全部落在回归直线上。
当R2=0时,表示自变量与因变量无线性关系。
- 独立性检验(属于卡方检验的一种)
它是根据频数判断两类因子彼此相关或相互独立的假设检验。
假设有两个分类变量X和Y,它们的值域分另为{x1, x2}和{y1, y2},其样本频数列联表为:
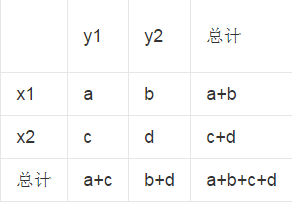
构造统计量:
 K2越小,原假设H0成立的可能性越大;它越大,目标结论H1成立的可能性越大.)
步骤:
Mlib的假设检验:
spark.mllib目前支持皮尔森卡方检测。- 输入属性的类型决定拟合优度(
goodness of fit)检测还是独立性检测。 拟合优度检测需要输入数据的类型是vector,独立性检测需要输入数据的类型是Matrix。 - import org.apache.spark.mllib.stat.Statistics._ ; Statistics 的 chiSqTest 方法用来做检测,当输入 vector和Matrix 时不同的检验。
import org.apache.spark.SparkContext

import org.apache.spark.mllib.linalg._

import org.apache.spark.mllib.regression.LabeledPoint

import org.apache.spark.mllib.stat.Statistics._

// 作皮尔森拟合优度检测

val vec: Vector =Vectors.dense(1.0, 2.0, 3.0)

val goodnessOfFitTestResult = Statistics.chiSqTest(vec)

println(goodnessOfFitTestResult)

// 作皮尔森独立性检测

val mat: Matrix =Matrices.dense(3,2,Array(9.0,1.0,2.0,3.0,8.0,6.0))

val independenceTestResult = Statistics.chiSqTest(mat)

println(independenceTestResult)
5. 随机数生成
spark.mllib 支持生成随机的RDD, RDD的独立同分布(iid)的值来自于给定的分布:均匀分布、标准正太分布、泊松分布。
例子:用标准正态分布生成一个随机的双精度RDD
import org.apache.spark.mllib.random.RandomRDDs._

val u = normalRDD(sc, 1000000L, 10)    // 生成了一个10个RDD分区的百万个随机数

val v = u.map(x => 1.0 + 2.0 * x)          //把标准正态分布产生的随机数map到N(1,4)的正态分布
6. 核密度估计
http://blog.163.com/zhuandi_h/blog/static/1802702882012111092743556/
核密度估计可以用来估计未知的密度函数,属于非参数检验方法。
假设我们有n个数 ,要计算某个数
X的概率密度有多大, 可以通过下面的核密度估计方法估计。

K为核密度函数,h为窗宽。
原理比较简单,在我们知道某一事物的概率分布的情况下
如果某一个数在观察中出现了,我们认为这个数的概率密度很大,和这个数近的数的概率密度也比较大;而那些离这个数远的数的概率密度会比较小。
- 基于这种想法,针对观察中的第一个数,我们可以用
K去拟合我们想象中的那个远小近大概率密度。
对每一个观察数拟合出的多个概率密度分布函数,取平均。 如果某些数是比较重要的,则可以取加权平均。
- 核密度的估计并不是找到真正的分布函数。
- 在
MLlib中,仅仅支持以 高斯核(正态分布) 做核密度估计:

- KernelDensity 的 estimate 方法
import org.apache.spark.mllib.stat.KernelDensity

import org.apache.spark.rdd.RDD

val data: RDD[Double] = ... // an RDD of sample data

val kd = new KernelDensity()

  .setSample(data)

  .setBandwidth(3.0)

val densities = kd.estimate(Array(-1.0, 2.0, 5.0))
Spark MLib 基本统计汇总 2的更多相关文章
- Spark MLib 基本统计汇总 1
1. 概括统计 summary statistics MLlib支持RDD[Vector]列式的概括统计,它通过调用 Statistics 的 colStats方法实现. colStats返回一个 ...
- Spark MLib完整基础入门教程
Spark MLib 在Spark下进行机器学习,必然无法离开其提供的MLlib框架,所以接下来我们将以本框架为基础进行实际的讲解.首先我们需要了解其中最基本的结构类型,即转换器.估计器.评估器和流水 ...
- Spark MLib:梯度下降算法实现
声明:本文参考< 大数据:Spark mlib(三) GradientDescent梯度下降算法之Spark实现> 1. 什么是梯度下降? 梯度下降法(英语:Gradient descen ...
- Spark mlib的本地向量
Spark mlib的本地向量有两种: DenseVctor :稠密向量 其创建方式 Vector.dense(数据) SparseVector :稀疏向量 其创建方式有两种: 方法一:Vector. ...
- 利用Oracle内置分析函数进行高效统计汇总
分析函数是Oracle从8.1.6开始引入的一个新的概念,为我们分析数据提供了一种简单高效的处理方式.在分析函数出现以前,我们必须使用自联查询,子查询或者内联视图,甚至复杂的存储过程实现的语句,现 ...
- spark 省份次数统计实例
//统计access.log文件里面IP地址对应的省份,并把结果存入到mysql package access1 import java.sql.DriverManager import org.ap ...
- sql简单实用的统计汇总案例参考
USE [PM]GO/****** 对象: StoredProcedure [dbo].[LfangSatstics] 脚本日期: 08/24/2013 10:57:48 ******/SET ...
- Spark笔记——技术点汇总
目录 概况 手工搭建集群 引言 安装Scala 配置文件 启动与测试 应用部署 部署架构 应用程序部署 核心原理 RDD概念 RDD核心组成 RDD依赖关系 DAG图 RDD故障恢复机制 Standa ...
- Spark Streaming 002 统计单词的例子
1.准备 事先在hdfs上创建两个目录: 保存上传数据的目录:hdfs://alamps:9000/library/SparkStreaming/data checkpoint的目录:hdfs://a ...
随机推荐
- HTML 学习笔记 JavaScript(事件)
事件流: 事件流: 描述的是从页面中接收事件的顺序 也可以理解为事件在页面中传播的顺序: 事件: 就是用户或浏览器自身执行的某种动作 例如 click(点击) load(加载) mouseover(鼠 ...
- NOIP2015 Revenge
辣鸡出题人,毁我比赛,颓我精神,耗我钱财,废我青春. 去年成绩惨不忍睹就不说了...好像是100+80+0+100+50+60. 大概列一下算法. 幻方:模拟 #include <iostrea ...
- 一种Docker image镜像的取代方案
在http://openvz.org/Download/templates/precreated中有很多压缩的镜像文件,可以将这些文件下载后采用import方式使用镜像,也可以采用我原来的博文:doc ...
- JavaScript中的this关键字
在JavaScript中,函数的this关键字的行为与其他语言相比有很多不同.在JavaScript的严格模式和非严格模式下也略有区别. 在绝大多数情况下,函数的调用方式决定了this的值.this不 ...
- ReactNative真机运行指南
ReactNative真机运行指南 注意在iOS设备上运行React Native应用需要一个Apple Developer account并且把你的设备注册为测试设备.本向导只包含React Nat ...
- ROS(Robot Operating System)常用环境变量介绍
本文简单介绍ROS系统中常用的环境变量用途及设置方式.ROS系统环境中除了必须配置的环境变量以外,其他的也是十分有用,通过修改变量路径,可以设置ROS系统中log文件存放路径,单元测试结果存放路径等. ...
- lecture12-玻尔兹曼机和受限玻尔兹曼机
这是Hinton的第12课,结合前一课可以知道RBM是来自BM,而BM是来自Hopfield的,因为水平有限,是直译的,虽然有时候会看不懂,但是好歹不会曲解原来的本意,看的话:1.先看ppt:2.通读 ...
- JS事件详解
hello,我是沐晴,最近呢,来总结一下 JS中的常用的事件,希望我们都能一起查漏补缺. 焦点事件 焦点事件在表单中经常用到,那什么是焦点呢?比如我们文本框里面的有光标的时候,就是获得了焦点,我们就可 ...
- learning to rank
Learning to Rank入门小结 + 漫谈 Learning to Rank入门小结 Table of Contents 1 前言 2 LTR流程 3 训练数据的获取4 特征抽取 3.1 人工 ...
- factor graph model
主实验 文慧:用户,商品,评分,review,ranking. 数据集:数据规模,论文源代码