
Spark MLib 基本统计汇总 1
1. 概括统计 summary statistics
MLlib支持RDD[Vector]列式的概括统计,它通过调用 Statistics 的 colStats方法实现。
colStats返回一个 MultivariateStatisticalSummary 对象,这个对象包含列式的最大值、最小值、均值、方差等等。
import org.apache.spark.mllib.linalg.Vector

import org.apache.spark.mllib.stat.{MultivariateStatisticalSummary, Statistics}

val observations: RDD[Vector] = ...       // define an RDD of Vectors


// Compute column summary statistics.

val summary: MultivariateStatisticalSummary = Statistics.colStats(observations)

println(summary.mean)                     // a dense vector containing the mean value for each column

println(summary.variance)                 // column-wise variance

println(summary.numNonzeros)              // number of nonzeros in each column
2. 相关性 correlations
1) 基础回顾
协方差:两个变量总体误差的期望。
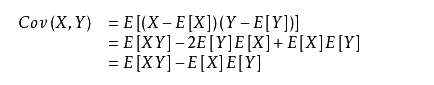
方差是一种特殊的协方差,即两个变量相等时。
所以方差 D(X)=E[X2]-(E(X))2
相关系数:用以反映变量之间相关关系密切程度的统计指标。

其中Cov(X,Y) 是X与Y的协方差,D(X),D(Y) 为其方差。
2)相关性系数的计算
计算两个数据集的相关性是统计中的常用操作,目前Mlib里面支持的有两种:皮尔森(Pearson)相关和斯皮尔曼(Spearman)相关。
Statistics 提供方法计算数据集的相关性。根据输入的类型,两个RDD[Double]或者一个RDD[Vector],输出将会是一个Double值或者相关性矩阵。
import org.apache.spark.SparkContext

import org.apache.spark.mllib.linalg._

import org.apache.spark.mllib.stat.Statistics

val sc: SparkContext = ...


val seriesX: RDD[Double] = ...                     // a series

val seriesY: RDD[Double] = ...                     // must have the same number of partitions and cardinality as seriesX

val correlation: Double = Statistics.corr(seriesX, seriesY, "pearson")


val data: RDD[Vector] = ...                        // note that each Vector is a row and not a column

val correlMatrix: Matrix = Statistics.corr(data, "pearson")
在上面输入 "pearson" 和"spearman" ,就会计算不同的系数。
3) Pearson 和Spearman相关系数
Pearson 就是我们平时学到的(是矩相关的一种)。
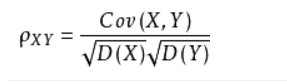
但有限制条件:
- 首先,必须假设数据是成对地从正态分布中取得的;
- 其次,数据至少在逻辑范围内是等距的。
Spearman相关系数,可以操作不服从正态分布的数据集。也就是秩相关(等级相关)的一种。
它是排序变量(ranked variables)之间的皮尔逊相关系数: 即对于大小为n的样本集,将原始的数据X_i和Y_i转换成排序变量rgX_i和rgY_i,再计算皮尔逊相关系数。
3. 分层取样
- 分层抽样法也叫类型抽样法。它是从一个可以分成不同子总体(或称为层)的总体中,按规定的比例从不同层中随机抽取样品(个体)的方法。
- 在
spark.mllib中,用key来分层。 - 分层采样方法
sampleByKey和sampleByKeyExact可以在key-value对的RDD上执行
sampleByKey :通过掷硬币的方式决定是否采样一个观察数据, 因此它需要我们传递(pass over)数据并且提供期望的数据大小(size)。
sampleByKeyExact :允许用户准确抽取f_k * n_k个样本, 这里f_k表示期望获取键为k的样本的比例,n_k表示键为k的键值对的数量。
比每层使用sampleByKey随机抽样需要更多的有意义的资源,但是它能使样本大小的准确性达到了99.99%。
import org.apache.spark.SparkContext

import org.apache.spark.SparkContext._

import org.apache.spark.rdd.PairRDDFunctions

val sc: SparkContext = ...

val data = ... // an RDD[(K, V)] of any key value pairs

val fractions: Map[K, Double] = ... // specify the exact fraction desired from each key

// Get an exact sample from each stratum

val approxSample = data.sampleByKey(withReplacement = false, fractions)

val exactSample = data.sampleByKeyExact(withReplacement = false, fractions)
基础回顾:
泊松分布 Poission分布
 期望和方差均为 λ.
伯努利分布即二项分布
 期望是np,方差是np(1-p)
当二项分布的n很大而p很小时,泊松分布可作为二项分布的近似,其中λ为np。通常当n≧10,p≦0.1时,就可以用泊松公式近似得计算。
重复抽样用泊松,不重复抽样用伯努利。
Spark MLib 基本统计汇总 1的更多相关文章
- Spark MLib 基本统计汇总 2
4. 假设检验 基础回顾: 假设检验,用于判断一个结果是否在统计上是显著的.这个结果是否有机会发生. 显著性检验 原假设与备择假设 常把一个要检验的假设记作 H0,称为原假设(或零假设) (null ...
- Spark MLib完整基础入门教程
Spark MLib 在Spark下进行机器学习,必然无法离开其提供的MLlib框架,所以接下来我们将以本框架为基础进行实际的讲解.首先我们需要了解其中最基本的结构类型,即转换器.估计器.评估器和流水 ...
- Spark MLib:梯度下降算法实现
声明:本文参考< 大数据:Spark mlib(三) GradientDescent梯度下降算法之Spark实现> 1. 什么是梯度下降? 梯度下降法(英语:Gradient descen ...
- Spark mlib的本地向量
Spark mlib的本地向量有两种: DenseVctor :稠密向量 其创建方式 Vector.dense(数据) SparseVector :稀疏向量 其创建方式有两种: 方法一:Vector. ...
- 利用Oracle内置分析函数进行高效统计汇总
分析函数是Oracle从8.1.6开始引入的一个新的概念,为我们分析数据提供了一种简单高效的处理方式.在分析函数出现以前,我们必须使用自联查询,子查询或者内联视图,甚至复杂的存储过程实现的语句,现 ...
- spark 省份次数统计实例
//统计access.log文件里面IP地址对应的省份,并把结果存入到mysql package access1 import java.sql.DriverManager import org.ap ...
- sql简单实用的统计汇总案例参考
USE [PM]GO/****** 对象: StoredProcedure [dbo].[LfangSatstics] 脚本日期: 08/24/2013 10:57:48 ******/SET ...
- Spark笔记——技术点汇总
目录 概况 手工搭建集群 引言 安装Scala 配置文件 启动与测试 应用部署 部署架构 应用程序部署 核心原理 RDD概念 RDD核心组成 RDD依赖关系 DAG图 RDD故障恢复机制 Standa ...
- Spark Streaming 002 统计单词的例子
1.准备 事先在hdfs上创建两个目录: 保存上传数据的目录:hdfs://alamps:9000/library/SparkStreaming/data checkpoint的目录:hdfs://a ...
随机推荐
- JSOI Round 2题解
强行一波题解骗一个访问量好了... http://blog.csdn.net/yanqval/article/details/51457302 http://absi2011.is-programme ...
- win7 远程桌面关机
在任务管理器中, 打开运行窗口, 执行 shutdown -s 命令, 将在30秒后关闭win7, 如果需要更快, 加上 -t 10 参数 关于 shutdown 的命令行说明: C:\Users\R ...
- [转]终于找到全annotation配置springMVC的方法了(事务不失效)
原文:http://icanfly.iteye.com/blog/778401 icanfly 写道 如果带上事务,那么用annotation方式的事务注解和bean配置,事务会失效,要将servic ...
- nginx架构
nginx平台初探(100%)
- [java]java语言初探 servlet+jsp架构
<<head first java>> https://www.tutorialspoint.com/jsp/jsp_architecture.htm JSP Processi ...
- 有的机器不能通过session登录
web.config <system.web> <sessionState mode="InProc" cookieless="AutoDetec ...
- Bootstrap系列 -- 4. 文本内容强调
一. 文本强调基本样式 .text-muted:提示,使用浅灰色(#999) .text-primary:主要,使用蓝色(#428bca) .text-success:成功,使用浅绿色(#3c763d ...
- vijos-1447 开关灯泡-大整数开方算法
描述 一个房间里有n盏灯泡,一开始都是熄着的,有1到n个时刻,每个时刻i,我们会将i的倍数的灯泡改变状态(即原本开着的现将它熄灭,原本熄灭的现将它点亮),问最后有多少盏灯泡是亮着的. 提示 范围:40 ...
- Unix 复制文件至指定目录
cp /gaps/log/20160504/bxdx_20160504.log.Z /home 将/gaps/log/20160504/bxdx_20160504.log.Z 文件复制到home路 ...
- 【JavaEE企业应用实战学习记录】getConnListener
Listener:当Web应用在Web容器中运行时,Web应用内部会不断地发生各种事件,如Web应用被启动.Web应用被停止,用户Session开始,用户session结束.用户请求到达等,这些对We ...