
AOV网络拓扑排序
这个算法,主要是为输出一个无环图的拓扑序列
算法思想:
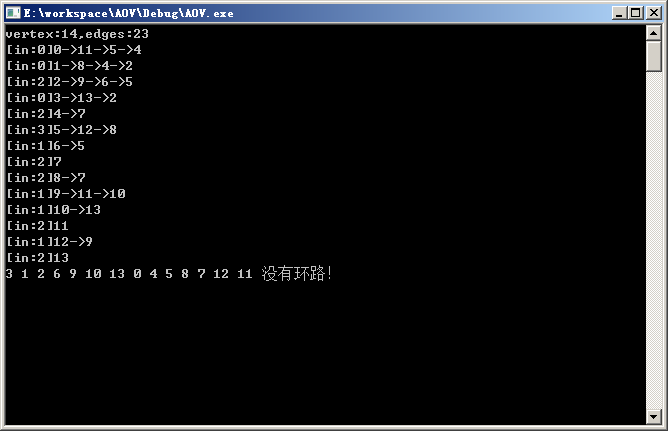
主要依赖一个栈,用来存放没有入度的节点,每次读取栈顶元素,并将栈顶元素的后继节点入度减一,如果再次出现入度为零的节点,就加入到栈中。参考《大话数据结构》,写下下面完整代码,并发现,其中程序的进行,出现错误。v6执行完,应该执行v9,因为此时v9是站顶元素,并不是v0.
算法流程:
int topGraph(graph g){

    EdgeNode *e;

    int i,k,gettop;

    int top =  ;

    int count = ;

    int *stack;

    stack = (int *)malloc(g->numVertexes * sizeof(int));

    for(i=;i<g->numVertexes;i++){

        if(g->headlist[i].in == ) //把入度为0的,即没有入度的点入栈

            stack[++top] = i;

    }

    while(top){

        gettop = stack[top--];

        printf("%d ",gettop);

        count++;

        for(e = g->headlist[gettop].fnode; e ; e=e->next){ //一次遍历链表,减少各个子节点的入度

            k = e->data;

            if(!(--g->headlist[k].in))

                stack[++top] = k;

        }

    }

    if(count < g->numVertexes)

        return ERROR;

    else

        return OK;

}
全部代码:
#include <stdio.h>

#include <stdlib.h>

#define MAX 14

#define ERROR 1

#define OK 0

typedef struct edgeNode{

    int data;

    struct edgeNode *next;

}EdgeNode;

typedef struct headNode{

    int in;

    int data;

    EdgeNode *fnode;

}HeadNode,HeadList[MAX];

typedef struct{

    HeadList headlist;

    int numEdges,numVertexes;

}Graph,*graph;

void initGraph(graph g);

int inputInfo(graph g,int tar,int in,int data,int first);

void printGraph(graph g);

int topGraph(graph g);

int main(){

    Graph *g = (Graph *)malloc(sizeof(Graph));

    initGraph(g);

    printGraph(g);

    if(topGraph(g) == ERROR)

        printf("有环路!\n");

    else

        printf("没有环路!\n");

    free(g);

    getchar();

    return ;

}

int topGraph(graph g){

    EdgeNode *e;

    int i,k,gettop;

    int top =  ;

    int count = ;

    int *stack;

    stack = (int *)malloc(g->numVertexes * sizeof(int));

    for(i=;i<g->numVertexes;i++){

        if(g->headlist[i].in == ) //把入度为0的,即没有入度的点入栈

            stack[++top] = i;

    }

    while(top){

        gettop = stack[top--];

        printf("%d ",gettop);

        count++;

        for(e = g->headlist[gettop].fnode; e ; e=e->next){ //一次遍历链表,减少各个子节点的入度

            k = e->data;

            if(!(--g->headlist[k].in))

                stack[++top] = k;

        }

    }

    if(count < g->numVertexes)

        return ERROR;

    else

        return OK;

}

void printGraph(graph g){

    int i;

    printf("vertex:%d,edges:%d\n",g->numVertexes,g->numEdges);

    EdgeNode *e = (EdgeNode *)malloc(sizeof(EdgeNode));

    for(i=;i<MAX;i++){

        printf("[in:%d]%d",g->headlist[i].in,g->headlist[i].data);

        e = g->headlist[i].fnode;

        while(e != NULL){

            printf("->%d",e->data);

            e = e->next;

        }

        printf("\n");

    }

    free(e);

}

void initGraph(graph g){

    g->numVertexes = MAX;

    g->numEdges = ;

    int i;

    for(i=;i<MAX;i++){

        g->headlist[i].fnode = NULL;

    }

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,-);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,);

    inputInfo(g,,,,-);

    inputInfo(g,,,,);

    inputInfo(g,,,,-);

}

int inputInfo(graph g,int tar,int in,int data,int first){

    g->numEdges++;

    if(first == -){ //没有后继的边节点

        g->headlist[tar].in = in;

        g->headlist[tar].data = data;

        return ;

    }

    if(!g->headlist[tar].fnode){ //观察是否已经初始化

        g->headlist[tar].in = in;

        g->headlist[tar].data = data;

    }

    EdgeNode *e = (EdgeNode *)malloc(sizeof(EdgeNode));

    e->data = first;

    e->next = g->headlist[tar].fnode;

    g->headlist[tar].fnode = e;

    return ;

}
执行示例:
AOV网络拓扑排序的更多相关文章
- AOV拓扑排序实验总结-1
AOV拓扑排序实验总结-1 实验数据:1.实验输入数据在input.txt文件中2.对于n是指有顶点n个,数据的结束标志是一行0 0. 实验目的:获取优秀的AOV排序算法模板 数据结构安排 ...
- AOV拓扑排序实验-2-AOV类的实现
下面是这个类的实现代码: //这只是一个基本的框架,没有封装 #include<iostream> #include<cstdio> #include<malloc.h& ...
- 设计AOV网拓扑排序的算法
拓扑排序 对一个有向图构造拓扑序列的过程称为拓扑排序(不唯一) 思想 从AOV网选择一个没有前驱的顶点并输出 从AOV网中删去该顶点,并且删去所有以该顶点为尾的弧 重复上述两步,直到全部顶点都被输出, ...
- [SOJ] Ordering Tasks
1940. Ordering Tasks Constraints Time Limit: 1 secs, Memory Limit: 32 MB Description John has n task ...
- Hadoop 基石HDFS 一文了解文件存储系统
@ 目录 前言:浅谈Hadoop Hadoop的发展历程 1.1 Hadoop产生背景 1.引入HDFS设计 1.1 HDFS主要特性 2.HDFS体系结构 HDFS工作流程机制 1.各个节点是如何互 ...
- 算法与数据结构(七) AOV网的拓扑排序
今天博客的内容依然与图有关,今天博客的主题是关于拓扑排序的.拓扑排序是基于AOV网的,关于AOV网的概念,我想引用下方这句话来介绍: AOV网:在现代化管理中,人们常用有向图来描述和分析一项工程的计划 ...
- 有向无环图的应用—AOV网 和 拓扑排序
有向无环图:无环的有向图,简称 DAG (Directed Acycline Graph) 图. 一个有向图的生成树是一个有向树,一个非连通有向图的若干强连通分量生成若干有向树,这些有向数形成生成森林 ...
- AOV网络和Kahn算法拓扑排序
1.AOV与DAG 活动网络可以用来描述生产计划.施工过程.生产流程.程序流程等工程中各子工程的安排问题. 一般一个工程可以分成若干个子工程,这些子工程称为活动(Activity).完成了这些活动 ...
- 算法与数据结构(七) AOV网的拓扑排序(Swift版)
今天博客的内容依然与图有关,今天博客的主题是关于拓扑排序的.拓扑排序是基于AOV网的,关于AOV网的概念,我想引用下方这句话来介绍: AOV网:在现代化管理中,人们常用有向图来描述和分析一项工程的计划 ...
随机推荐
- 使用Java VisualVM监控远程JVM
我们经常需要对我们的开发的软件做各种测试, 软件对系统资源的使用情况更是不可少, 目前有多个监控工具, 相比JProfiler对系统资源尤其是内存的消耗是非常庞大,JDK1.6开始自带的VisualV ...
- hdu 4666 Hyperspace(多维度最远曼哈顿距离)
献上博文一篇http://hi.baidu.com/byplane747/item/53ca46c159e654bc0d0a7b8d 设维度为k,维护(1<<k)个优先队列,用来保存0~( ...
- UVALive 4287 Proving Equivalences(缩点)
等价性问题,给出的样例为 a->b的形式,问要实现全部等价(即任意两个可以互相推出),至少要加多少个形如 a->b的条件. 容易想到用强连通缩点,把已经实现等价的子图缩掉,最后剩余DAG. ...
- HDU 4632 Palindrome subsequence (区间DP)
题意 给定一个字符串,问有多少个回文子串(两个子串可以一样). 思路 注意到任意一个回文子序列收尾两个字符一定是相同的,于是可以区间dp,用dp[i][j]表示原字符串中[i,j]位置中出现的回文子序 ...
- POI读取Word与Excel
import java.io.BufferedWriter; import java.io.FileInputStream; import java.io.FileNotFoundException; ...
- (4) Spring中定时任务Quartz集群配置学习
原 来配置的Quartz是通过spring配置文件生效的,发现在非集群式的服务器上运行良好,但是将工程部署到水平集群服务器上去后改定时功能不能正常运 行,没有任何错误日志,于是从jar包.JDK版本. ...
- http请求返回响应码的意思
HTTP 状态响应码 意思详解/大全 HTTP状态码(HTTP Status Code)是用以表示网页服务器HTTP响应状态的3位数字代码.它由 RFC 2616 规范定义的,并得到RFC 2518. ...
- 【JS】js获得下拉列表选中项的值和id
function tijiao(){ var elem = document.getElementById("dish_sort"); var index=elem.selecte ...
- IIS应用程序池回收图文详解
转:http://blog.sina.com.cn/s/blog_8677fcaa010138uf.html 什么是应用程序池呢?这是微软的一个全新概念:应用程序池是将一个或多个应用程序链接到一个或多 ...
- MyBatis 物理分页
MyBatis使用RowBounds实现的分页是逻辑分页,也就是先把数据记录全部查询出来,然在再根据offset和limit截断记录返回 为了在数据库层面上实现物理分页,又不改变原来MyBatis的函 ...