
安装配置hadoop
在master中安装并且配置hadoop
(1).将hadoop-2.6.4.tar.gz安装包复制到hadoop文件目录下(直接赋值进去就行)
(2).解压安装包haoddp-2.6.4.tar.gz
cd
cd hadoop
tar -zxvf hadoop-2.6.4.tar.gz
(3).修改配置hadoop的hadoop-env.sh文件
cd
cd hadoop/hadoop-2.6.4
cd etc/hadoop
gedit hadoop-env.sh
在最后一行添加: export JAVA_HOME=/home/tianjiale/hadoop/jdk1.7.0_79
(4).修改配置hadoop的core-site.xml
gedit core-site.xml
把下面代码,放入 <configuration>_____ </configuration>中 注意:value里面的路径问题
<property>
<name>fs.default.name</name>
<value>hdfs://master:9000</value>
<final>true</final>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/home/tianjiale/hadoop/tmp</value>
</property>
<property>
<name>ds.default.name</name>
<value>hdfs://master:54310</value>
<final>true</final>
</property>
(5).修改配置hdfs-site.xml文件
gedit hdfs-site.xml
把下面代码,放入 <configuration>_____ </configuration>中 注意:value里面的路径问题
<property>
<name>dfs.namenode.name.dir</name>
<value>file:/home/tianjiale/hadoop/dfs/name</value>
<final>true</final>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>file:/home/tianjiale/hadoop/dfs/data</value>
<final>true</final>
</property>
<property>
<name>dfs.replication</name>
<value>2</value>
</property>
(6).修改配置文件 mapred-site.xml
gedit mapred-site.xml
(注意:必须先复制mapred-site.xml.template文件更名为mapred-site.xml)
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
<property>
<name>mapreduce.jobhistory.address</name>
<value>master:10020</value>
</property>
<property>
<name>mapreduce.jobhistory.webapp.address</name>
<value>master:19888</value>
</property>
(7).修改配置文件yarn-site.xml
gedit yarn-site.xml
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>
<value>org.apache.hadoop.mapred.ShuffleHandler</value>
</property>
<property>
<name>yarn.resourcemanager.hostname</name>
<value>master</value>
</property>
<property>
<name>yarn.resourcemanager.address</name>
<value>master:8032</value>
</property>
<property>
<name>yarn.resourcemanager.scheduler.address</name>
<value>master:8030</value>
</property>
<property>
<name>yarn.resourcemanager.resource-tracker.address</name>
<value>master:8031</value>
</property>
<property>
<name>yarn.resourcemanager.admin.address</name>
<value>master:8033</value>
</property>
<property>
<name>yarn.resourcemanager.webapp.address</name>
<value>master:8088</value>
</property>
(8).修改配置文件master
gedit master
添加 master
(9).修改配置文件slaves
gedit slaves
添加master
(10).启动集群
cd
cd hadoop/hadoop-2.6.4
bin/hdfs namenode -format //格式化namenode
sbin/start-dfs.sh
sbin/start-yarn.sh
sbin/hadoop-daemon.sh start secondarynamenode
sbin/start-all.sh //开启全部 即上面三条
//sbin/stop-all.sh //关闭全部
(11).检查集群情况
jps
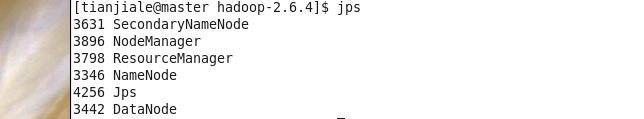
开启成功。
安装配置hadoop的更多相关文章
- 集群安装配置Hadoop具体图解
集群安装配置Hadoop 集群节点:node4.node5.node6.node7.node8. 详细架构: node4 Namenode,secondnamenode,jobtracker node ...
- 虚拟机Ubuntu(18.04.2)下安装配置Hadoop(2.9.2)(伪分布式+Java8)
[本文结构] [1]安装Hadoop前的准备工作 [1.1] 创建新用户 [1.2] 更新APT [1.3] 安装SSH [1.4] 安装Java环境 [2]安装和配置hadoop [2.1] Had ...
- hadoop集群环境搭建之安装配置hadoop集群
在安装hadoop集群之前,需要先进行zookeeper的安装,请参照hadoop集群环境搭建之zookeeper集群的安装部署 1 将hadoop安装包解压到 /itcast/ (如果没有这个目录 ...
- Centos 7环境下安装配置Hadoop 3.0 Beta1简记
前言 由于以前已经写过一篇Centos 7环境下安装配置2.8的随笔,因此这篇写得精简些,只挑选一些重要环节记录一下. 安装环境为:两台主机均为Centos 7.*操作系统,两台机器配置分别为: 主机 ...
- 在Ubuntu 13.10 中安装配置 Hadoop 2.2.0
预备条件: 1. 已安装JDK Add Hadoop Group and User $ sudo addgroup hadoop$ sudo adduser --ingroup hadoop hdus ...
- Linux中安装配置hadoop集群
一. 简介 参考了网上许多教程,最终把hadoop在ubuntu14.04中安装配置成功.下面就把详细的安装步骤叙述一下.我所使用的环境:两台ubuntu 14.04 64位的台式机,hadoop选择 ...
- CentOS安装配置Hadoop 1.2.1(伪分布模式)
CentOS安装配置Hadoop1.2.1 1.下载安装文件 下载2个安装文件 JAVA环境:jdk-6u21-linux-i586.bin Hadoop环境:hadoop-1.2.1.tar.gz ...
- Hadoop学习笔记: 安装配置Hadoop
安装前的一些环境配置: 1. 给用户添加sudo权限,输入su - 进入root账号,然后输入visudo,进入编辑模式,找到这一行:"root ALL=(ALL) ALL"在下面 ...
- 大二暑假第一周总结--初次安装配置Hadoop
本次配置主要使用的教程:http://dblab.xmu.edu.cn/blog/install-hadoop-in-centos/ 以下是自己在配置中的遇到的一些问题和解决方法,或者提示 一.使用虚 ...
随机推荐
- Android学习笔记_5_文件操作
1.Activity提供了openFileOutput()方法可以用于把数据输出到文件中,具体的实现过程与在J2SE环境中保存数据到文件中是一样的. package com.example.servi ...
- 复合词(Compound Words, UVa 10391)(stl set)
You are to find all the two-word compound words in a dictionary. A two-word compound word is a word i ...
- mysql自连接
自连接: -- 求7369员工编号,姓名,经理编号和经理姓名 select e1.empno,e1.ename,e2.empno,e2.ename from emp e1,emp e2 where e ...
- Java 加密PDF设置密码并添加水印
/** * Project Name:XXX * File Name:EncryptLogFile.java * Date:2016-6-12上午11:56:38 * Copyright (c) 20 ...
- 轻量ORM-SqlRepoEx 重大升级
.Net平台下兼容.NET Standard 2.0,一个实现以Lambda表达式转转换标准SQL语句,支持MySQL.SQL Server数据库方言,使用强类型操作数据的轻量级ORM工具,在减少魔法 ...
- Java程序如何生成Jar 执行文件(2)
一.用Eclipse生产Jar文件 注意:此方法可以打包含有第三方jar包的项目 1. 首先,右键你的Java工程,选择Export,在Java文件夹下选择Runnable JAR file,如下图所 ...
- web 打印功能
在项目开发中有时候会碰到要求打印页面中的数据的功能需求.需求原因主要有两点吧,一是需要打印的数据只是页面的一部分即页面的区域打印,比如只需要打印页面中表格里面选中的数据等,二是需要打印出来的样式和页面 ...
- #leetcode刷题之路3-无重复字符的最长子串
给定一个字符串,请你找出其中不含有重复字符的 最长子串 的长度. 示例 1:输入: "abcabcbb"输出: 3 解释: 因为无重复字符的最长子串是 "abc" ...
- 使用Python对MySQL数据库操作
本文介绍Python3使用PyMySQL连接数据库,并实现简单的增删改查. 什么是PyMySQL? PyMySQL是Python3.x版本中用于连接MySQL服务器的一个库,Python2.x中则使用 ...
- 利用百度地图API实现地址和经纬度互换查询
import json import requests def baiduMap(input_para): headers = { 'User-Agent': 'Mozilla/5.0 (Window ...