
tensorflow建造神经网络-【老鱼学tensorflow】
上次我们添加了一个add_layer函数,这次就要创建一个神经网络来预测/拟合相应的数据。
下面我们先来创建一下虚拟的数据,这个数据为二次曲线数据,但同时增加了一些噪点,其图像为:
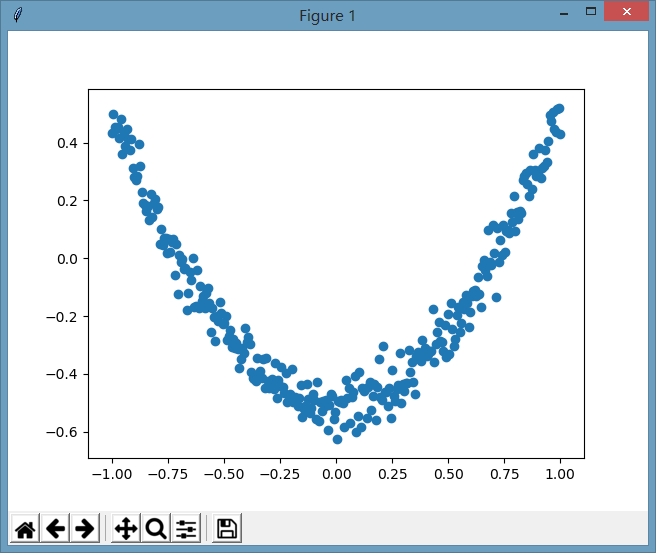
相应的创建这些伪造数据的代码为:
import numpy as np

# 创建一列(相当于只有一个属性值),300行的x值,这里np.newaxis用于新建出列数据,使其shape为(300, 1)

x_data = np.linspace(-1, 1, 300)[:,np.newaxis]

# 增加噪点,噪点的均值为0,标准差为0.05,形状跟x_data一样

noise = np.random.normal(0, 0.05, x_data.shape)

# 定义y的函数为二次曲线的函数,但同时增加了一些噪点数据

y_data = np.square(x_data) - 0.5 + noise
有了虚拟的数据之后,我们假装不知道这个数据的规律,因此我们想要通过一个神经网络来根据这些数据来发现这些数据所蕴含的规律。
这个神经网络定义了一个隐藏层和一个输出层:
# 定义输入值,这里定义输入值的目的是为了能够使程序比较灵活,可以在神经网络启动时接收不同的实际输入值,这里输入的结构为输入的行数不国定,但列就是1列的值

xs = tf.placeholder(tf.float32, [None, 1])

ys = tf.placeholder(tf.float32, [None, 1])

# 定义一个隐藏层,输入为xs,输入size为1列,因为x_data就只有1个属性值,输出size我们假定输出的神经元有10个神经元的隐藏层,激励函数用relu

l1 = add_layer(xs, 1, 10, tf.nn.relu)

# 定义输出层,输入为l1,输入size为10列,也就是l1的列数,输出size为1,因为这里直接输出为类似y_data了,因此为1列,假定没有激励函数,也就是输出是啥就直接传递出去了。

predition = add_layer(l1, 10, 1, activation_function=None)
然后定义损失函数为差值平方和的平均值
# 定义损失函数为差值平方和的平均值

loss = tf.reduce_mean(tf.reduce_sum(tf.square(ys - predition), axis=1))

# 进行逐步优化的梯度下降优化器,学习效率为0.1,以最小化损失函数的方式进行优化

train_step = tf.train.GradientDescentOptimizer(0.1).minimize(loss)
最后进行初始化和进行训练:
# 初始化所有定义的变量

init = tf.global_variables_initializer()

sess = tf.Session()

sess.run(init)

# 学习1000次

for i in range(1000):

    sess.run(train_step, feed_dict={xs:x_data, ys:y_data})

    # 打印期间的误差值,看这个误差值是否在减少

    if i % 50 == 0:

        print(sess.run(loss, feed_dict={xs:x_data, ys:y_data}))
完整的代码为:
import tensorflow as tf

def add_layer(inputs, in_size, out_size, activation_function=None):

    """

    添加层

    :param inputs: 输入数据

    :param in_size: 输入数据的列数

    :param out_size: 输出数据的列数

    :param activation_function: 激励函数

    :return:

    """

    # 定义权重,初始时使用随机变量,可以简单理解为在进行梯度下降时的随机初始点,这个随机初始点要比0值好,因为如果是0值的话,反复计算就一直是固定在0中,导致可能下降不到其它位置去。

    Weights = tf.Variable(tf.random_normal([in_size, out_size]))

    # 偏置shape为1行out_size列

    biases = tf.Variable(tf.zeros([1, out_size]) + 0.1)

    # 建立神经网络线性公式:inputs * Weights + biases,我们大脑中的神经元的传递基本上也是类似这样的线性公式,这里的权重就是每个神经元传递某信号的强弱系数,偏置值是指这个神经元的原先所拥有的电位高低值

    Wx_plus_b = tf.matmul(inputs, Weights) + biases

    if activation_function is None:

        # 如果没有设置激活函数,则直接就把当前信号原封不动地传递出去

        outputs = Wx_plus_b

    else:

        # 如果设置了激活函数,则会由此激活函数来对信号进行传递或抑制

        outputs = activation_function(Wx_plus_b)

    return outputs

import numpy as np

# 创建一列(相当于只有一个属性值),300行的x值,这里np.newaxis用于新建出列数据,使其shape为(300, 1)

x_data = np.linspace(-1, 1, 300)[:,np.newaxis]

# 增加噪点,噪点的均值为0,标准差为0.05,形状跟x_data一样

noise = np.random.normal(0, 0.05, x_data.shape)

# 定义y的函数为二次曲线的函数,但同时增加了一些噪点数据

y_data = np.square(x_data) - 0.5 + noise

# 定义输入值,这里定义输入值的目的是为了能够使程序比较灵活,可以在神经网络启动时接收不同的实际输入值,这里输入的结构为输入的行数不国定,但列就是1列的值

xs = tf.placeholder(tf.float32, [None, 1])

ys = tf.placeholder(tf.float32, [None, 1])

# 定义一个隐藏层,输入为xs,输入size为1列,因为x_data就只有1个属性值,输出size我们假定输出的神经元有10个神经元的隐藏层,激励函数用relu

l1 = add_layer(xs, 1, 10, tf.nn.relu)

# 定义输出层,输入为l1,输入size为10列,也就是l1的列数,输出size为1,因为这里直接输出为类似y_data了,因此为1列,假定没有激励函数,也就是输出是啥就直接传递出去了。

predition = add_layer(l1, 10, 1, activation_function=None)

# 定义损失函数为差值平方和的平均值

loss = tf.reduce_mean(tf.reduce_sum(tf.square(ys - predition), axis=1))

# 进行逐步优化的梯度下降优化器,学习效率为0.1,以最小化损失函数的方式进行优化

train_step = tf.train.GradientDescentOptimizer(0.1).minimize(loss)

# 初始化所有定义的变量

init = tf.global_variables_initializer()

sess = tf.Session()

sess.run(init)

# 学习1000次

for i in range(1000):

    sess.run(train_step, feed_dict={xs:x_data, ys:y_data})

    # 打印期间的误差值,看这个误差值是否在减少

    if i % 50 == 0:

        print(sess.run(loss, feed_dict={xs:x_data, ys:y_data}))
执行后输出为:
0.558202

0.0136704

0.0095978

0.00769082

0.00639173

0.00552368

0.00489246

0.00448871

0.00421288

0.00402797

0.00389303

0.00378238

0.00370672

0.0036429

0.0035787

0.00350686

0.00344219

0.00338799

0.00332198

0.00326401
tensorflow建造神经网络-【老鱼学tensorflow】的更多相关文章
- tensorflow分类-【老鱼学tensorflow】
前面我们学习过回归问题,比如对于房价的预测,因为其预测值是个连续的值,因此属于回归问题. 但还有一类问题属于分类的问题,比如我们根据一张图片来辨别它是一只猫还是一只狗.某篇文章的内容是属于体育新闻还是 ...
- tensorflow例子-【老鱼学tensorflow】
本节主要用一个例子来讲述一下基本的tensorflow用法. 在这个例子中,我们首先伪造一些线性数据点,其实这些数据中本身就隐藏了一些规律,但我们假装不知道是什么规律,然后想通过神经网络来揭示这个规律 ...
- tensorflow安装-【老鱼学tensorflow】
TensorFlow是谷歌基于DistBelief进行研发的第二代人工智能学习系统,其命名来源于本身的运行原理.Tensor(张量)意味着N维数组,Flow(流)意味着基于数据流图的计算,Tensor ...
- tensorflow变量-【老鱼学tensorflow】
在程序中定义变量很简单,只要定义一个变量名就可以,但是tensorflow有点类似在另外一个世界,因此需要通过当前的世界中跟tensorlfow的世界中进行通讯,来告诉tensorflow的世界中定义 ...
- tensorflow激励函数-【老鱼学tensorflow】
当我们回到家,如果家里有异样,我们能够很快就会发现家中的异样,那是因为这些异常的摆设在我们的大脑中会产生较强的脑电波. 当我们听到某个单词,我们大脑中跟这个单词相关的神经元会异常兴奋,而同这个单词无关 ...
- tensorflow卷积神经网络-【老鱼学tensorflow】
前面我们曾有篇文章中提到过关于用tensorflow训练手写2828像素点的数字的识别,在那篇文章中我们把手写数字图像直接碾压成了一个784列的数据进行识别,但实际上,这个图像是2828长宽结构的,我 ...
- tensorflow Tensorboard可视化-【老鱼学tensorflow】
tensorflow自带了可视化的工具:Tensorboard.有了这个可视化工具,可以让我们在调整各项参数时有了可视化的依据. 本次我们先用Tensorboard来可视化Tensorflow的结构. ...
- tensorflow RNN循环神经网络 (分类例子)-【老鱼学tensorflow】
之前我们学习过用CNN(卷积神经网络)来识别手写字,在CNN中是把图片看成了二维矩阵,然后在二维矩阵中堆叠高度值来进行识别. 而在RNN中增添了时间的维度,因为我们会发现有些图片或者语言或语音等会在时 ...
- tensorflow用dropout解决over fitting-【老鱼学tensorflow】
在机器学习中可能会存在过拟合的问题,表现为在训练集上表现很好,但在测试集中表现不如训练集中的那么好. 图中黑色曲线是正常模型,绿色曲线就是overfitting模型.尽管绿色曲线很精确的区分了所有的训 ...
随机推荐
- Dijkstra算法——计算一个点到其他所有点的最短路径的算法
迪杰斯特拉算法百度百科定义:传送门 gh大佬博客:传送门 迪杰斯特拉算法用来计算一个点到其他所有点的最短路径,是一种时间复杂度相对比较优秀的算法 O(n2)(相对于Floyd算法来说) 是一种单源最短 ...
- MT【320】依次动起来
已知$ BC=6,AC=2AB, $点$ D $满足$ \overrightarrow{AD}=\dfrac{2x}{x+y}\overrightarrow{AB}+\dfrac{y}{2(x+y)} ...
- 团体程序设计天梯赛(CCCC) L3021 神坛 的一些错误做法(目前网上的方法没一个是对的) 和 一些想法
团体程序设计天梯赛代码.体现代码技巧,比赛技巧. https://github.com/congmingyige/cccc_code
- Day049--jQuery的文档操作和事件介绍
今日内容 DOM操作(CRUD) js中DOM document.createElement('p') appendChild() insertBefore() removeChild() 创建元素 ...
- 继续沿用旧的网络访问模式Apache HTTP 客户端,防止Android9闪退
注意位置,在application 节点里面.
- 针对监控摄像机(海康、大华等)录像 .h264 文件的流媒体播放设计
监控摄像机(海康.大华等)内部带的录像功能一般录制的是h264文件,这种文件格式简单的把每一帧h264字节数据保存到文件里. 实际使用中,可能需要对特定录像进行反复检测,以训练.改进视频检测算法的准确 ...
- Eclipse之JSP页面的使用
Eclipse之JSP页面的使用 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.使用Eclipse创建JSP文件 1>.点击new file,选择jsp File 2&g ...
- C#中的Finalize,Dispose,SuppressFinalize的实现和使用介绍
原文地址:http://www.csharpwin.com/csharpspace/8927r1397.shtml MSDN建议按照下面的模式实现IDisposable接口: public class ...
- 第二节:重写(new)、覆写(overwrite)、和重载(overload)
一. 重写 1. 关键字:new 2. 含义:子类继承父类中的普通方法,如果在子类中重写了一个和父类中完全相同的方法,子类中会报警告(问是否显式的隐藏父类的中的方法),如果在子类中的方法前加上new关 ...
- Geometric regularity criterion for NSE: the cross product of velocity and vorticity 2: $u\times \om\cdot \n\times \om$
在 [Lee, Jihoon. Notes on the geometric regularity criterion of 3D Navier-Stokes system. J. Math. Phy ...