
keras神经网络做简单的回归问题
咸鱼了半个多月了,要干点正经事了。
最近在帮老师用神经网络做多变量非线性的回归问题,没有什么心得,但是也要写个博文当个日记。
该回归问题是四个输入,一个输出。自己并不清楚这几个变量有什么关系,因为是跟遥感相关的,就瞎做呗。
- 数据预处理的选择
刚开始选取了最大最小值的预处理方法,调了很久的模型但是最后模型的输出基本不变。
换了z-score的预处理方法,模型的输出才趋于正常。
- 损失函数的选择
对于回归问题,常用的损失函数有三种,一个是平方误差函数,一个是绝对值误差函数,还有一个是交叉熵函数。
在其他参数都不变的时候分别采用这三个损失函数:
1.交叉熵
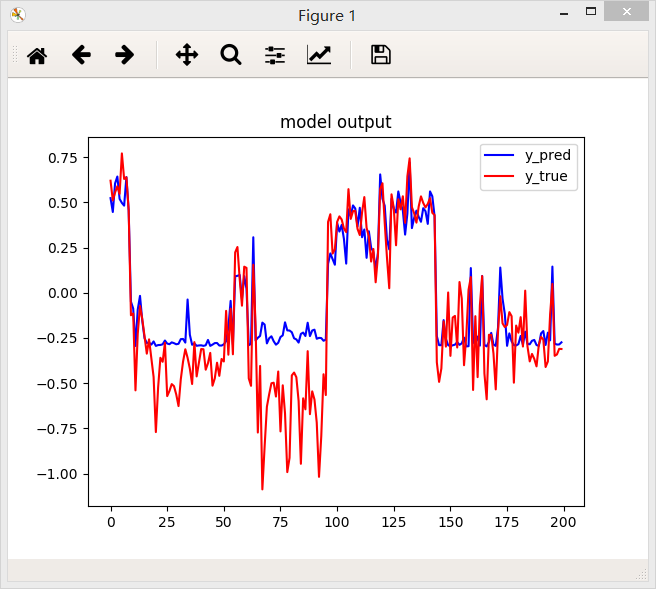
2.绝对值误差函数
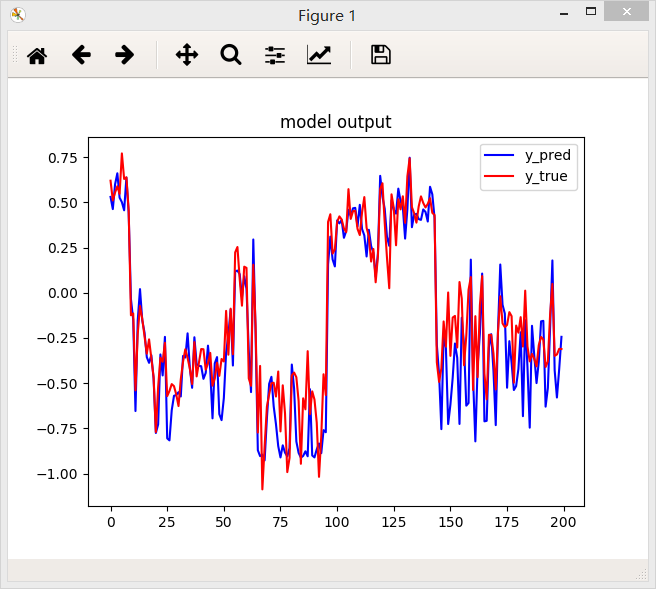
3.平方误差函数

结论:从上面三个图中国可以看出,相同条件下,绝对值误差函数得到的效果好一些。
- batch_size大小的选择
bach_size = 32
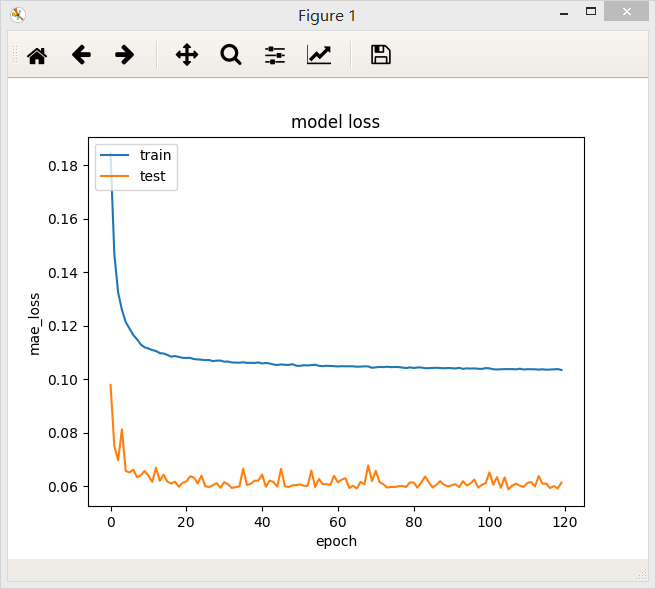
bach_size = 64
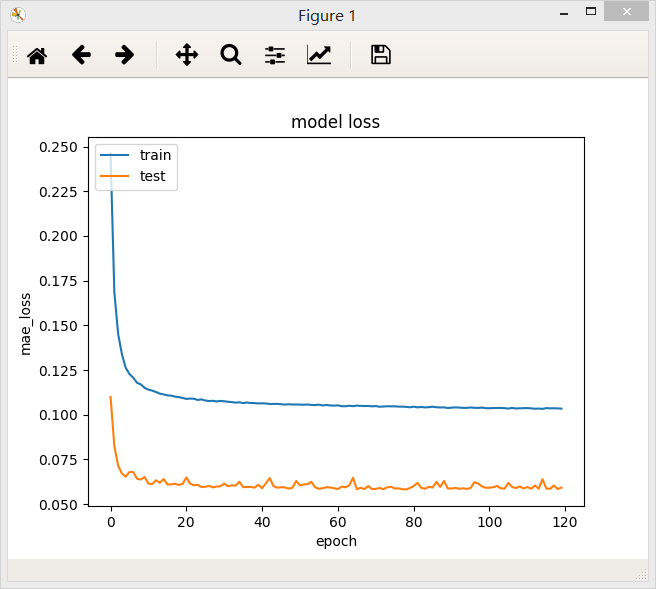
bach_size = 128
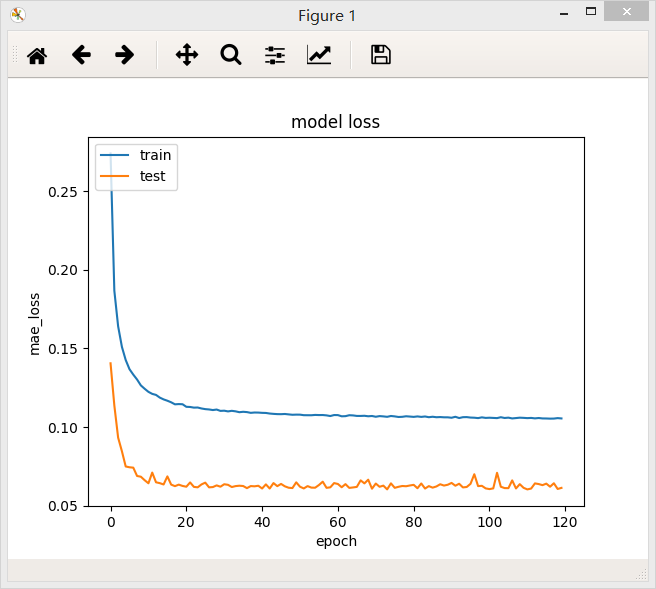
batch_size = 256
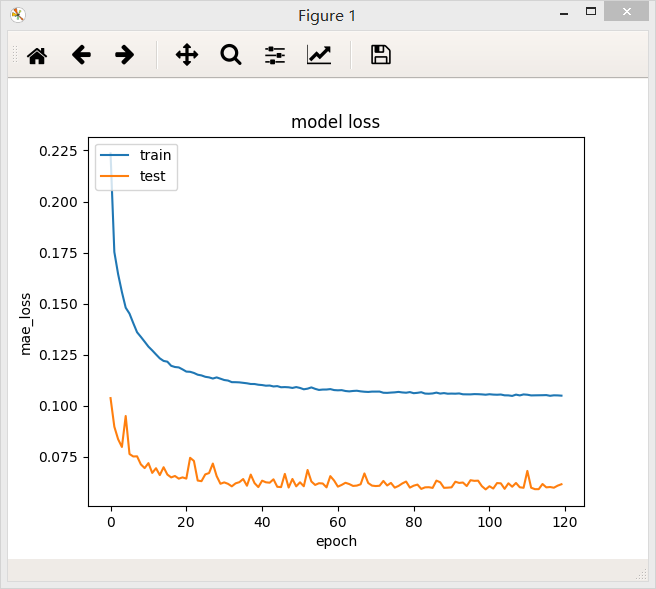
在两个不同的batch_size下,网络最后的loss值都差不多,但是在验证集上,当batch_size = 64/128时,loss曲线比较稳定。
结论:一定范围内,batch_size越大,其确定的下降方向就越准,引起训练震荡越小.随着batch_size增大,处理相同的数据量的速度越快。但是随着batchsize增大,达到相同精度所需要的epoch数量越来越多。过大的batch_size的结果是网络很容易收敛到一些不好的局部最优点。同样太小的batch_size会使得训练速度很慢,训练不容易收敛。
- 是否添Dropout层
不加dropout层
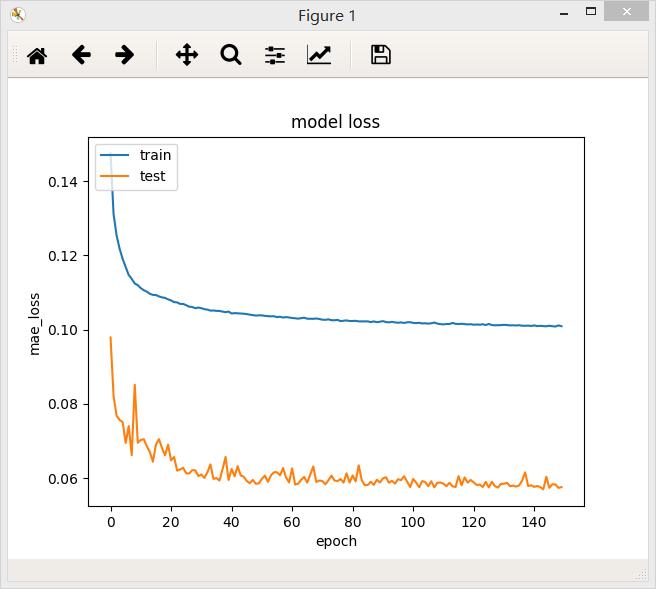
加了Dropout层

加了Dropout层后模型的loss值反而升高,但是测试集上的loss下降能平稳一些。
- 深层网络和浅层网络的选择
我自己觉得这样一个简单的问题其实浅层网络就能解决,但是老师想搭一下深度学习的车,没办法只能用比较一下两个模型。
含有一个隐层的全连接网络,64个神经元,最后模型的loss值为:0.1032
含有两个隐层的全连接网络,第一层32个神经元,第二层16个神经元,最后的loss值为0.0995
含有三个隐层的全连接网络,第一层32个神经元,第二层16个神经元,第三层8个神经元,最后模型的loss值为0.0986
含有四个隐层的全连接网络,第一层32个神经元,第二层16个神经元,第三层8个神经元,第四层4个神经元,最后模型的loss值为0.0993
含有五个隐层的全连接网络,第一层32个神经元,第二层16个神经元,第三层8个神经元,第四层4个神经元,第五层2个神经元,最后模型的loss值为0.0991
含有五个隐层的全连接网络,第一层32个神经元,第二层16个神经元,第三层8个神经元,第四层4个神经元,第五层2个神经元,第六层2个神经元,最后模型的loss值为0.0988
........
结论:在一定范围内,随着网络层的加深,模型的准确率升高。超过一定范围,随着网络层的加深,模型的准确率不但不升反而下降,测试集上的准确率也会下降,所以这并不是出现了过拟合。
- 模型宽度的选择
由于上一个实验中三层模型的loss值最低,所以我选择三层模型来做这个对于模型宽度选择的实验。
1、含有三个隐层的全连接网络,第一层32个神经元,第二层16个神经元,第三层8个神经元,最后模型的loss值为0.0986
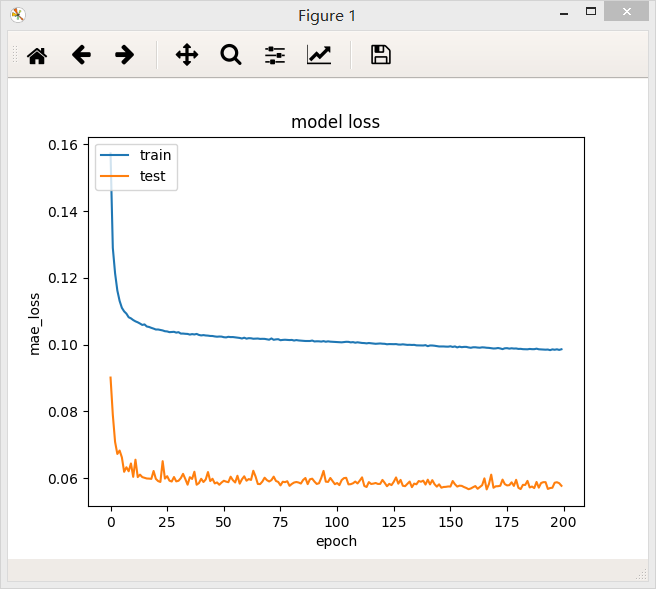
2、含有三个隐层的全连接网络,第一层32个神经元,第二层32个神经元,第三层16个神经元,最后模型的loss值为0.0986
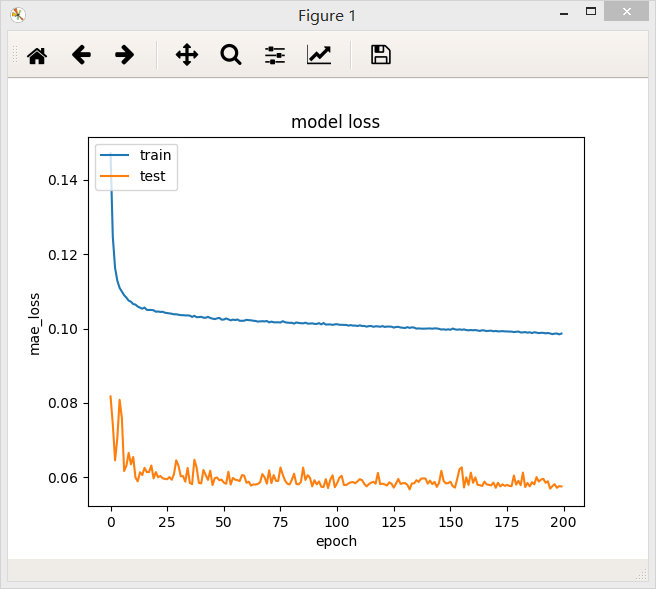
3、含有三个隐层的全连接网络,第一层32个神经元,第二层32个神经元,第三层32个神经元,最后模型的loss值为0.0960
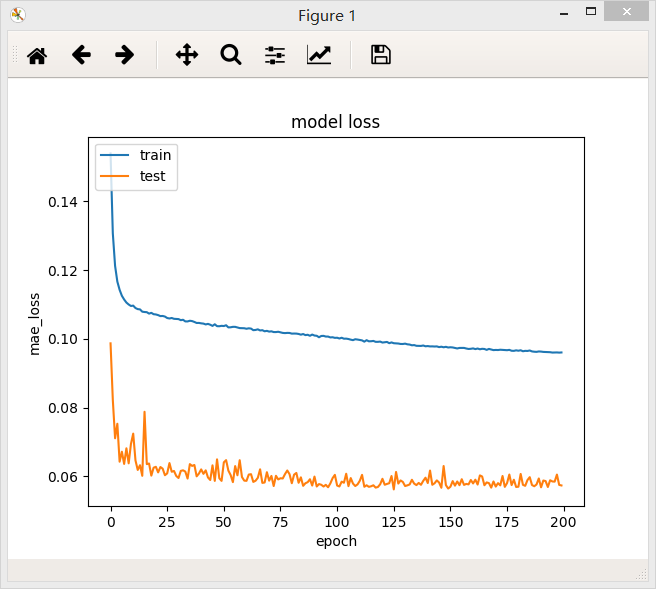
4、含有三个隐层的全连接网络,第一层32个神经元,第二层64个神经元,第三层32个神经元,最后模型的loss值为0.0967
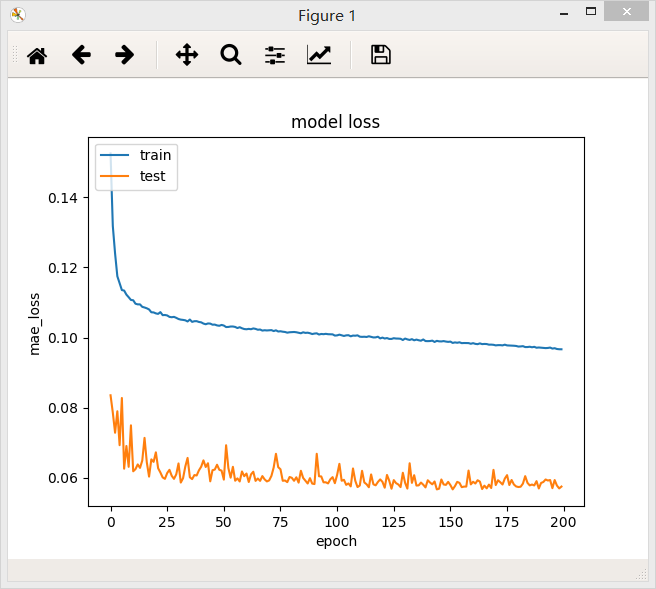
5、含有三个隐层的全连接网络,第一层32个神经元,第二层64个神经元,第三层64个神经元,最后模型的loss值为0.0967

结论:在一定范围内,网络模型越宽,模型的准确率越高,但是超过某一阈值后,模型的准确率不再提高,测试集上loss下降震荡越来越明显,说明模型的复杂度已经高于回归问题真是模型的复杂度。
- 尝试残差网络
第一种残差网络:
def identity_block(x):

        out = Dense(32)(x)

        #out = BatchNormalization()(out)

        out = Activation('tanh')(out)

        #out = Dropout(0.1)(out)

        out = Dense(32)(x)

        #out = Dropout(0.1)(out)

        #out = BatchNormalization()(out)

        out = Activation('tanh')(out)

        out = Dense(4)(out)

        #out = BatchNormalization()(out)

        out = merge([out,x],mode='sum')

        out = Activation('tanh')(out)

        return out

结论:和全连接网络相比,残差网络loss下降很快,测试集上loss下降曲线很平滑,但是模型的准确率却不如普通三层的全连接网络,最终的loss值为0.1021。
第二种残差网络:
def fc_block(x):

        out = Dense(32)(x)

        out = Activation('tanh')(out)

        out = Dense(32)(x)

        out = Dropout(0.1)(out)

        out = Activation('tanh')(out)

        out = Dense(32)(out)

        x = Dense(32)(x)

        out = merge([out, x], mode = 'sum')

        out = Activation('tanh')(out)

        return out
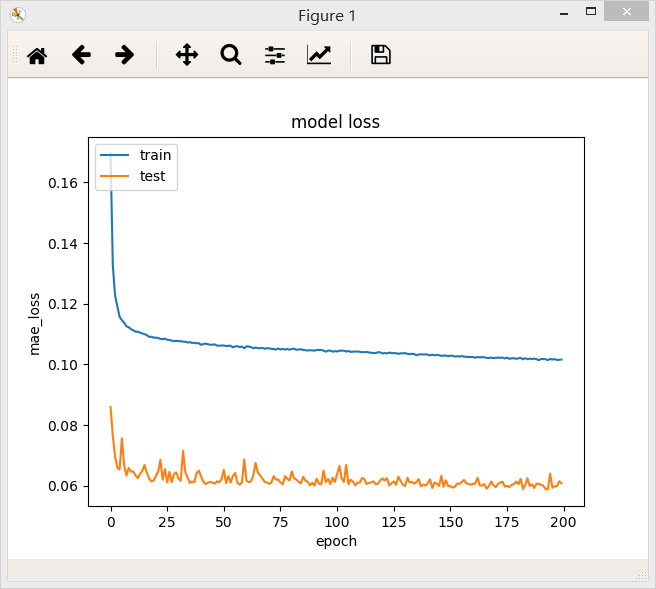
结论:第二种残差网络的loss值为0.1016,比第一种残差网络的效果能好一点。在ResNet中,这两个模块是交替使用的。
将两个模块叠加之后,模型的准确率并没有提升,应该是模型过度复杂了,最后模型的loss值为0.1027。
- relu还是tanh
由于输出值的范围是[-1, 1],因此模型的输出层的激活函数只能选择tanh。
在隐藏层中,可以选择relu和tanh作为隐藏层的激活函数。
模型结构为3层,神经元分别是32,32,32。就是上一个步骤中loss最低的网络结构,在上一个步骤中隐层的激活层使用的是tanh,loss值为0.0960
将tanh换成relu:

采用relu作为激活函数,模型的计算速度会加快,因为求导很简单。在这个问题只使用relu会使模型的准确率下降。一般在复杂的模型中使用relu比较多。
keras神经网络做简单的回归问题的更多相关文章
- [转]Theano下用CNN(卷积神经网络)做车牌中文字符OCR
Theano下用CNN(卷积神经网络)做车牌中文字符OCR 原文地址:http://m.blog.csdn.net/article/details?id=50989742 之前时间一直在看 Micha ...
- 基于BP神经网络的简单字符识别算法自小结(C语言版)
本文均属自己阅读源代码的点滴总结.转账请注明出处谢谢. 欢迎和大家交流.qq:1037701636 email:gzzaigcn2009@163.com 写在前面的闲话: 自我感觉自己应该不是一个非常 ...
- [转] Siamese network 孪生神经网络--一个简单神奇的结构
转自: 作者:fighting41love 链接:https://www.jianshu.com/p/92d7f6eaacf5 1.名字的由来 Siamese和Chinese有点像.Siam是古时候泰 ...
- 利用php的序列化和反序列化来做简单的数据本地存储
利用php的序列化和反序列化来做简单的数据本地存储 如下程序可以做为一个工具类 /** * 利用php的序列化和反序列化来做简单的数据本地存储 */ class objectdb { private ...
- 阿里云api调用做简单的cmdb
阿里云api调用做简单的cmdb 1 步骤 事实上就是调用阿里api.获取可用区,比方cn-hangzhou啊等等.然后在每一个区调用api 取ecs的状态信息,最好写到一个excel里面去.方便排序 ...
- Keras 实现一个简单GAN
Keras 实现一个简单GAN 代码中需提供: Loss Function 参见Keras 或者 Tensorflow 文档 model_param_matrix 反向调整的模型参数/参数矩阵 ...
- Java用户输入数值,做简单的猜数字游戏,导入基础的工具包util
Java用户输入数值,做简单的猜数字游戏,导入基础的工具包util,导入包的方法为,import java.util.*: 完整的实例代码: /* 导入基础工具包 */ import java.uti ...
- 使用jmeter做简单的场景设计
使用jmeter做简单的场景设计 Jmeter: Apache JMeter是Apache组织开发的基于Java的压力测试工具.用于对软件做压力测试.我之所以选择它,最重要的一点就是----开源 个人 ...
- Mycat 做简单的读写分离(转载)
大漠小狼的个人空间 http://www.51testing.com/html/34/369434-3686088.html 使用Mycat 做简单的读写分离(一) 原本使用的是amoeba做的读 ...
随机推荐
- clean exit - waiting for changes before restart
在使用nodemon的时候,针对于同一个文件一次使用还好,当多次使用的时候就会出现这样的情况: 解决办法: nodemon clean exit 原因: 可能是因为缓存造成的:
- react初始
一.一些基础概念 1.框架:基于整个项目的 2.库:在某个模块中单独使用,轻量级的 在vue中,DOM的操作时DOM指令调用js 在react中,所有的DOM 渲染都是由JS完成的 组件基于视图 模块 ...
- centos6删除mysql安装
1.查看已经安装了的mysql包: 2.卸载mysql: 3.查看剩下的mysql安装包: 4.逐个删除剩下的mysql安装包: 5.删除完后再次查看,以确保已删除干净: 6.删除自己安装的mysql ...
- JavaScript数组对象常用方法
JavaScript数组对象常用方法 方法 形式 返回值 是否改变原数组 描述 concat -items: ConcatArray[] 追加之后的数组 否 连接两个或更多的数组,并返回结果.注意 c ...
- [Offer收割] 编程练习赛1
A HihoCoder 1268 九宫 思路: 一般类似于数独的题目都是使用回溯解决,这里由于题目数据较小同样可以直接DFS得出结果.这里我用了一个偷懒的方法(next_permutation),直接 ...
- flutter-fluro
路由传参 route.dart import 'package:fluro/fluro.dart'; //添加页面 import 'package:m/pages/loginPage.dart'; i ...
- SAP 查询分析器,查询报表自动生成,SQL查询测试实现说明(转)
在日常的SAP开发和应用中,经常需要通过查询SAP数据表来处理日常业务,比如:数据对账.报表SQL测试.SAP查询功能开发等.通过开发SAP查询分析器,SAP实施和开发人员,可以在较短的时间内查询到需 ...
- Hadoop3.2.0集群(4节点-无HA)
1.准备环境 1.1配置dns # cat /etc/hosts 172.27.133.60 hadoop-01 172.27.133.61 hadoop-02 172.27.133.62 hadoo ...
- Linux系统 磁盘IO过高排查总结
最近做的一个电商网站因为磁盘 I/O 过高导致访问速度奇慢,问题存在两个月有余未得到解决办法.此次排查原因的经验可以作下次问题的参考. 1.会看懂 top 系统命令出来的各项参数.此次是无意中发现 u ...
- linux服务基础(一)之CentOS6编译安装httpd2.4
安装http-2.4 Http依赖于apr-1.4+,apr-util-1.4+ CentOS6上默认是apr-1.3,apr-util1.3 先编译安装apr-1.5,apr-util-1.5 开始 ...