
Kubernetes部署ELK并使用Filebeat收集容器日志
本文的试验环境为CentOS 7.3,Kubernetes集群为1.11.2,安装步骤参见kubeadm安装kubernetes V1.11.1 集群
1. 环境准备
Elasticsearch运行时要求vm.max_map_count内核参数必须大于262144,因此开始之前需要确保这个参数正常调整过。
$ sysctl -w vm.max_map_count=262144
也可以在ES的的编排文件中增加一个initContainer来修改内核参数,但这要求kublet启动的时候必须添加了--allow-privileged参数,但是一般生产中不会给加这个参数,因此最好在系统供给的时候要求这个参数修改完成。
ES的配置方式
- 使用Cluster Update Setting API动态修改配置
- 使用配置文件的方式,配置文件默认在 config 文件夹下,具体位置取决于安装方式。
- elasticsearch.yml 配置Elasticsearch
- jvm.options 配置ES JVM参数
- log4j.properties 配置ES logging参数
- 使用Prompt方式在启动时输入
最常使用的配置方式为使用配置文件,ES的配置文件为yaml格式,格式要求和Kubernetes的编排文件一样。配置文件中可以引用环境变量,例如node.name: ${HOSTNAME}
ES的节点
ES的节点Node可以分为几种角色:
- Master-eligible node,是指有资格被选为Master节点的Node,可以统称为Master节点。设置
node.master: true - Data node,存储数据的节点,设置方式为
node.data: true。 - Ingest node,进行数据处理的节点,设置方式为
node.ingest: true。 - Trible node,为了做集群整合用的。
对于单节点的Node,默认是master-eligible和data,对于多节点的集群,就要仔细规划每个节点的角色。
2. 单实例方式部署ELK
单实例部署ELK的方法非常简单,可以参考我Github上的elk-single.yaml文件,整体就是创建一个ES的部署,创建一个Kibana的部署,创建一个ES的Headless服务,创建一个Kiana的NodePort服务,本地通过节点的NodePort访问Kibana。
[root@devops-101 ~]# curl -L -O https://raw.githubusercontent.com/cocowool/k8s-go/master/elk/elk-single.yaml

[root@devops-101 ~]# kubectl apply -f elk-single.yaml

deployment.apps/kb-single created

service/kb-single-svc unchanged

deployment.apps/es-single created

service/es-single-nodeport unchanged

service/es-single unchanged

[root@devops-101 ~]# kubectl get all

NAME                             READY     STATUS    RESTARTS   AGE

pod/es-single-5b8b696ff8-9mqrz   1/1       Running   0          26s

pod/kb-single-69d6d9c744-sxzw9   1/1       Running   0          26s

NAME                         TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)                         AGE

service/es-single            ClusterIP   None             <none>        9200/TCP,9300/TCP               19m

service/es-single-nodeport   NodePort    172.17.197.237   <none>        9200:31200/TCP,9300:31300/TCP   13h

service/kb-single-svc        NodePort    172.17.27.11     <none>        5601:32601/TCP                  19m

service/kubernetes           ClusterIP   172.17.0.1       <none>        443/TCP                         14d

NAME                        DESIRED   CURRENT   UP-TO-DATE   AVAILABLE   AGE

deployment.apps/es-single   1         1         1            1           26s

deployment.apps/kb-single   1         1         1            1           26s

NAME                                   DESIRED   CURRENT   READY     AGE

replicaset.apps/es-single-5b8b696ff8   1         1         1         26s

replicaset.apps/kb-single-69d6d9c744   1         1         1         26s
可以看看效果如下:

3. 集群部署ELK
3.1 不区分集群中的节点角色
[root@devops-101 ~]# curl -L -O https://raw.githubusercontent.com/cocowool/k8s-go/master/elk/elk-cluster.yaml

[root@devops-101 ~]# kubectl apply -f elk-cluster.yaml

deployment.apps/kb-single created

service/kb-single-svc created

statefulset.apps/es-cluster created

service/es-cluster-nodeport created

service/es-cluster created
效果如下

3.2 区分集群中节点角色
如果需要区分节点的角色,就需要建立两个StatefulSet部署,一个是Master集群,一个是Data集群。Data集群的存储我这里为了简单使用了emptyDir,可以使用localStorage或者hostPath,关于存储的介绍,可以参考Kubernetes存储系统介绍。这样就可以避免Data节点在本机重启时发生数据丢失而重建索引,但是如果发生迁移的话,如果想保留数据,只能采用共享存储的方案了。具体的编排文件在这里elk-cluster-with-role
[root@devops-101 ~]# curl -L -O https://raw.githubusercontent.com/cocowool/k8s-go/master/elk/elk-cluster-with-role.yaml

[root@devops-101 ~]# kubectl apply -f elk-cluster-with-role.yaml

deployment.apps/kb-single created

service/kb-single-svc created

statefulset.apps/es-cluster created

statefulset.apps/es-cluster-data created

service/es-cluster-nodeport created

service/es-cluster created

[root@devops-101 ~]# kubectl get all

NAME                             READY     STATUS              RESTARTS   AGE

pod/es-cluster-0                 1/1       Running             0          13s

pod/es-cluster-1                 0/1       ContainerCreating   0          2s

pod/es-cluster-data-0            1/1       Running             0          13s

pod/es-cluster-data-1            0/1       ContainerCreating   0          2s

pod/kb-single-5848f5f967-w8hwq   1/1       Running             0          14s

NAME                          TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)                         AGE

service/es-cluster            ClusterIP   None             <none>        9200/TCP,9300/TCP               13s

service/es-cluster-nodeport   NodePort    172.17.207.135   <none>        9200:31200/TCP,9300:31300/TCP   13s

service/kb-single-svc         NodePort    172.17.8.137     <none>        5601:32601/TCP                  14s

service/kubernetes            ClusterIP   172.17.0.1       <none>        443/TCP                         16d

NAME                        DESIRED   CURRENT   UP-TO-DATE   AVAILABLE   AGE

deployment.apps/kb-single   1         1         1            1           14s

NAME                                   DESIRED   CURRENT   READY     AGE

replicaset.apps/kb-single-5848f5f967   1         1         1         14s

NAME                               DESIRED   CURRENT   AGE

statefulset.apps/es-cluster        3         2         14s

statefulset.apps/es-cluster-data   2         2         13s
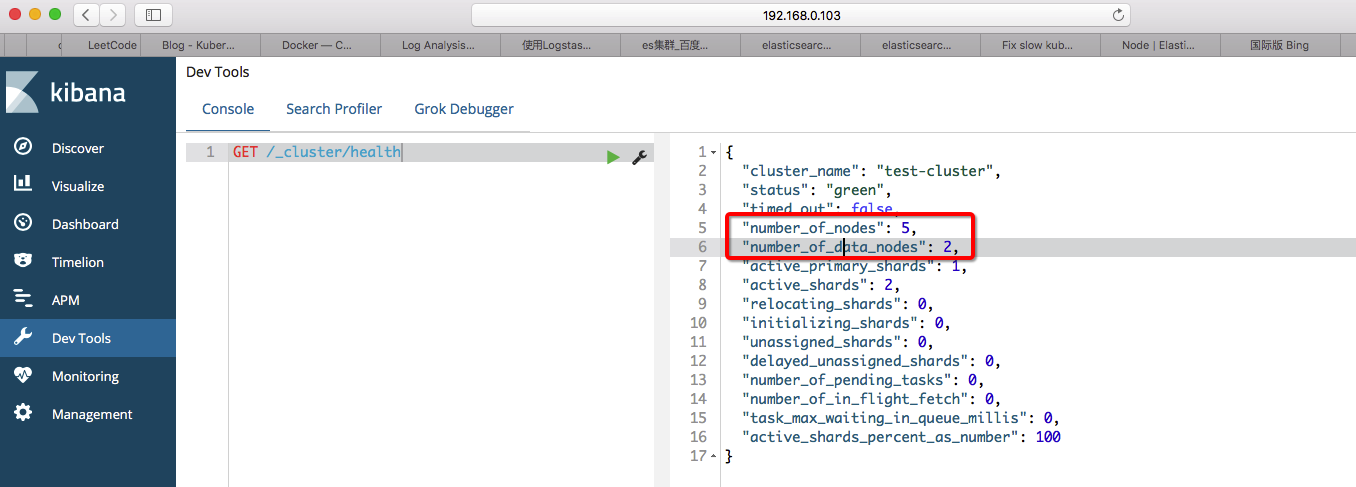
效果如下
4. 使用Filebeat监控收集容器日志
使用Logstash,可以监测具有一定命名规律的日志文件,但是对于容器日志,很多文件名都是没有规律的,这种情况比较适合使用Filebeat来对日志目录进行监测,发现有更新的日志后上送到Logstash处理或者直接送入到ES中。
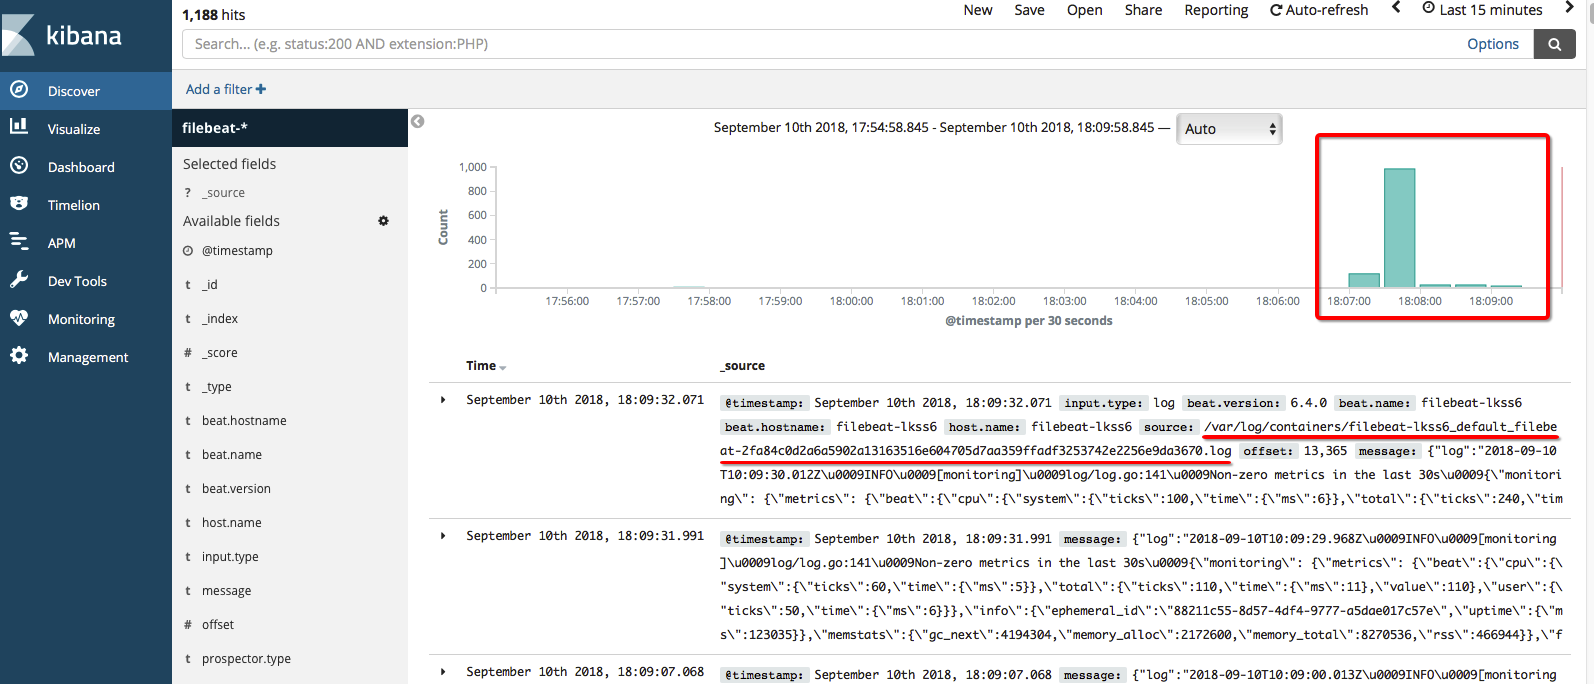
每个Node节点上的容器应用日志,默认都会在/var/log/containers目录下创建软链接,这里我遇到了两个小问题,第一个就是当时挂载hostPath的时候没有挂载软链接的目的文件夹,导致在容器中能看到软链接,但是找不到对应的文件;第二个问题是宿主机上这些日志权限都是root,而Pod默认用filebeat用户启动的应用,因此要单独设置下。
效果如下

具体的编排文件可以参考我的Github主页,提供了Deployment方式的编排和DaemonSet方式的编排。
对于具体日志的格式,因为时间问题没有做进一步的解析,这里如果有朋友做过,可以分享出来。
主要的编排文件内容摘抄如下。
kind: List

apiVersion: v1

items:

- apiVersion: v1

  kind: ConfigMap

  metadata:

    name: filebeat-config

    labels:

      k8s-app: filebeat

      kubernetes.io/cluster-service: "true"

      app: filebeat-config

  data:

    filebeat.yml: |

      processors:

        - add_cloud_metadata:

      filebeat.modules:

      - module: system

      filebeat.inputs:

      - type: log

        paths:

          - /var/log/containers/*.log

        symlinks: true

        # json.message_key: log

        # json.keys_under_root: true

      output.elasticsearch:

        hosts: ['es-single:9200']

      logging.level: info

- apiVersion: extensions/v1beta1

  kind: DaemonSet

  metadata:

    name: filebeat

    labels:

      k8s-app: filebeat

      kubernetes.io/cluster-service: "true"

  spec:

    template:

      metadata:

        name: filebeat

        labels:

          app: filebeat

          k8s-app: filebeat

          kubernetes.io/cluster-service: "true"

      spec:

        containers:

        - image: docker.elastic.co/beats/filebeat:6.4.0

          name: filebeat

          args: [

            "-c", "/home/filebeat-config/filebeat.yml",

            "-e",

          ]

          securityContext:

            runAsUser: 0

          volumeMounts:

          - name: filebeat-storage

            mountPath: /var/log/containers

          - name: varlogpods

            mountPath: /var/log/pods

          - name: varlibdockercontainers

            mountPath: /var/lib/docker/containers

          - name: "filebeat-volume"

            mountPath: "/home/filebeat-config"

        nodeSelector:

          role: front

        volumes:

          - name: filebeat-storage

            hostPath:

              path: /var/log/containers

          - name: varlogpods

            hostPath:

              path: /var/log/pods

          - name: varlibdockercontainers

            hostPath:

              path: /var/lib/docker/containers

          - name: filebeat-volume

            configMap:

              name: filebeat-config

参考资料:
- Elasticsearch cluster on top of Kubernetes made easy
- Install Elasticseaerch with Docker
- Docker Elasticsearch
- Running Kibana on Docker
- Configuring Elasticsearch
- Elasticsearch Node
- Loggin Using Elasticsearch and kibana
- Configuring Logstash for Docker
- Running Filebeat on Docker
- Filebeat中文指南
- Add experimental symlink support
Kubernetes部署ELK并使用Filebeat收集容器日志的更多相关文章
- K8S 使用 SideCar 模式部署 Filebeat 收集容器日志
对于 K8S 内的容器日志收集,业内一般有两种常用的方式: 使用 DaemonSet 在每台 Node 上部署一个日志收集容器,用于收集当前 Node 上所有容器挂载到宿主机目录下的日志 使用 Sid ...
- ELK日志分析系统(2)-logspout收集容器日志
1. 概述 安装了ELK之后,就是要考虑怎么获取log数据了. 收集log数据的方式有很多种: 1). beats采集数据发布到logstash 2). Filebeat采集数据发布到logstash ...
- ELK学习实验018:filebeat收集docker日志
Filebeat收集Docker日志 1 安装docker [root@node4 ~]# yum install -y yum-utils device-mapper-persistent-data ...
- ELK学习实验016:filebeat收集tomcat日志
filebeat收集tomcat日志 1 安装tomcat [root@node4 ~]# yum -y install tomcat tomcat-webapps tomcat-admin-weba ...
- 用elk+filebeat监控容器日志
elk 为 elasticsearch(查询搜索引擎),logstash(对日志进行分析和过滤,然后转发给elasticsearch),kibana(一个web图形界面用于可视化elasticsea ...
- ELK之filebeat收集多类型日志
1.IP规划 10.0.0.33:filebeat+tomcat,filebeat收集系统日志.tomcat日志发送到logstash 10.0.0.32:logstash,将日志写入reids(in ...
- ELK学习实验017:filebeat收集java日志
收集JAVA格式日志 1 查看Java格式日志 elasticsearch属于Java日志,可以收集elasticsearch作为Java日志范本 [root@node3 ~]# tail -f /u ...
- ELK 二进制安装并收集nginx日志
对于日志来说,最常见的需求就是收集.存储.查询.展示,开源社区正好有相对应的开源项目:logstash(收集).elasticsearch(存储+搜索).kibana(展示),我们将这三个组合起来的技 ...
- ELK filter过滤器来收集Nginx日志
前面已经有ELK-Redis的安装,此处只讲在不改变日志格式的情况下收集Nginx日志. 1.Nginx端的日志格式设置如下: log_format access '$remote_addr - $r ...
随机推荐
- 洛谷P4281 紧急会议
传送门啦 思路: $ Lca $ 这个题要求这个显而易见吧.但是难就难在怎么在树上利用 $ Lca $ 去解决三个点的问题. 首先明确三个点两两的 三个 $ Lca $ 中有一对是相等的,我们也会发现 ...
- MySQL数据库排序选择的作用和该如何选择编码格式
前言:在创建数据库的时候,会有这样一个选项->排序规则,平时在创建数据库的时候并没有注意,只是选择了默认,也没感觉有什么问题,今天看到这个突然好奇起来,所以看了一些资料做了以下的一些总结,若有错 ...
- LeetCode(53):最大子序和
Easy! 题目描述: 给定一个整数数组 nums ,找到一个具有最大和的连续子数组(子数组最少包含一个元素),返回其最大和. 示例: 输入: [-2,1,-3,4,-1,2,1,-5,4], 输出: ...
- 利用反射创建User类的对象
package com.bjpowernode; public class User { private int age; public String name; public void m1() { ...
- 删除一个存在的RabbitMQ队列
import sys # pip install kafka-python sys.path.append("/usr/local/software/ELK") from Util ...
- 接口隔离原则(Interface Segregation Principle, ISP)
使用多个专门的接口,而不使用单一的总接口 接口隔离有两种定义: Clients should not be forced to depend upon interfaces that they don ...
- hihocoder 1341 Constraint Checker【string】
hihocoder 1341 解释:这道题题目还是比较容易理解,就是根据输入的若干个不等式,校验后面输入的数据是否都满足前面的不等式,满足就输出Yes,只要有一个不满足就输出No.如“A<B&l ...
- Unix/Linux中/usr目录的由来
在Linux系统中,有一个很重要的目录——/usr目录.关于这个目录名称的由来,网上主要有下面几种说法: user的缩写 User Shareable Read-only的缩写 Unix/User S ...
- MSF《构建之法》阅读笔记5
第七章 MSF MSF是一种软件开发方法,MSF原则包括1推动信息共享和沟通,2为共同的远景而工作,3充分授权和信任,4各司其职,对项目共同负责,5交付增量的价值,6保持敏捷,预期和适应变化,7投资质 ...
- Ancient Printer
为找规律题 结果为 节点数*2-最长字段+字段个数 结点不能设置为0 与判断条件相冲突 #include<bits/stdc++.h> using namespace std; ...