
20172302 《Java软件结构与数据结构》实验二:树实验报告
课程:《Java软件结构与数据结构》
班级: 1723
姓名: 侯泽洋
学号:20172302
实验教师:王志强老师
实验日期:2018年11月5日
必修/选修: 必修
实验内容
(1)参考教材p212,完成链树LinkedBinaryTree的实现(getRight,contains,toString,preorder,postorder;用JUnit或自己编写驱动类对自己实现的LinkedBinaryTree进行测试,提交测试代码运行截图,要全屏,包含自己的学号信息
(2)基于LinkedBinaryTree,实现基于(中序,先序)序列构造唯一一棵二㕚树的功能,比如给出中序HDIBEMJNAFCKGL和先序ABDHIEJMNCFGKL,构造出附图中的树;用JUnit或自己编写驱动类对自己实现的功能进行测试,提交测试代码运行截图,要全屏,包含自己的学号信息
(3)自己设计并实现一颗决策树;提交测试代码运行截图,要全屏,包含自己的学号信息
(4)输入中缀表达式,使用树将中缀表达式转换为后缀表达式,并输出后缀表达式和计算结果;提交测试代码运行截图,要全屏,包含自己的学号信息
(5)完成PP11.3;提交测试代码运行截图,要全屏,包含自己的学号信息
(6)参考http://www.cnblogs.com/rocedu/p/7483915.html对Java中的红黑树(TreeMap,HashMap)进行源码分析,并在实验报告中体现分析结果。(C:\Program Files\Java\jdk-11.0.1\lib\src\java.base\java\util)
实验过程及结果
(1)实验一
完成链树LinkedBinaryTree的实现(getRight,contains,toString,preorder,postorder)
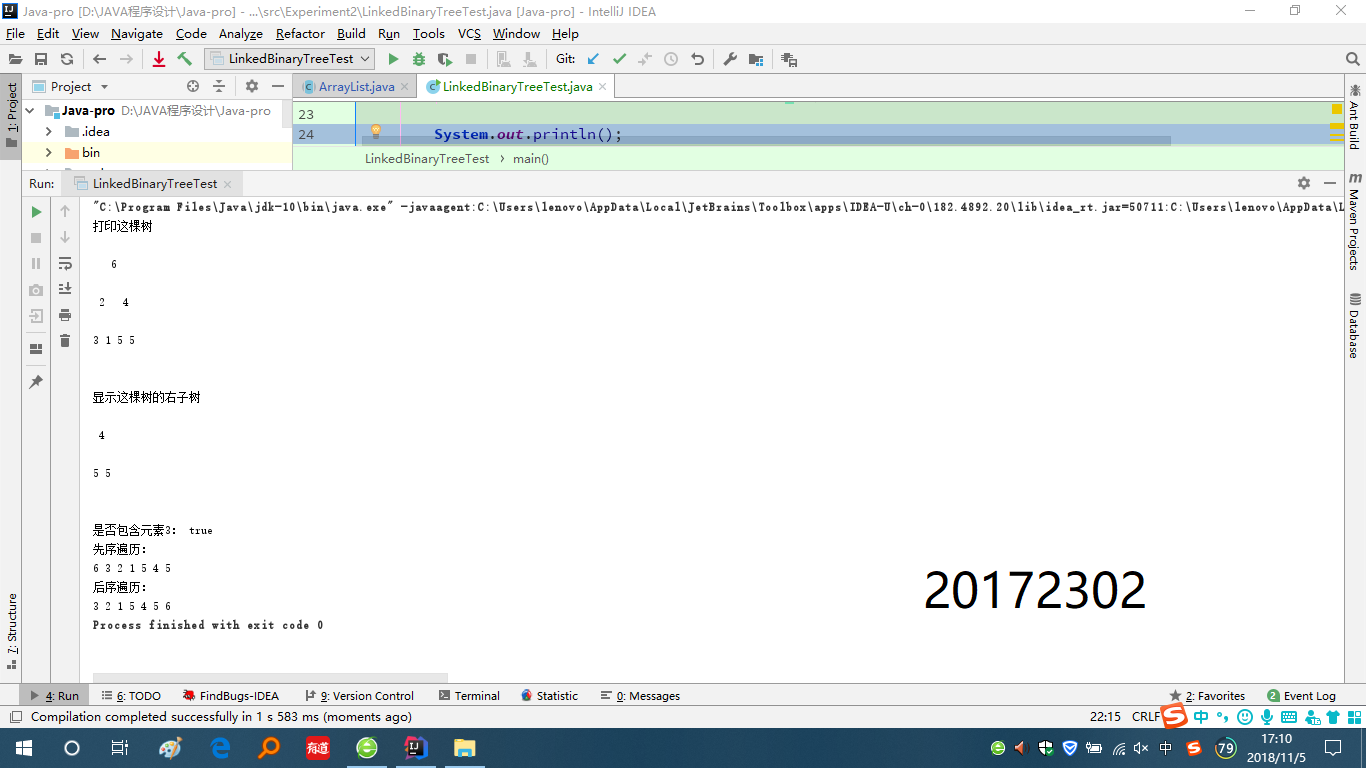
这里的方法编写在学习树时都有写过,所以直接编写了测试类,实验结果如图
(2)实验二
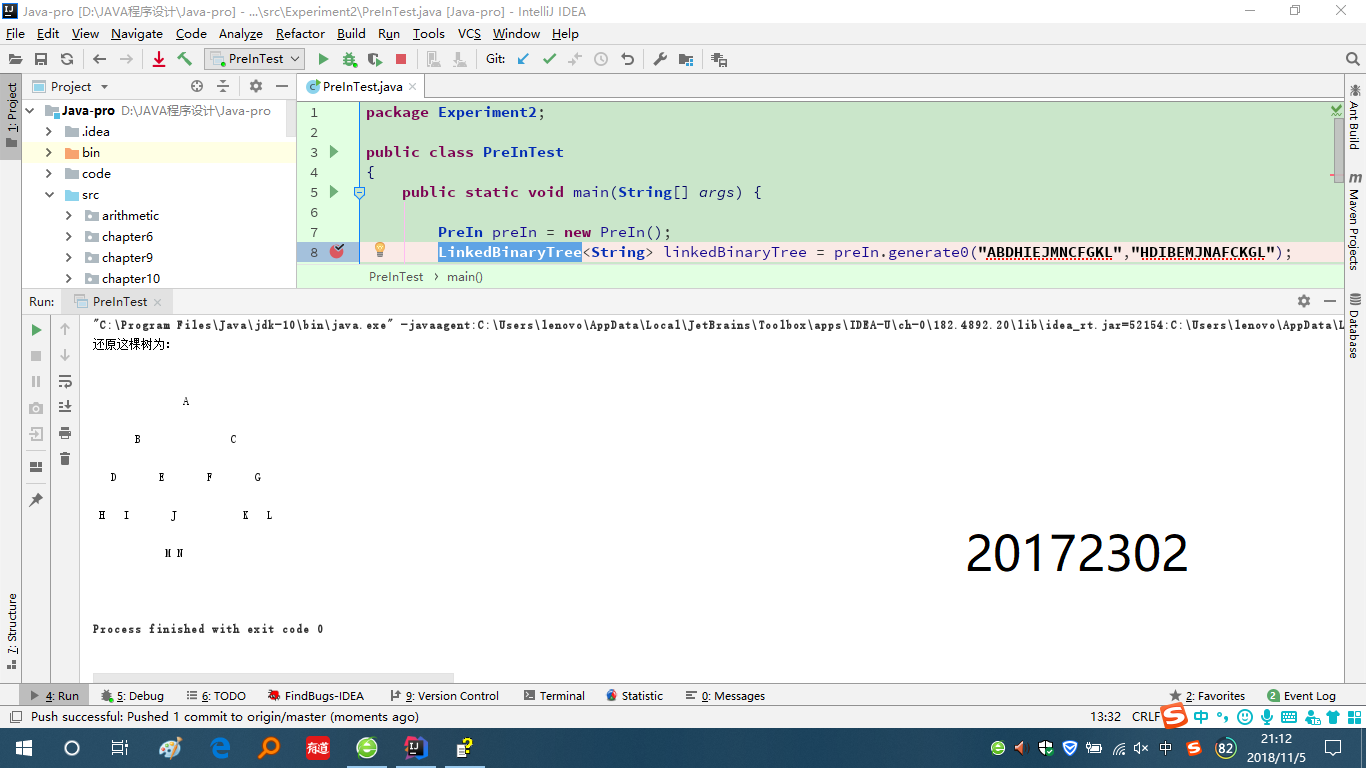
基于LinkedBinaryTree,实现基于(中序,先序)序列构造唯一一棵二㕚树的功能,这个需要新建类,类中写了公有方法generate0,generate0再去调用私有方法generate,
这个主要是利用传进来的先序和中序的字符串,确定根结点,然后再确定其左右孩子,接下来递归该过程,直至将该字符串读取完成。
实验结果截图:
(3)实验三
自己设计并实现一颗决策树,设计了一棵决策树去确定1至6之间的某个数。
11

Is the number greater than 3?

Is the number greater than 2?

Is the number greater than 4?

Is the number greater than 1?

Is the number greater than 5?

The number is 1.

The number is 2.

The number is 3.

The number is 4.

The number is 5.

The number is 6.

3 5 6

1 3 7

4 9 10

2 8 4

0 1 2
实验结果见图:

(4)实验四
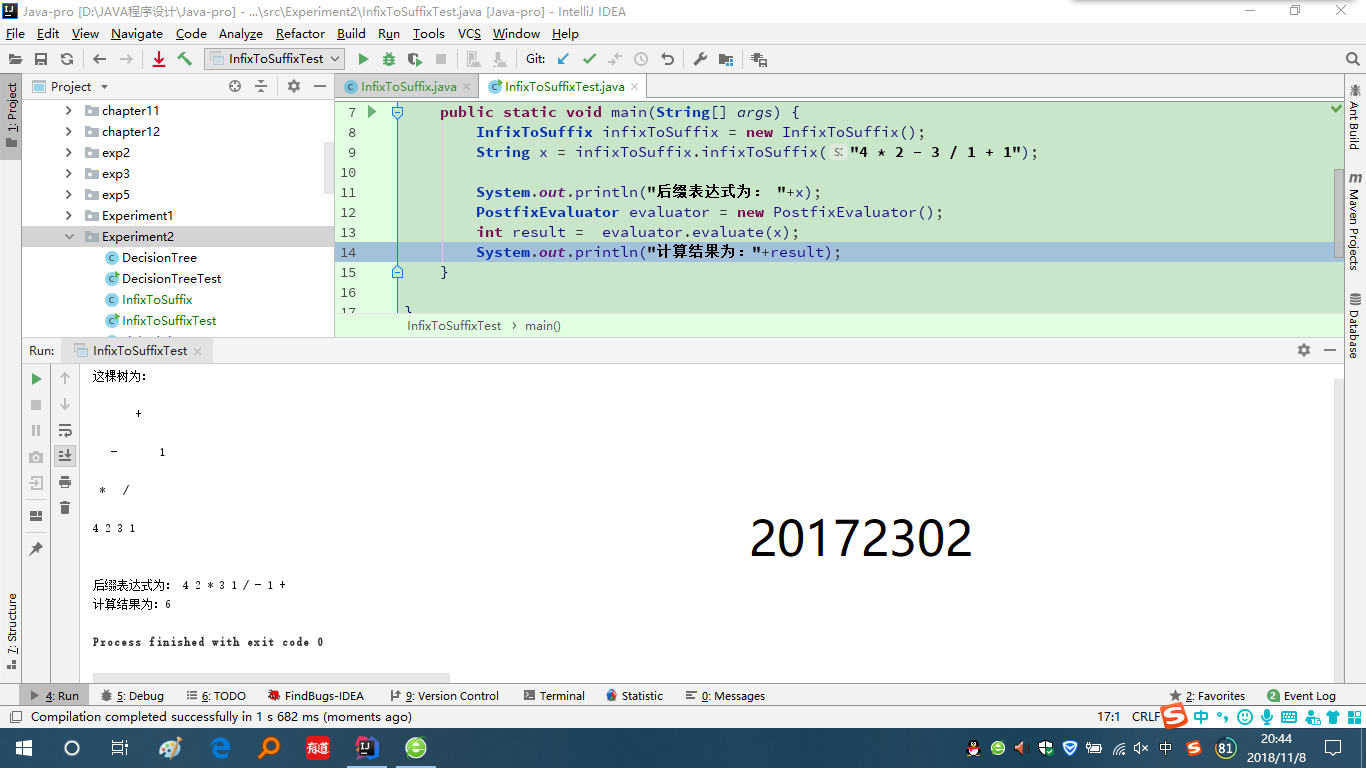
输入中缀表达式,使用树将中缀表达式转换为后缀表达式,这里是使用两个栈,一个是操作符栈,另一个是操作数栈,其中操作数栈是操作数是以树的类型进行存储的。实验结果见图:
(5)实验五
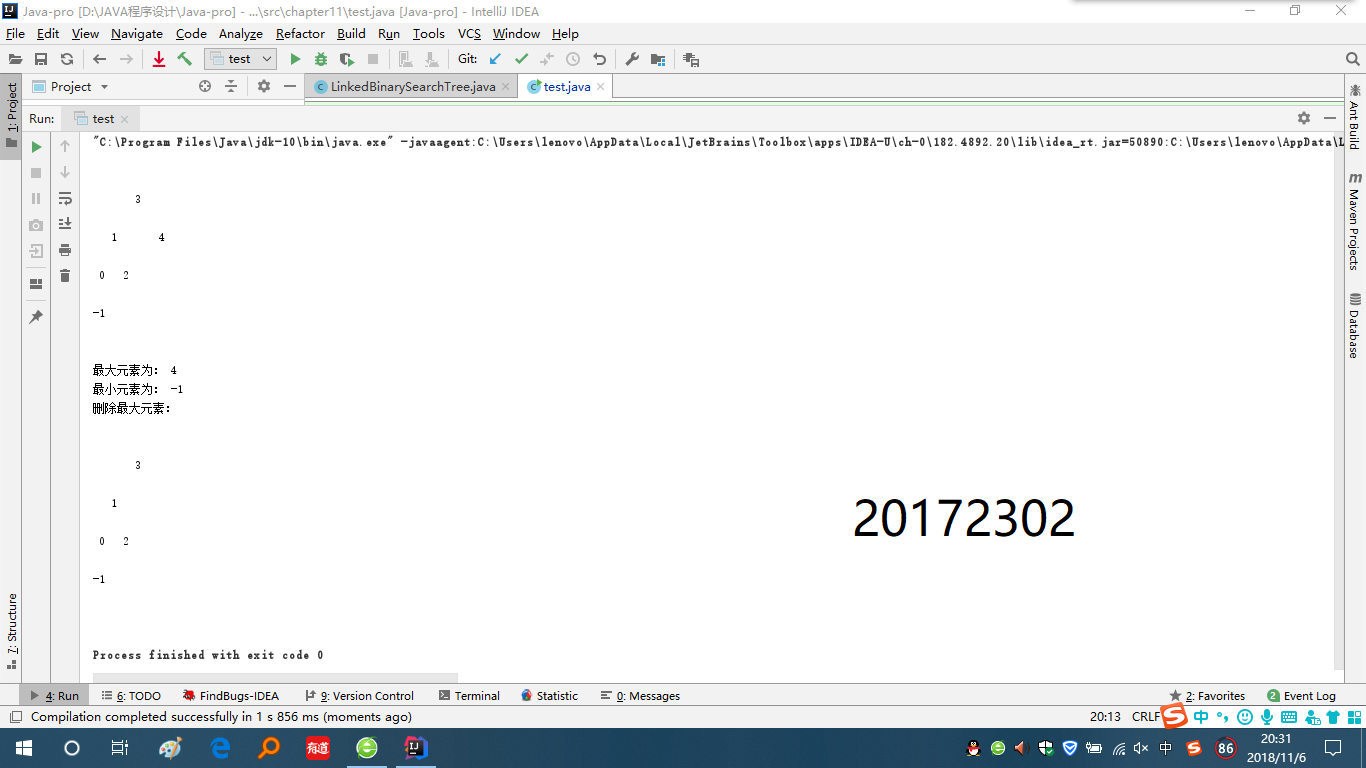
完成PP11.3;11.3在之前已经做过,测试了一次完成。
(6)实验六
看了一下TreeMap和Hashmap的源代码,一个3000多行,一个2400多行,太多了吧。于是从网上找资料看了一些源码分析,这里写一些。
1.继承结构
下面是HashMap与TreeMap的继承结构:
public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable {
public class TreeMap<K,V> extends AbstractMap<K,V> implements NavigableMap<K,V>, Cloneable, java.io.Serializable
可以看出它们都继承了AbstractMap。而HashMap是直接实现的Map,TreeMap实现的是NavigableMap(Cloneable和Serializable忽略)。
2.TreeMap
TreeMap是NavbagableMap的实现,底层基于红黑树。这个Map按照Comparable将键值排序,或者按照在创建Map时提供的Compartor。
TreeMap的底层是基于红黑树的实现,所以像get、put、remove、containsKey这些方法都会花费log(n)的时间复杂度。这儿不会着重于红黑树的具体实现以及转换,只要知道TreeMap的基本思路就可以了。
(1)put操作
    public V put(K key, V value) {

        Entry<K,V> t = root;

        // 1.如果根节点为 null,将新节点设为根节点

        if (t == null) {

            compare(key, key);

            root = new Entry<>(key, value, null);

            size = 1;

            modCount++;

            return null;

        }

        int cmp;

        Entry<K,V> parent;

        // split comparator and comparable paths

        Comparator<? super K> cpr = comparator;

        if (cpr != null) {

            // 2.为 key 在红黑树找到合适的位置

            do {

                parent = t;

                cmp = cpr.compare(key, t.key);

                if (cmp < 0)

                    t = t.left;

                else if (cmp > 0)

                    t = t.right;

                else

                    return t.setValue(value);

            } while (t != null);

        } else {

            // 与上面代码逻辑类似,省略

        }

        Entry<K,V> e = new Entry<>(key, value, parent);

        // 3.将新节点链入红黑树中

        if (cmp < 0)

            parent.left = e;

        else

            parent.right = e;

        // 4.插入新节点可能会破坏红黑树性质,这里修正一下

        fixAfterInsertion(e);

        size++;

        modCount++;

        return null;

    }
从put方法可以看到,有几步流程:
- 如果Map为空,那么直接将新插入的值作为根结点。此时,如果提供了Compartor,就得看Compartor是否支持null键值;如果没有提供Compartor,那么将会抛出NullPointerException。
- 如果Map不为空,那么需要找到新插入的键值的父节点。在查找过程中,如果遇到了键值相等的,那么将会调用Entry.setValue()更新值。
- 一旦找到了父节点,那么插入新节点,尺寸+1
(2)get操作
    public V get(Object key) {

        Entry<K,V> p = getEntry(key);

        return (p==null ? null : p.value);

    }

    final Entry<K,V> getEntry(Object key) {

        // Offload comparator-based version for sake of performance

        if (comparator != null)

            return getEntryUsingComparator(key);

        if (key == null)

            throw new NullPointerException();

        @SuppressWarnings("unchecked")

            Comparable<? super K> k = (Comparable<? super K>) key;

        Entry<K,V> p = root;

        // 查找操作的核心逻辑就在这个 while 循环里

        while (p != null) {

            int cmp = k.compareTo(p.key);

            if (cmp < 0)

                p = p.left;

            else if (cmp > 0)

                p = p.right;

            else

                return p;

        }

        return null;

    }
从上面可以看到,get()方法的流程:
- 如果提供了Comparator,那么使用getEntryUsingComparator()方法
- 如果没有提供Comparator,并且键为null,抛出NullPointerException
- 如果没有提供Comparator且键不为null,将键强制转换为Comparable接口,如果键没有实现,那么抛出ClassCastExceotion
- 如果没有提供Comparator且键不为null,且键实现了Comparable接口,那么从根结点开始遍历红黑树,一旦找到则返回节点,否则返回null
(3)remove操作
3.HashMap
HashMap是基于Hash table实现的Map,它实现了Map中所有的可选的操作,并且允许key或value为null,近似的等价于Hashtable(除了HashMap是非同步并且允许null值);它不保证元素的顺序;如果插入的元素被Hash函数正确的分散在不同的桶(槽,bucket)中,get和put操作都只需要常量时间。
(1)put操作
public V put(K key, V value) {

        //传入key的hash值,对hashCode值做位运算

        return putVal(hash(key), key, value, false, true);

    }

    final V putVal(int hash, K key, V value, boolean onlyIfAbsent,

                   boolean evict) {

        Node<K,V>[] tab; Node<K,V> p; int n, i;

        //如果tab为null,则通过resize初始化

        if ((tab = table) == null || (n = tab.length) == 0)

            n = (tab = resize()).length;

        //计算key的索引,如果为当前位置为null,直接赋值

        if ((p = tab[i = (n - 1) & hash]) == null)

            tab[i] = newNode(hash, key, value, null);

        else {

            //如果当前位置不为null

            Node<K,V> e; K k;

            //如果相同直接覆盖

            if (p.hash == hash &&

                ((k = p.key) == key || (key != null && key.equals(k))))

                e = p;

            //如果是红黑树节点,添加节点到红黑树,如果过程中发现相同节点则覆盖

            else if (p instanceof TreeNode)

                e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);

            //如果是链表节点

            else {

                for (int binCount = 0; ; ++binCount) {

                    //如果

                    if ((e = p.next) == null) {

                        p.next = newNode(hash, key, value, null);

                        if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st

                            treeifyBin(tab, hash);

                        break;

                    }

                    //找到相同节点则覆盖

                    if (e.hash == hash &&

                        ((k = e.key) == key || (key != null && key.equals(k))))

                        break;

                    p = e;

                }

            }

            //覆盖

            if (e != null) { // existing mapping for key

                V oldValue = e.value;

                if (!onlyIfAbsent || oldValue == null)

                    e.value = value;

                afterNodeAccess(e);

                return oldValue;

            }

        }

        //结构变化次数+1

        ++modCount;

        //如果size超过最大限制,扩容

        if (++size > threshold)

            resize();

        afterNodeInsertion(evict);

        return null;

    }
put()操作的主要是如下几个步骤:
首先判断Node[]数组table是否为空或null,如果是空那么进行一次resize,这次resize只是起到了一次初始化的作用。
根据key的值计算hash得到在table中的索引i,如果table[i]==null则添加新节点到table[i],然后判断size是否超过了容量限制threshold,如果超过进行扩容。
如果在上一步table[i]不为null时,判断table[i]节点是否和当前添加节点相同(这里使用hash和equals判断,因此需要保证hashCode()方法和equals()方法描述的一致性),如果相同则覆盖该节点的value。
如果上一步判断table[i]和当前节点不同,那么判断table[i]是否为红黑树节点,如果是红黑树节点则在红黑树中添加此key-value。
如果上一步判断table[i]不是红黑树节点则遍历table[i]链表,判断链表长度是否超过8,如果超过则转为红黑树存储,如果没有超过则在链表中插入此key-value。(jdk1.8以前使用头插法插入)。在遍历过程中,如果发现有相同的节点(比较hash和equals)就覆盖value。
维护modCount和size等其他字段。
(2)get操作
public V get(Object key) {

        Node<K,V> e;

        //传入key的hash

        return (e = getNode(hash(key), key)) == null ? null : e.value;

    }

    final Node<K,V> getNode(int hash, Object key) {

        Node<K,V>[] tab; Node<K,V> first, e; int n; K k;

        //这里访问(n - 1) & hash其实就是jdk1.7中indexFor方法的作用

        if ((tab = table) != null && (n = tab.length) > 0 &&

            (first = tab[(n - 1) & hash]) != null) {

            //判断桶索引位置的节点是不是相同(通过hash和equals判断),如果相同返回此节点

            if (first.hash == hash && // always check first node

                ((k = first.key) == key || (key != null && key.equals(k))))

                return first;

            if ((e = first.next) != null) {

                //判断是否是红黑树节点,如果是查找红黑树

                if (first instanceof TreeNode)

                    return ((TreeNode<K,V>)first).getTreeNode(hash, key);

                do {

                    //如果是链表,遍历链表

                    if (e.hash == hash &&

                        ((k = e.key) == key || (key != null && key.equals(k))))

                        return e;

                } while ((e = e.next) != null);

            }

        }

        //如果不存在返回null

        return null;

    }
实验过程中遇到的问题和解决过程
问题1:做实验2时我的树打印的始终是不完整的,只有A—J这些个元素,后面的元素就是消失了。

问题1解决方案:通过Debug,第二次时发现了问题,原来是我substring方法用的有问题,查看API中substring方法的具体介绍:
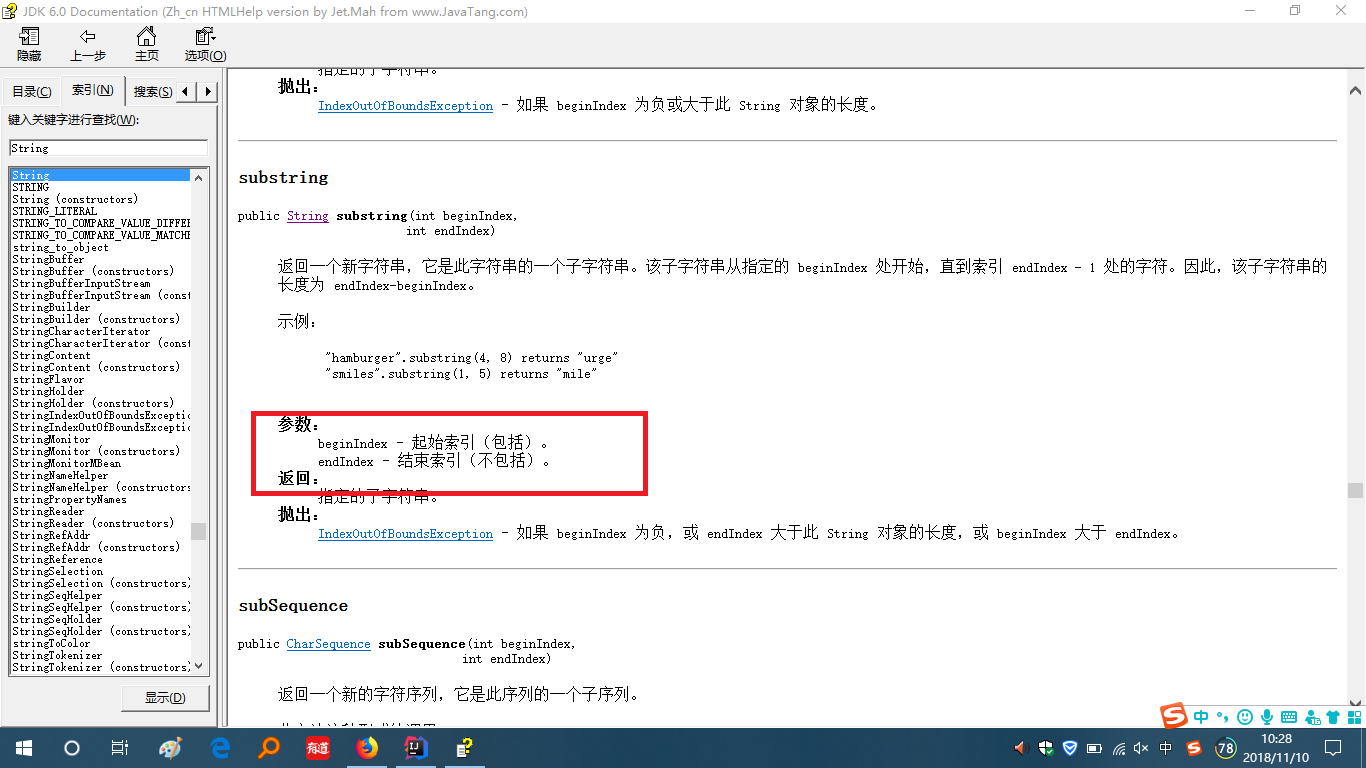
它的参数是包括起始索引,但不包括终止索引,而我在编写过程当中是默认了它是起始索引和终止索引都包括在内,这就会导致遗漏了一部分的元素,因此出现了这个问题,在原来的基础上把终止索引加1后即可解决该问题。问题2:实验4,实验4想了好久都没有一点思路,我不清楚怎么去使用树,在哪使用树,树是用来存储什么的?
问题2解决方案:我的想法一开始是落在把操作符所有的全部存在一棵树上,根据它的优先级去存储,写了之后才发现想的不对,因为这样我没有办法再去把他们按照正确顺序取出来。后面问了郭恺,他跟我说的是应该建立两个栈,两个栈中存储的数据类型分别是String和树类型,Sring类型的是操作符,树类型的是操作数,他提供的这个思路解决了我的问题。终于把这个问题弄明白了,于是开始重新编写。下面是关于操作符的优先级处理:
if (isOperator(m)) {

                if (m.equals("*") || m.equals("/"))

                    stack.push(m);

                else if (stack.empty())

                    stack.push(m);

                else {

                        while (!stack.isEmpty()) {

                            String s1 = String.valueOf(stack.pop());

                            LinkedBinaryTree operand3 = linkedBinaryTreeStack.pop();

                            LinkedBinaryTree operand4 = linkedBinaryTreeStack.pop();

                            LinkedBinaryTree<String> linkedBinaryTree1 =

                            new LinkedBinaryTree<String>(s1, operand4, operand3);

                            linkedBinaryTreeStack.push(linkedBinaryTree1);

                            if (stack.isEmpty())

                                break;

                    }

                    stack.push(m);

                }

            }
如果它是乘或除可以直接入栈,而当它是加或减时,需要把栈里的比它优先级高的取出来,取出来的时候需要同时从数栈里取出两个操作数,构成一棵新的树,再放入树的栈中,循环直至栈中没有元素,然后再把该操作符放入栈中,这样就可以实现了。
其他(感悟、思考等)
- 本次实验做的过程中让我感觉最难的就是实验4,自己一开始怎么想都是感觉不太对,在郭恺(非常感谢)给我的思路下,终于算是把这个实验做完了。HashMap和TreeMap源码分析太难了,整个完全弄懂还不太可能。
参考资料
20172302 《Java软件结构与数据结构》实验二:树实验报告的更多相关文章
- 20172302 《Java软件结构与数据结构》实验三:查找与排序实验报告
课程:<Java软件结构与数据结构> 班级: 1723 姓名: 侯泽洋 学号:20172302 实验教师:王志强老师 实验日期:2018年11月19日 必修/选修: 必修 实验内容 (1) ...
- 20172302 《Java软件结构与数据结构》实验一:线性结构实验报告
课程:<Java软件结构与数据结构> 班级: 1723 姓名: 侯泽洋 学号:20172302 实验教师:王志强老师 实验日期:2018年9月26日 必修/选修: 必修 实验内容 (1)链 ...
- 20172301 《Java软件结构与数据结构》实验二报告
20172301 <Java软件结构与数据结构>实验二报告 课程:<Java软件结构与数据结构> 班级: 1723 姓名: 郭恺 学号:20172301 实验教师:王志强老师 ...
- 20172329 2018-2019-2 《Java软件结构与数据结构》实验二报告
20172329 2018-2019-2 <Java软件结构与数据结构>实验二报告 课程:<Java软件结构与数据结构> 班级: 1723 姓名: 王文彬 学号:2017232 ...
- 20172301 《Java软件结构与数据结构》实验三报告
20172301 <Java软件结构与数据结构>实验三报告 课程:<Java软件结构与数据结构> 班级: 1723 姓名: 郭恺 学号:20172301 实验教师:王志强老师 ...
- 20172309 《Java软件结构与数据结构》实验三报告
课程:<程序设计与数据结构(下)> 班级:1723 姓名: 王志伟 学号:20172309 实验教师:王志强老师 实验日期:2018年11月2日 必修/选修: 必修 实验内容: 实验一: ...
- 20172329 2018-2019 《Java软件结构与数据结构》实验三报告
20172329 2018-2019-2 <Java软件结构与数据结构>实验三报告 课程:<Java软件结构与数据结构> 班级: 1723 姓名: 王文彬 学号:2017232 ...
- 20172301 《Java软件结构与数据结构》实验一报告
20172301 <Java软件结构与数据结构>实验一报告 课程:<Java软件结构与数据结构> 班级: 1723 姓名: 郭恺 学号:20172301 实验教师:王志强老师 ...
- 172322 2018-2019-1 《Java软件结构与数据结构》实验一报告
172322 2018-2019-1 <Java软件结构与数据结构>实验一报告 课程:<程序设计与数据结构> 班级: 1723 姓名: 张昊然 学号:20172322 实验教师 ...
随机推荐
- 写好shell脚本的13个技巧【转】
有多少次,你运行./script.sh,然后输出一些东西,但却不知道它刚刚都做了些什么.这是一种很糟糕的脚本用户体验.我将在这篇文章中介绍如何写出具有良好开发者体验的 shell 脚本. 产品的最终用 ...
- tomcat jsp页面乱码解决
浏览器接收服务器响应的中文参数: JSP页面中告诉浏览器使用什么编码: <%@ page language="java" contentType="text/htm ...
- 云服务器 linux文件系统异常an error occurren during the file system check导致服务器启动失败
云服务器 linux文件系统异常an error occurren during the file system check导致服务器启动失败 文件系统宕机,重启后报错,无法启动 处理流程: 1.编辑 ...
- zabbix3.0对tcp连接数和状态的监控优化
zabbix3.0对tcp连接数及状态的监控优化 之前对tcp的监控采用netstat命令,发现在服务器繁忙的时候效果不理想,这个命令占用大量的cpu有时候高达90%以上,可能会导致业务的不稳定,所以 ...
- nagios监控客户端报错/usr/bin/perl^M: bad interpreter: No such file or directory
nagios服务端监控客户端内存时发现监控不上 在客户端直接执行脚本,报错如下: # /usr/local/nagios/libexec/check_memory.pl -w 6% -c 3% -ba ...
- MyEclipse中如何配置默认jsp为UTF-8格式
- ajax相关知识点
AJAX的概念,即“Asynchronous Javascript And XML” 通过在后台(浏览器的后台)与服务器进行少量数据交换,AJAX 可以使网页实现异步更新.这意味着可以在不重新加载整个 ...
- C#面向对象(封装)
以上就是面向对象的封装和初始化:
- poj2442 堆应用
#include <cstdio> #include <cstring> #include <string> #include <vector> #in ...
- 字节、字、bit、byte的关系【转】
字 word 字节 byte 位 bit 字长是指字的长度 1字=2字节(1 word = 2 byte) 1字节=8位(1 byte = 8bit) 一个字的字长为16 一个字节的字长是8 bps ...