
sklearn中的分词函数countVectorizer()的改动--保留长度为1的字符串
1简述问题
使用countVectorizer()将文本向量化时发现,文本中长度唯一的字符串会被自动过滤掉,这对于我在做的情感分析来讲,一些表较重要的表达情感倾向的词汇被过滤掉,比如文本'没用的东西,可把我可把我坑的不轻,越用越觉得这个手机真的废'。
用结巴分词的精确模式分词,然后我用空格连接这些分词得到的句子是:
'没用 的 东西 , 可 把 我 可 把 我 坑 的 不轻 , 越用 越 觉得 这个 手机 真的 废'
代码如下:
def cut_word(sent):

    line=re.sub(r'[a-zA-Z0-9]*','',sent)

    wordList=jieba.lcut(line)

    #print(wordList)

    return ' '.join(wordList)

vec= CountVectorizer(min_df=1)

c='没用的东西,可把我可把我坑的不轻,越用越觉得这个手机真的废'

cut=cut_word(c)
然后用countVectorizer()对这个分好词的句子进行向量化发现,一个字的词都被过滤掉了:
['不轻', '东西', '手机', '没用', '真的','越用']
代码如下:
vec.fit_transform([cut])

vec.get_feature_names()
他把最能表达情感倾向的词“坑”,‘废’给过滤掉了,这对于向量化后的句子特征就损失了很多的信息。我认为因为这个库的函数原本就是为了英文分词的,而英文长度为1 的词是26个字母,并不会表示什么重要含义,所以在编写这个函数时自动就给这些长度低于2的单词给去掉了。但是中文可不一样,一个字的意义可以有非常重要的含义。对于我们分类不重要的词,比如一些代词“你”,‘我’,‘他’等其他经常出现的词,可以用停用词表给过滤掉,这个countVectorizer()就自带了一个组停用词的参数,stop_words,这个停用词是个列表包含了要去掉的停用词,我们可以针对自己需要自定义一个停用词表。当stop_words=‘english’时,函数会自动为英文文本分词去除停用词。中文都是自己自定义。
2解决方法
我是找了源代码,这个函数在sklearn包的feature_exceration文件夹中text.py。
找到了打开文件,找到了CountVectorizer()的代码,定位到fit_transform(raw_documents)中关于词汇表对于原始文本进行处理的地方

看见vocabulary这是包含所有分词的字典,再定位到_cout_vocab()函数位置,

看见raw_vocabulary了,796行是对特征(分词)进行计数的放到字典feature_counter中。doc是原始文本的每行文本,这利用analyze()处理,再往回找
analyze = self.build_analyzer(),可再往上找self.build_analyzer()函数,
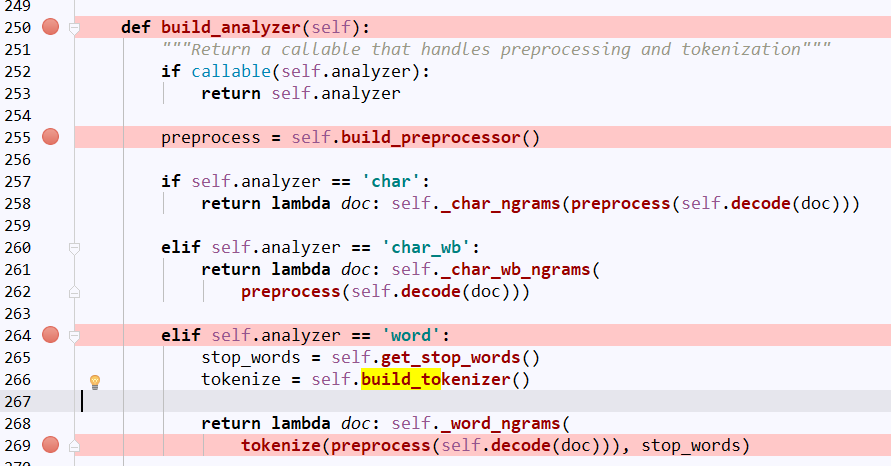
我们主要找的是对文本进行处理的函数,所以找的就是出现文本,且对文本进行操作的函数。定位到264行,根据countVectorizer()的初始定义self.analyzer的默认值是‘word’,所以
self.build_analyzer()函数默认情况下是跳到这里对文本dco进行操作。再看看preprocess()和tokenize()

找到self.build_preprocessor()看一下知道是对文本的编码格式以及大小写的操作,对文本预处理的函数。
重点到self.bulid_tokenizer(),看名字就是知道是分词函数了。

这是我该过的,#原句是 return lambda doc: token_pattern.findall(doc),是根据正则表达式token_patten来从文本doc中找到符合正则表达式的所有分词,可见问题出在这里,再回到原文本countVectorizer()定义的正则表达式。

#原句token_patten=u'(?u)\b\w\w+\b',水平太菜不太看懂这个表达式,反正试了一下,这个表达式真的会过滤掉字符长度为1的字符串,我就改了一下正则表达式。因为待分的文本都是分词好且用空格连起来的字符串,所以用郑子表达式空格作为切分文本的标记。
所以总的来说就是改了两个点
(1)CountVectorizer中将默认的正则表达式u'(?u)\b\w\w+\b'改为r"\s+:即token_pattern=r"\s+"
(2)self.build_tokenizer()中fiandall()替换成split(),即return lambda doc: token_pattern.split(doc)
3.测试
结合自己定义的停词表,去掉没用的词,再试一下分词效果:
原来分词效果:
['不轻', '东西', '手机', '没用', '真的','越用']
更改过后效果:
['不轻', '东西', '坑', '废', '手机', '没用', '真的', '越', '越用']
可见,长度为1的重要情感词,'坑', '废',得到了保留。
sklearn中的分词函数countVectorizer()的改动--保留长度为1的字符串的更多相关文章
- 转载 --- SKLearn中预测准确率函数介绍
混淆矩阵 confusion_matrix 下面将一一给出'tp','fp','fn'的具体含义: 准确率: 所有识别为"1"的数据中,正确的比率是多少. 如识别出来100个结果是 ...
- sklearn中的cross_val_score()函数
sklearn.cross_validation.cross_val_score(estimator, X, y=None, scoring=None, cv=None, n_jobs=1, verb ...
- sklearn中LinearRegression使用及源码解读
sklearn中的LinearRegression 函数原型:class sklearn.linear_model.LinearRegression(fit_intercept=True,normal ...
- sklearn中调用PCA算法
sklearn中调用PCA算法 PCA算法是一种数据降维的方法,它可以对于数据进行维度降低,实现提高数据计算和训练的效率,而不丢失数据的重要信息,其sklearn中调用PCA算法的具体操作和代码如下所 ...
- PYTHON练习题 二. 使用random中的randint函数随机生成一个1~100之间的预设整数让用户键盘输入所猜的数。
Python 练习 标签: Python Python练习题 Python知识点 二. 使用random中的randint函数随机生成一个1~100之间的预设整数让用户键盘输入所猜的数,如果大于预设的 ...
- 文本数据预处理:sklearn 中 CountVectorizer、TfidfTransformer 和 TfidfVectorizer
文本数据预处理的第一步通常是进行分词,分词后会进行向量化的操作.在介绍向量化之前,我们先来了解下词袋模型. 1.词袋模型(Bag of words,简称 BoW ) 词袋模型假设我们不考虑文本中词与词 ...
- sklearn中的模型评估-构建评估函数
1.介绍 有三种不同的方法来评估一个模型的预测质量: estimator的score方法:sklearn中的estimator都具有一个score方法,它提供了一个缺省的评估法则来解决问题. Scor ...
- sklearn中,数据集划分函数 StratifiedShuffleSplit.split() 使用踩坑
在SKLearn中,StratifiedShuffleSplit 类实现了对数据集进行洗牌.分割的功能.但在今晚的实际使用中,发现该类及其方法split()仅能够对二分类样本有效. 一个简单的例子如下 ...
- Jquery中的队列函数quene()、dequene()、clearQuene()
jQuery中的queue和dequeue是一组很有用的方法,他们对于一系列需要按次序运行的函数特别有用.特别animate动画,ajax,以及timeout等需要一定时间的函数.Queue()和de ...
随机推荐
- sbt的安装测试
1.下载 wget https://github.com/sbt/sbt/releases/download/v0.13.15/sbt-0.13.15.tgz 2.安装 tar -zxvf sbt-0 ...
- jquery easyui iconcls(小图标)属性的设置
今天用easyui做accordion的时候,觉得它自带的图标不够漂亮,想换成自己的图标,可是菜鸟我不知道怎么设置,上网查找,因为问题太水了,找不到,只好自己摸索,现在终于解决了,所以记录下来,同时也 ...
- AS3 - 数组元素乱序方法以及效率比较
http://www.hangge.com/blog/cache/detail_453.html
- jsfl 第一天
ctrl+f10,打开操作记录 通过打开到目标fla的舞台,然后运行写好的jsfl,默认就以目标fla为调试对象. 通过name可以获取层名字,帧标签,元件实例名等,name属性要根据对象的应用而产生 ...
- wildFly(Jboss as)入门
目录 简介 安装 使用 简介 JBoss AS 从8版本起名为wildfly.JBoss是纯Java的EJB(企业JavaBean)服务器. JBoss As 由 Redhat出品的开源免费服务器,采 ...
- Datetime 24小时制
24小时制: DateTime dt = DateTime.Now; string dt24 = dt.ToString("yyyy-MM-dd HH:mm:ss"); 12小时制 ...
- ubuntu安装openssh-server 报依赖错误的解决过程
ubuntu自带的有openssh-client,所以可以通过 ? 1 ssh username@host 来远程连接linux 可是要想通过ssh被连接,ubuntu系统需要有openssh-ser ...
- break、continue、pass介绍
break.continue.pass介绍 break:跳出当前循环 continue:跳出本次循环,进行下一次循环 pass:什么也不做,占位.
- oracle 文件系统
oracle数据文件信息 select * from v$datafile;--查看数据文件信息select * from v$controlfile;--查看控制文件信息 一.控制文件(Contro ...
- Spring RabbitMQ 延迟队列
一.说明 在实际业务场景中可能会用到延时消息发送,例如异步回调失败时的重发机制. RabbitMQ本身不具有延时消息队列的功能,但是可以通过rabbitmq-delayed-message-excha ...