
Hadoop整理四(Hadoop分布式计算框架MapReduce)
Apache Hadoop YARN (Yet Another Resource Negotiator,另一种资源协调者)是一种新的 Hadoop 资源管理器,它是一个通用资源管理系统,可为上层应用提供统一的资源管理和调度,它的引入为集群在利用率、资源统一管理和数据共享等方面带来了巨大好处。
YARN是在MRv1基础上演化而来的,它克服了MRv1中的各种局限性。
扩展性差:在 MRv1 中,JobTracker 同时兼备了资源管理和作业控制两个功能,这成为系统的一个最大瓶颈,严重制约了 Hadoop 集群扩展性。
可靠性差:MRv1采用了master/slave结构,其中master存在单点故障问题,一旦它出现故障将导致整个集群不可用。
资源利用率低:MRv1采用了基于槽位的资源分配模型,槽位是一种粗粒度的资源划分单位,通常一个任务不会用完槽位对应的资源,其他任务也无法使用这些空闲资源。此外,Hadoop将槽位分为Map Slot和Reduce Slot两种,且不允许它们之间共享, 常常会导致一种槽位资源紧张而另外一种闲置(比如一个作业刚刚提交时,只会运行Map Task,此时Reduce Slot闲置)。
无法支持多种计算框架:随着互联网高速发展,MapReduce这种基于磁盘的离线计算框架已经不能满足应用要求,从而出现了一些新的计算框架,包括内存计算框架、流式计算框架和迭代式计算框架等,而MRv1不能支持多种计算框架并存。
yarn的工作流程:
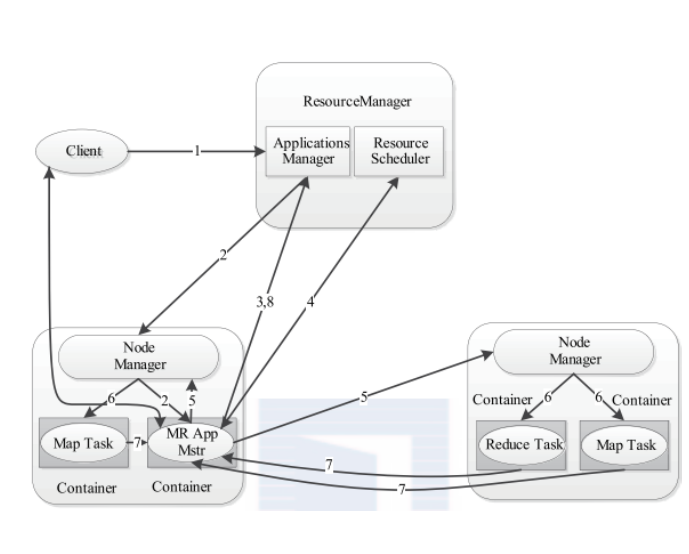
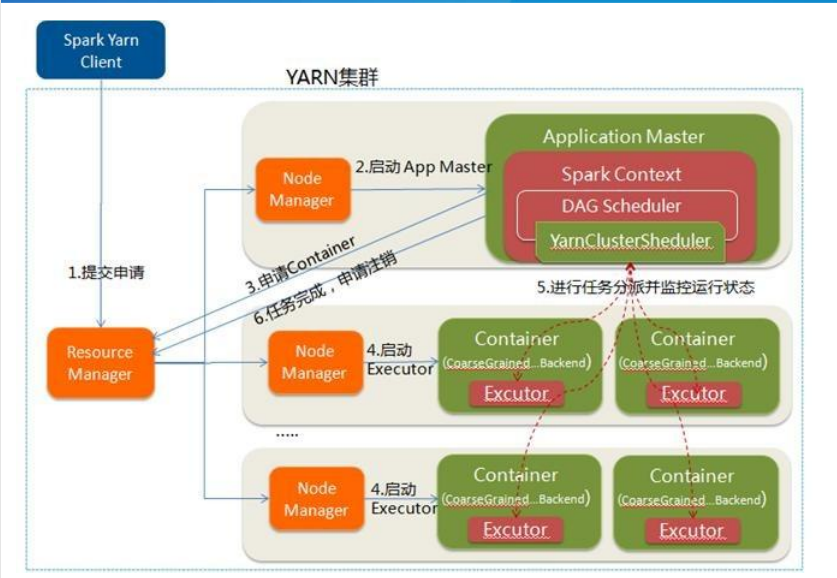
1.用户向YARN提交应用程序,其中包括ApplicationMaster程序,启动AM的命令,用户程序。
2.RM为该应用程序分配第一个Container,并与对应的NM通信,要求它在这个Container中启动应用程序对应的AM。
3.AM启动后向RM注册,用户可以直接通过RM查看应用程序的运行状态。重复4~7。
4.AM采用轮询的方式通过RPC协议向RM申请和领取资源。
5.一旦AM申请到资源后,与对应的NM通信,要求它启动任务。
6.NM为任务设置好运行环境(包括环境变量、JAR包、二级制程序等)后,将任务启动命令写入一个脚本中,通过该脚本启动任务。
7.各个任务通过RPC协议向AM汇报自己的状态和进度,以让AM随时掌握任务的运行状态,从而可以在任务失败时重启任务。
8.任务运行完成后,AM向RM注销并关闭自己。
资源调度器是YARN中最核心的组件之一,且是插拔式的,它定义了一整套接口规范以便用户可按照需要实现自己的调度器。YARN自带了FIFO、Capacity Scheduler和Fair Scheduler三种常用资源调度器,当然,用户可按照接口规范编写一个新的资源调度器,并通过简单的配置使它运行起来。
YARN采用了双层资源调度模型:在第一层中,ResourceManager中的资源调度器将资源分配给各个ApplicationMaster;在第二层中,ApplicationMaster再进一步将资源分配给它内部的各个任务。这里资源调度器主要关注的是第一层的调度问题,至于第二层的调度策略,完全由用户应用程序自己决定。
YARN采用的是pull-base通信模型,而不是push-base通信模型。资源调度器将资源分配给一个应用程序后,它不会立刻push给对应的ApplicationMaster,而是暂时放到一个缓冲区中,等待ApplicationMaster通过周期性的心跳主动来取。
在资源调度器中,每个队列可设置一个最小资源量和最大资源量,其中,最小资源量是资源紧缺情况下每个队列需保证的资源量,而最大资源量则是极端情况下队列也不能超过的资源使用量。资源抢占发生的原因则完全是由于“最小资源量”这一概念。通常而言,为了提高资源利用率,资源调度器(包括Capacity Scheduler和Fair Scheduler) 会将负载较轻的队列的资源暂时分配给负载重的队列(即最小资源量并不是硬资源保证,当队列不需要任何资源时,并不会满足它的最小资源量,而是暂时将空闲资源分配给其他需要资源的队列),仅当负载较轻队列突然收到新提交的应用程序时,调度器才进一步将本属于该队列的资源分配给它。但由于此时资源可能正被其他队列使用,因此调度器必须等待其他队列释放资源后,才能将这些资源“物归原主”,这通常需要一段不确定的等待时间。为了防止应用程序等待时间过长, 调度器等待一段时间后若发现资源并未得到释放,则进行资源抢占。
Hadoop整理四(Hadoop分布式计算框架MapReduce)的更多相关文章
- Hadoop 三剑客之 —— 分布式计算框架 MapReduce
一.MapReduce概述 二.MapReduce编程模型简述 三.combiner & partitioner 四.MapReduce词频统计案例 4.1 项目简介 ...
- Hadoop 学习之路(三)—— 分布式计算框架 MapReduce
一.MapReduce概述 Hadoop MapReduce是一个分布式计算框架,用于编写批处理应用程序.编写好的程序可以提交到Hadoop集群上用于并行处理大规模的数据集. MapReduce作业通 ...
- Hadoop 系列(三)—— 分布式计算框架 MapReduce
一.MapReduce概述 Hadoop MapReduce 是一个分布式计算框架,用于编写批处理应用程序.编写好的程序可以提交到 Hadoop 集群上用于并行处理大规模的数据集. MapReduce ...
- hadoop基础----hadoop理论(四)-----hadoop分布式并行计算模型MapReduce具体解释
我们在前一章已经学习了HDFS: hadoop基础----hadoop理论(三)-----hadoop分布式文件系统HDFS详细解释 我们已经知道Hadoop=HDFS(文件系统,数据存储技术相关)+ ...
- 2_分布式计算框架MapReduce
一.mr介绍 1.MapReduce设计理念是移动计算而不是移动数据,就是把分析计算的程序,分别拷贝一份到不同的机器上,而不是移动数据. 2.计算框架有很多,不是谁替换谁的问题,是谁更适合的问题.mr ...
- Hadoop整理三(Hadoop分布式计算框架MapReduce)
一.概念 MapReduce是一种编程模型,用于大规模数据集(大于1TB)的并行运算.概念"Map(映射)"和"Reduce(归约)",是它们的主要思想.它极大 ...
- 分布式计算框架-MapReduce 基本原理(MP用于分布式计算)
hadoop最主要的2个基本的内容要了解.上次了解了一下HDFS,本章节主要是了解了MapReduce的一些基本原理. MapReduce文件系统:它是一种编程模型,用于大规模数据集(大于1TB)的并 ...
- hadoop深入研究:(十三)——序列化框架
hadoop深入研究:(十三)--序列化框架 Mapreduce之序列化框架(转自http://blog.csdn.net/lastsweetop/article/details/9376495) 框 ...
- 大数据时代之hadoop(五):hadoop 分布式计算框架(MapReduce)
大数据时代之hadoop(一):hadoop安装 大数据时代之hadoop(二):hadoop脚本解析 大数据时代之hadoop(三):hadoop数据流(生命周期) 大数据时代之hadoop(四): ...
随机推荐
- Linux6.x修改出eth0网卡的解决方法
1. 编辑70-persistent-net配置文件: # -persistent-net.rules 如果没有就新建一个,添加如下内容: # PCI device 0x14e4:0x165f (tg ...
- Spring4笔记3--Bean的装配
Bean的装配: Bean 的装配,即 Bean 对象的创建.容器根据代码要求创建 Bean 对象后再传递给代码的过程,称为 Bean 的装配. 1. 创建Bean对象的方式: 1. 通过 getBe ...
- 深拷贝数组 np.copy
数组对象自带了浅拷贝和深拷贝的方法,但是一般用深拷贝多一些: 代码如下: >>> a = np.ones((2,2)) >>> b = a >>> ...
- flask基础之app初始化(四)
前言 flask的核心对象是Flask,它定义了flask框架对于http请求的整个处理逻辑.随着服务器被启动,app被创建并初始化,那么具体的过程是这样的呢? 系列文章 flask基础之安装和使用入 ...
- Git 管理本地代码【转】
转自:http://www.cnblogs.com/JessonChan/archive/2011/03/16/1986570.html 以前用SVN,不过没有用出感情来:倒是用出不少怨恨:由于没有很 ...
- spring boot 测试用例
junit 是一个面向于研发人员使用的轻量的测试模块,适合做单元测试.而testng百度后发现更强大,可以做功能测试,但对于我这种RD,貌似junit足沟了呢! java Mock PowerMock ...
- 缓存数据库-redis安装和配置
一:redis安装 python操作redis分为两部分,一为安装redis程序 二是安装支持python操作redis的模块 1)安装redis redis 官方网站:http://www.redi ...
- 详解MySQL大表优化方案
单表优化 除非单表数据未来会一直不断上涨,否则不要一开始就考虑拆分,拆分会带来逻辑.部署.运维的各种复杂度,一般以整型值为主的表在千万级以下,字符串为主的表在五百万以下是没有太大问题的.而事实上很多时 ...
- caffe可视化
1.画网络图 假
- 使用T-SQL导入多个文件数据到SQL Server中
在我们的工作中,经常需要连续输入多个文件的数据到SQL Server的表中,有时需要从相同或者不同的目录中,同时将文件中的数据倒入.在这篇文章中,我们将讨论如何同时把一个目录中的文件的数据倒入到SQL ...