
Hadoop整理三(Hadoop分布式计算框架MapReduce)
一.概念
MapReduce是一种编程模型,用于大规模数据集(大于1TB)的并行运算。概念"Map(映射)"和"Reduce(归约)",是它们的主要思想。它极大地方便了编程人员在不会分布式并行编程的情况下,将自己的程序运行在分布式系统上。 当前的软件实现是指定一个Map(映射)函数,用来把一组键值对映射成一组新的键值对,指定并发的Reduce(归约)函数,用来保证所有映射的键值对中的每一个共享相同的键组。
大规模数据处理时, MapReduce 在三个层面上的基本构思 。
如何对付大数据处理:分而治之
对相互间不具有计算依赖关系的大数据,实现并行最自然的办法就是采取分而治之的策略。
上升到抽象模型: Mapper 与 Reducer
MPI等并行计算方法缺少高层并行编程模型,为了克服这一缺陷,MapReduce借鉴了Lisp函数式语言中的思想,用Map和Reduce两个函数提供了高层的并行编程抽象模型。
上升到构架:统一构架,为程序员隐藏系统层细节
MPI等并行计算方法缺少统一的计算框架支持,程序员需要考虑数据存储、划分、分发、结果收集、错误恢复等诸多细节;为此,MapReduce设计并提供了统一的计算框架,为程序员隐藏了绝大多数系统
层面的处理细节。
不可分拆的计算任务或相互间有依赖关系的数据无法进行并行计算!
序列化是指将结构化的数据转化为字节流以便在网络上传输或写入到磁盘进行永久存储的过程,反序列化是指将字节流转换为结构化对象的逆过程。序列化常见应用场景:进程间通信和永久存储。
Hadoop中,序列化要满足:紧凑,快速,可扩展,支持互相操作。Hadoop中使用了自己的序列化格式Writable。它绝对紧凑、速度快、但不容易扩展。
自定义数据类型:
实现Writable接口,以便该数据能被序列化后完成网络传输或文件输入/输出。
如果该数据需要作为主键key使用,或需要比较数值大小时,则需要实现WritableComparable接口。
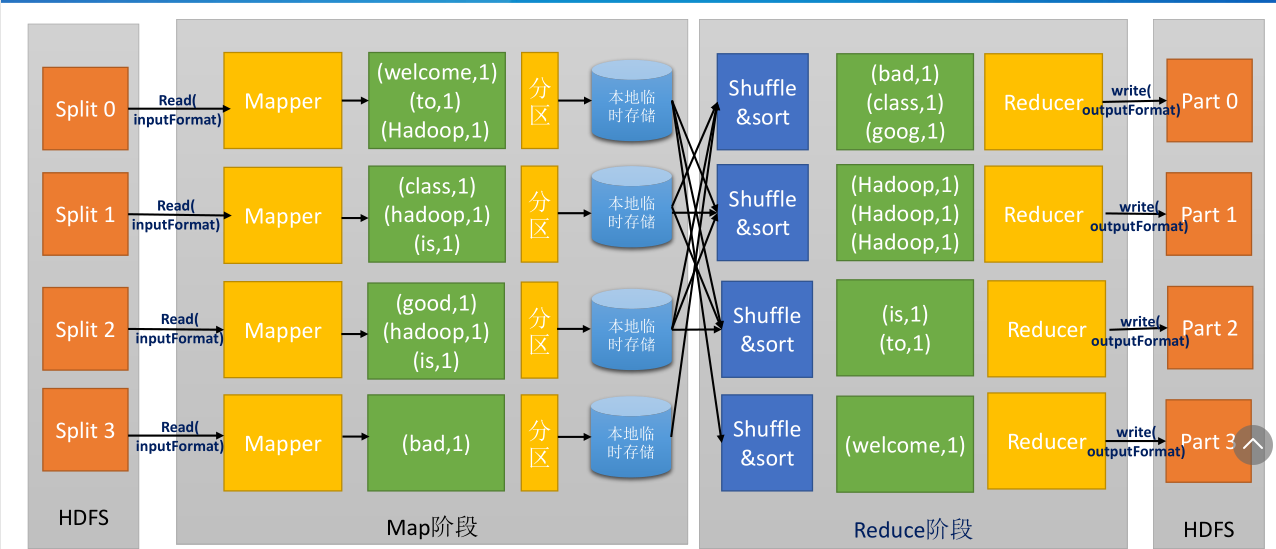
集群上最紧俏的资源便是网络带宽,因此尽量减少map和reduce阶段的网络传输对MapReduce的性能提升是很重要的。Hadoop为map任务的输出指定了一个合并函数(combiner),合并函数的输出作为reduce的输入。Combiner是的map的输出结果更加紧凑,同时减少了写磁盘和网络传输的数据量。 Combiner 又称为Local Reducer 。
Hadoop整理三(Hadoop分布式计算框架MapReduce)的更多相关文章
- Hadoop 学习之路(三)—— 分布式计算框架 MapReduce
一.MapReduce概述 Hadoop MapReduce是一个分布式计算框架,用于编写批处理应用程序.编写好的程序可以提交到Hadoop集群上用于并行处理大规模的数据集. MapReduce作业通 ...
- Hadoop 系列(三)—— 分布式计算框架 MapReduce
一.MapReduce概述 Hadoop MapReduce 是一个分布式计算框架,用于编写批处理应用程序.编写好的程序可以提交到 Hadoop 集群上用于并行处理大规模的数据集. MapReduce ...
- Hadoop 三剑客之 —— 分布式计算框架 MapReduce
一.MapReduce概述 二.MapReduce编程模型简述 三.combiner & partitioner 四.MapReduce词频统计案例 4.1 项目简介 ...
- Hadoop整理四(Hadoop分布式计算框架MapReduce)
Apache Hadoop YARN (Yet Another Resource Negotiator,另一种资源协调者)是一种新的 Hadoop 资源管理器,它是一个通用资源管理系统,可为上层应用提 ...
- 分布式计算框架-MapReduce 基本原理(MP用于分布式计算)
hadoop最主要的2个基本的内容要了解.上次了解了一下HDFS,本章节主要是了解了MapReduce的一些基本原理. MapReduce文件系统:它是一种编程模型,用于大规模数据集(大于1TB)的并 ...
- 2_分布式计算框架MapReduce
一.mr介绍 1.MapReduce设计理念是移动计算而不是移动数据,就是把分析计算的程序,分别拷贝一份到不同的机器上,而不是移动数据. 2.计算框架有很多,不是谁替换谁的问题,是谁更适合的问题.mr ...
- hadoop基础----hadoop理论(四)-----hadoop分布式并行计算模型MapReduce具体解释
我们在前一章已经学习了HDFS: hadoop基础----hadoop理论(三)-----hadoop分布式文件系统HDFS详细解释 我们已经知道Hadoop=HDFS(文件系统,数据存储技术相关)+ ...
- Hadoop第三课
1.3Hadoop基础知识 1.3.1术语解释 1.Hadoop1.0 • 第一代Hadoop,由分布式文件系统HDFS 和分布式计算框架MapReduce组成 • HDFS由一个NameNode和多 ...
- hadoop深入研究:(十三)——序列化框架
hadoop深入研究:(十三)--序列化框架 Mapreduce之序列化框架(转自http://blog.csdn.net/lastsweetop/article/details/9376495) 框 ...
随机推荐
- C#委托Code
class Program { delegate double ProcessDelegate(double param1, double param2); static double Multipl ...
- Writing your first academic paper
Writing your first academic paper If you are working in academics (and you are if you are working wi ...
- Dialog插件artDialog
经本人测试,发现没有layer好用,因为artDialog不能拖拽.不过除了拖拽,其他还蛮简洁的,在自定义上的灵活性也还可以.下面是我自己写的测试demo. <!DOCTYPE html> ...
- highCharts参数实例解释
<!DOCTYPE html> <html> <head> <meta http-equiv="Content-Type" content ...
- 网络编程之python zeromq学习系列之一
简介: zeromq中间件,他是一个轻量级的消息中间件,传说是世界上最快的消息中间件,为什么这么说呢? 因为一般的消息中间件都需要启动消息服务器,但是zeromq这厮尽然没有消息服务器,他压根没有消息 ...
- HDU1693 Eat the Trees(zerojudge a228)
传送门: https://zerojudge.tw/ShowProblem?problemid=a228 http://acm.hdu.edu.cn/showproblem.php?pid=1693 ...
- 爬虫笔记之JS检测浏览器开发者工具是否打开
在某些情况下我们需要检测当前用户是否打开了浏览器开发者工具,比如前端爬虫检测,如果检测到用户打开了控制台就认为是潜在的爬虫用户,再通过其它策略对其进行处理.本篇文章主要讲述几种前端JS检测开发者工具是 ...
- 创造101:如果软件测试工程师组团出道,怎样才能站C位?!
作者 C位出道的华华 虽然华华是一个软件测试技术宅,可以连续七七四十九天加班不重样,心里除了上班工作学习写代码就没有别的爱好了,但是各种潮流资讯啊狗血剧啊娱乐综艺啊,从来没有错过. 比如说现在大火的& ...
- Rico Board.1.环境配置
1.搭建开发环境 1.解压文件 sudo tar -jvxf gcc-linaro-arm-linux-gnueabihf-4.7-2013.03-20130313_liunx.tar.bz2 -C ...
- UNIX环境高级编程 第16章 网络IPC:套接字
上一章(15章)中介绍了UNIX系统所提供的多种经典进程间通信机制(IPC):管道PIPE.命名管道FIFO.消息队列Message Queue.信号量Semaphore.共享内存Shared Mem ...