
Spark基础:(六)Spark SQL
1、相关介绍
Datasets:一个 Dataset 是一个分布式的数据集合 Dataset 是在 Spark 1.6 中被添加的新接口, 它提供了 RDD 的优点(强类型化, 能够使用强大的 lambda 函数)与Spark SQL执行引擎的优点。
DataFrame: 一个 DataFrame 是一个 Dataset 组成的指定列。、
SparkSession: Spark SQL中所有功能的入口点是 SparkSession 类,要创建一个 SparkSession, 使用 SparkSession.builder()就可以。
需要注意的是:
import spark.implicits._

//这里的spark是SparkSession的变量名
对DataFrame和Dataset进行操作许多操作都需要这个包进行支持。DataFrames可以从多种数据源创建,例如:结构化数据文件(JSON)、Hive中的表、外部数据库或者已存在的RDDs。
2、入门
(1)Json
准备json文件
{"id":1,"age":15,"name":"zhangsan"},

{"id":2,"age":13,"name":"zhangsi"},

{"id":3,"age":14,"name":"zhangwu"}
读取json文件
java版
public class SQLJava {

    public static void main(String[] args) {

        SparkSession session = SparkSession.builder()

                            .appName("SQLJava")

                            .config("spark.master","local")

                            .getOrCreate();

        Dataset<Row> df1 = session.read().json("file:///f:/spark/info.json");

        df1.show();

        df1.printSchema();

        //创建临时视图

        df1.createOrReplaceTempView("customers");

        //按照sql方式查询

        Dataset<Row> df2 = session.sql("select * from customers where age > 13");

        df2.show();

        System.out.println("=================");

        //聚合查询

        Dataset<Row> dfCount = session.sql("select count(1) from customers");

        dfCount.show();

        //DataFrame和RDD互操作

        JavaRDD<Row> rdd = df1.toJavaRDD();

        rdd.collect().forEach(new Consumer<Row>() {

            public void accept(Row row) {

                long age = row.getLong(0);

                long id = row.getLong(1);

                String name = row.getString(2);

                System.out.println(age + "," + id + "," + name);

            }

        });

        //保存处理,设置保存模式

        df2.write().mode(SaveMode.Append).json("file:///f:/spark/json/out.dat");

}
Scala版
object SparkSql {

  def main(args: Array[String]): Unit = {

    val session=SparkSession.builder()

      .appName("AQLScala")

      .config("spark.master","local")

      .getOrCreate()

    val df1=session.read.json("file:///f:/spark/info.json")

    df1.show()

    df1.printSchema()

    //创建视图

    df1.createOrReplaceTempView("customers")

    val df2 = session.sql("select * from customers where age >13")

    df2.show()

    //聚合操作

    val df3 = session.sql("select count(*) from customers")

    df3.show()

    //DataFrame和RDD互操作

    df1.rdd.map(e=>{

      "id="+e(e.fieldIndex("id"))+"\tname="+e(e.fieldIndex("name"))+"\tage="+e(e.fieldIndex("age"))

    }).foreach(println(_))

    df1.write.mode(SaveMode.Append).json("file:///f:/spark/json/out.dat")

  }
部分输出
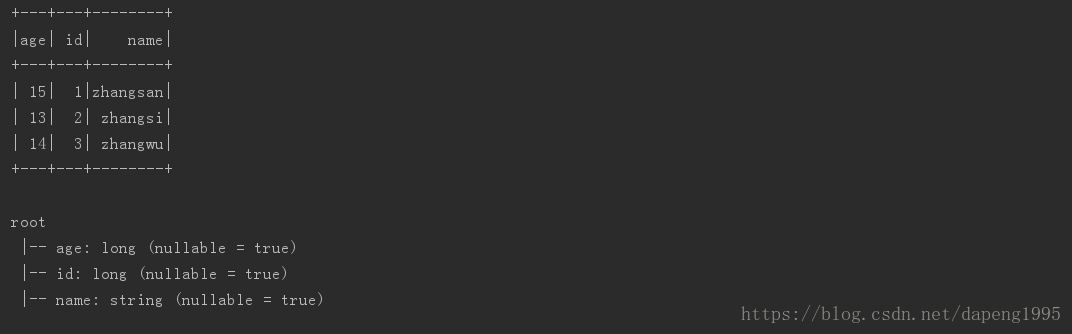
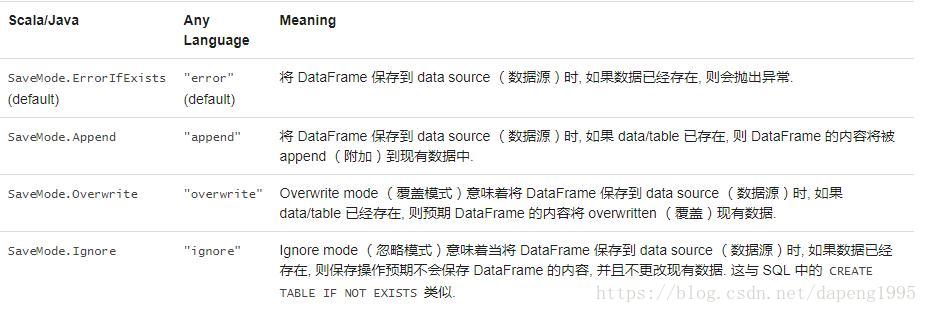
还要注意的就是Save Modes : Save operations (保存操作)可以选择使用 SaveMode , 它指定如何处理现有数据如果存在的话. 重要的是要意识到, 这些 save modes (保存模式)不使用任何 locking (锁定)并且不是 atomic (原子). 另外, 当执行 Overwrite 时, 数据将在新数据写出之前被删除.
Spark SQL中的临时视图是session级别的, 也就是会随着session的消失而消失. 如果你想让一个临时视图在所有session中相互传递并且可用, 直到Spark 应用退出, 你可以建立一个全局的临时视图.
(2)jdbc
java代码
public class SQLJDBCJava1 {

    public static void main(String[] args) {

        SparkSession session = SparkSession.builder()

                            .appName("SQLJava")

                            .config("spark.master","local")

                            .getOrCreate();

        String url = "jdbc:mysql://localhost:3306/mybatis" ;

        //要查询的数据库中的表

        String table = "users" ;

        //查询数据库

        Dataset<Row> df = session.read()

                .format("jdbc")

                .option("url", url)

                .option("dbtable", table)

                .option("user", "root")

                .option("password", "root")

                .option("driver", "com.mysql.jdbc.Driver")

                .load();

        df.show();

        //投影查询

        Dataset<Row> df2 = df.select(new Column("name"),new Column("age"));

        //过滤

        df2 = df2.where("age > 13");

        df2.show();

        //去重

        df2 = df2.distinct();

        df2.show();

        //

        Properties prop = new Properties();

        prop.put("user", "root");

        prop.put("password", "root");

        prop.put("driver", "com.mysql.jdbc.Driver");

        //写入数据库中  subpersons为表

        df2.write().jdbc(url,"subpersons",prop);

        df2.show();

    }

}
scala代码
object SQLJdbc {

  def main(args: Array[String]): Unit = {

    val session=SparkSession.builder()

      .config("spark.master","local")

      .appName("SQLJdbc")

      .getOrCreate()

    val url="jdbc:mysql://localhost:3306/mybatis"

    //要查询的数据库中的表

    val table="users"

    //连接属性

    val df=session.read

      .format("jdbc")

      .option("url", url)

      .option("dbtable", table)

      .option("user", "root")

      .option("password", "root")

      .option("driver", "com.mysql.jdbc.Driver")

      .load()

    df.show()

    println("===============")

    val df2=df.select(new Column("name"),new Column("age"))

    df2.where("name like 't%'")

    df2.show()

    //数据库的连接属性

    val prop = new Properties()

    prop.put("user", "root")

    prop.put("password", "root")

    prop.put("driver", "com.mysql.jdbc.Driver")

    //写入数据库中  subpersons为表

    df2.write.jdbc(url, "subpersons", prop)

    df2.show()

  }

}
(3)Hive
Spark SQL 还支持读取和写入存储在 Apache Hive 中的数据。但是,由于 Hive 具有大量依赖关系,因此这些依赖关系不包含在默认 Spark 分发中。 如果在类路径中找到 Hive 依赖项,Spark 将自动加载它们。 请注意,这些 Hive 依赖关系也必须存在于所有工作节点上,因为它们将需要访问 Hive 序列化和反序列化库 (SerDes),以访问存储在 Hive 中的数据。
通过将 hive-site.xml, core-site.xml(用于安全配置)和 hdfs-site.xml (用于 HDFS 配置)文件放在 conf/ 中来完成配置。
启动hiveserver2服务器,监听端口是10000 ——-进入hive/bin下,启动hiveserver2,或者采用命令
hive –service hiveserver2 & 来启动,(通过hive-jdbc驱动程序采用jdbc方式远程访问远程数据仓库)
但是我按照文档上的方法没有成功,采用以下的方法实现了
java版本
public class SQLHiveJava {

    public static void main(String[] args) throws Exception {

        Class.forName("org.apache.hive.jdbc.HiveDriver");

        Connection conn = DriverManager.getConnection("jdbc:hive2://s201:10000");

        Statement st = conn.createStatement();

        ResultSet rs = st.executeQuery("select * from mydb.t1 where age > 13");

        while(rs.next()){

            int id=rs.getInt(1);

            String name=rs.getString(2);

            int age=rs.getInt(3);

            System.out.println(id+","+name+","+age);

        }

        rs.close();

    }

}
scala版本
object SparkSqlHive {

  def main(args: Array[String]): Unit = {

    Class.forName("org.apache.hive.jdbc.HiveDriver")

    val conn = DriverManager.getConnection("jdbc:hive2://s201:10000")

    //创建上下文

    val stat = conn.createStatement()

    //结果

    val resultSet = stat.executeQuery("select * from mydb.t1 where age > 13")

    while ( resultSet.next) {

      val id = resultSet.getInt(1)

      val name = resultSet.getString(2)

      val age = resultSet.getInt(3)

      println(id + "," + name + "," + age)

    }

    resultSet.close()

  }

}
输出结果:
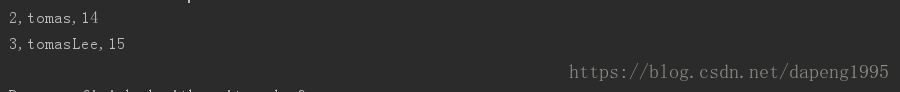
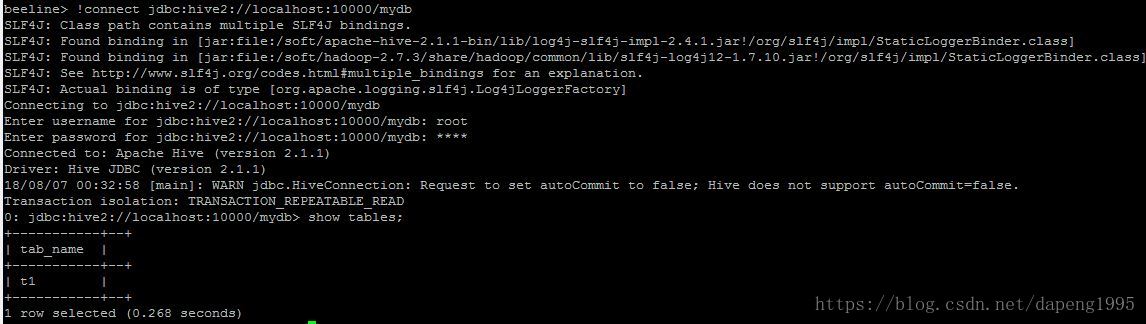
注意:通过远程jdbc方式连接到hive数据仓库
(1)首先启动hiveserver2服务器,监听端口10000
(2)通过beeline命令行连接到hiveserver2 (进入beeline命令行 hive –service beeline)
通过命令 !connect jdbc:hive2://localhost:10000/mydb 连接到数据库
如图:
Spark基础:(六)Spark SQL的更多相关文章
- Spark 基础操作
1. Spark 基础 2. Spark Core 3. Spark SQL 4. Spark Streaming 5. Spark 内核机制 6. Spark 性能调优 1. Spark 基础 1. ...
- spark基础知识(1)
一.大数据架构 并发计算: 并行计算: 很少会说并发计算,一般都是说并行计算,但是并行计算用的是并发技术.并发更偏向于底层.并发通常指的是单机上的并发运行,通过多线程来实现.而并行计算的范围更广,他是 ...
- 最全的spark基础知识解答
原文:http://www.36dsj.com/archives/61155 一. Spark基础知识 1.Spark是什么? UCBerkeley AMPlab所开源的类HadoopMapReduc ...
- Spark学习之Spark SQL
一.简介 Spark SQL 提供了以下三大功能. (1) Spark SQL 可以从各种结构化数据源(例如 JSON.Hive.Parquet 等)中读取数据. (2) Spark SQL 不仅支持 ...
- spark基础知识介绍2
dataframe以RDD为基础的分布式数据集,与RDD的区别是,带有Schema元数据,即DF所表示的二维表数据集的每一列带有名称和类型,好处:精简代码:提升执行效率:减少数据读取; 如果不配置sp ...
- spark基础知识介绍(包含foreachPartition写入mysql)
数据本地性 数据计算尽可能在数据所在的节点上运行,这样可以减少数据在网络上的传输,毕竟移动计算比移动数据代价小很多.进一步看,数据如果在运行节点的内存中,就能够进一步减少磁盘的I/O的传输.在spar ...
- spark第六篇:Spark Streaming Programming Guide
预览 Spark Streaming是Spark核心API的扩展,支持高扩展,高吞吐量,实时数据流的容错流处理.数据可以从Kafka,Flume或TCP socket等许多来源获取,并且可以使用复杂的 ...
- Spark基础学习精髓——第一篇
Spark基础学习精髓 1 Spark与大数据 1.1 大数据基础 1.1.1 大数据特点 存储空间大 数据量大 计算量大 1.1.2 大数据开发通用步骤及其对应的技术 大数据采集->大数据预处 ...
- Spark基础知识详解
Apache Spark是一种快速通用的集群计算系统. 它提供Java,Scala,Python和R中的高级API,以及支持通用执行图的优化引擎. 它还支持一组丰富的高级工具,包括用于SQL和结构化数 ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
随机推荐
- Bzoj P2054 疯狂的馒头 | 并查集
题目链接 思路:因为每次染色都会将某些馒头的颜色彻底更改,所以每个馒头的最终的颜色其实是由最后一次染色决定的,那么我们只考虑最后一次染色即可.对此,我们可以从后往前倒着染色,当目前的染色区间中存在白色 ...
- centos7 永久修改hostname
1.修改 /etc/sysconfig/network ,重启后还是原来的主机名 2.百度有说明是/etc/rc.d/rc.sysinit下的脚本还原了还来主机名,问题是的我主机上没有这个脚本 3.执 ...
- exec系统调用 && 进程的加载过程
exec系统调用会从指定的文件中读取并加载指令,并替代当前调用进程的指令.从某种程度上来说,这样相当于丢弃了调用进程的内存,并开始执行新加载的指令. exec系统调用会保留当前的文件描述符表单.所以任 ...
- Spring Cloud Alibaba 使用Feign进行服务消费
为什么使用Feign? Feign可以把Rest的请求进行隐藏,伪装成类似SpringMVC的Controller一样.你不用再自己拼接url,拼接参数等等操作,一切都交给Feign去做. 使用Fei ...
- loadrunner12自带的机票预订服务,解决httpd: Could not reliably determine the server's fully qualified domain name 问题
遇到以上问题是在启动loadrunner12自带的机票预订服务器情况下遇到的,错误提示如下图: 解决方案: 编辑httpd.conf 文件,加入一句 ServerName localhost:1080 ...
- let that = this用法解析
这种情况就是在一个代码片段里this有可能代表不同的对象,而编码者希望this代表最初的对象
- OPPO 图数据库平台建设及业务落地
本文首发于 OPPO 数智技术公众号,WeChat ID: OPPO_tech 1.什么是图数据库 图数据库(Graph database)是以图这种数据结构存储和查询的数据库.与其他数据库不同,关系 ...
- myeclipse与tomcat,运行jsp程序
一.myeclipse中配置JRE 步骤: 1.选择window->preferences->Java->Installed JREs 2.点击窗口右边的"add" ...
- 分享一个工具方法:日期格式化 & 日期转化,用法与java类SimpleDateFormat类似
/** * y 年(201X) * M 年中的月份(1-12) * d 月份中的天数(1-31) * H 一天中的小时数(0-23) * h am/pm 中的小时数(1-12) * m 小时中的分钟数 ...
- WinRAR下载
https://www.win-rar.com 垃圾7Z有的解压不了.