
python爬虫采集
python爬虫采集
最近有个项目需要采集一些网站网页,以前都是用php来做,但现在十分流行用python做采集,研究了一些做一下记录。
采集数据的根本是要获取一个网页的内容,再根据内容筛选出需要的数据,
python的好处是速度快,支持多线程,高并发,可以用来大量采集数据,缺点就是和php相比,python的轮子和代码库貌似没有php全,而且python的安装稍微麻烦了点,折腾了好久。
python3的安装见连接:
https://www.cnblogs.com/mengzhilva/p/11059329.html
工具编辑器:
PyCharm :一款很好用的python专用编辑器,可以编译和运行,支持windows
python采集用到的库:
requests:用来获取网页的内容,支持https,用户登录信息等,很强大
lxml:用来解析采集的html内容,十分好用,比较灵活,但很多用法不好找,api文档不好找。
pymysql:连接操作mysql,这个就不用说了,将采集到的信息存到数据库。
基本上这三个就可以支持采集网页
安装代码:
用pip安装调用代码:
pip install pymysql
pip install requests
pip install lxml
采集数据:
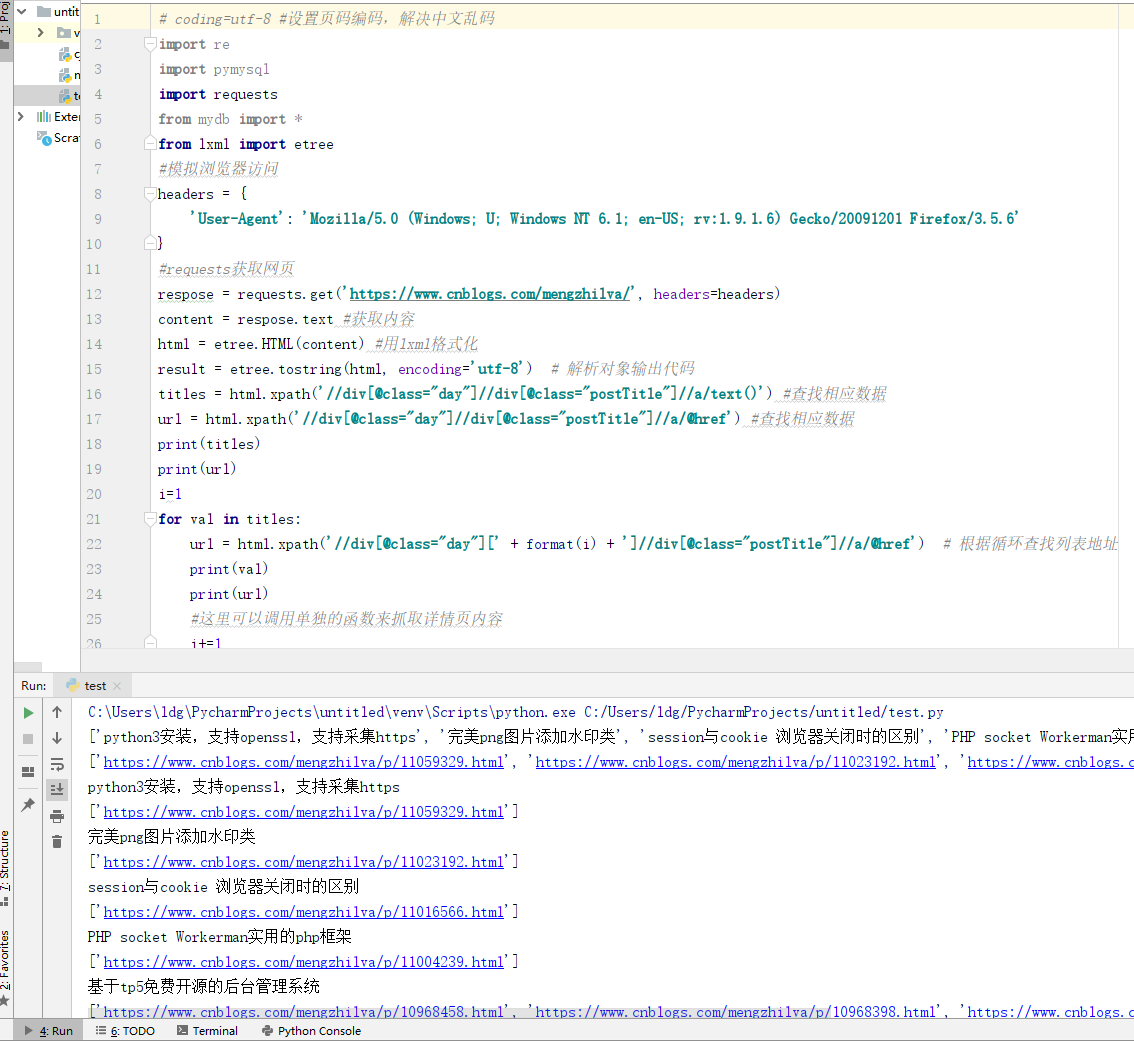
采集的代码和打印的结果:
# coding=utf-8 #设置页码编码,解决中文乱码
import re
import pymysql
import requests
from mydb import *
from lxml import etree
#模拟浏览器访问
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'
}
#requests获取网页
respose = requests.get('https://www.cnblogs.com/mengzhilva/', headers=headers)
content = respose.text #获取内容
html = etree.HTML(content) #用lxml格式化
result = etree.tostring(html, encoding='utf-8')  # 解析对象输出代码
titles = html.xpath('//div[@class="day"]//div[@class="postTitle"]//a/text()') #查找相应数据
url = html.xpath('//div[@class="day"]//div[@class="postTitle"]//a/@href') #查找相应数据
print(titles)
print(url)
i=1
for val in titles:
    url = html.xpath('//div[@class="day"][' + format(i) + ']//div[@class="postTitle"]//a/@href')  # 根据循环查找列表地址
    print(val)
    print(url)
    #这里可以调用单独的函数来抓取详情页内容
    i+=1
python爬虫采集的更多相关文章
- 基于Python爬虫采集天气网实时信息
相信小伙伴们都知道今冬以来范围最广.持续时间最长.影响最重的一场低温雨雪冰冻天气过程正在进行中.预计,今天安徽.江苏.浙江.湖北.湖南等地有暴雪,局地大暴雪,新增积雪深度4-8厘米,局地可达10- ...
- 抖音爬虫教程,python爬虫采集反爬策略
一.爬虫与反爬简介 爬虫就是我们利用某种程序代替人工批量读取.获取网站上的资料信息.而反爬则是跟爬虫的对立面,是竭尽全力阻止非人为的采集网站信息,二者相生相克,水火不容,到目前为止大部分的网站都还是可 ...
- python爬虫采集网站数据
1.准备工作: 1.1安装requests: cmd >> pip install requests 1.2 安装lxml: cmd >> pip install lxml ...
- python爬虫-采集英语翻译
http://fanyi.baidu.com/?aldtype=85#en/zh/drughttp://fanyi.baidu.com/?aldtype=85#en/zh/cathttp://fa ...
- 编写python爬虫采集彩票网站数据,将数据写入mongodb数据库
1.准备工作: 1.1安装requests: cmd >> pip install requests 1.2 安装lxml: cmd >> pip install lxml ...
- Python爬虫——城市公交、地铁站点和线路数据采集
本篇博文为博主原创,转载请注明. 城市公交.地铁数据反映了城市的公共交通,研究该数据可以挖掘城市的交通结构.路网规划.公交选址等.但是,这类数据往往掌握在特定部门中,很难获取.互联网地图上有大量的信息 ...
- python爬虫成长之路(一):抓取证券之星的股票数据
获取数据是数据分析中必不可少的一部分,而网络爬虫是是获取数据的一个重要渠道之一.鉴于此,我拾起了Python这把利器,开启了网络爬虫之路. 本篇使用的版本为python3.5,意在抓取证券之星上当天所 ...
- 批量下载小说网站上的小说(python爬虫)
随便说点什么 因为在学python,所有自然而然的就掉进了爬虫这个坑里,好吧,主要是因为我觉得爬虫比较酷,才入坑的. 想想看,你可以批量自动的采集互联网上海量的资料数据,是多么令人激动啊! 所以我就被 ...
- Python爬虫实战(4):豆瓣小组话题数据采集—动态网页
1, 引言 注释:上一篇<Python爬虫实战(3):安居客房产经纪人信息采集>,访问的网页是静态网页,有朋友模仿那个实战来采集动态加载豆瓣小组的网页,结果不成功.本篇是针对动态网页的数据 ...
随机推荐
- Noip模拟21(持续翻车)2021.7.20
读题总是读错是不是没救了... T1 Median 中位数:按顺序排列的一组数据中居于中间位置的数. 能用上的高亮符号都用上了... 当时忘了就离谱.... 理解什么是中位数(真是个憨憨)后就可以开始 ...
- 从四个方向分析我们可以从linux学到什么
我们真正关心的是自身可以从这个生态圈中获得些什么?说得更直白一点就是,我们可以从linux系统上面学到点什么,它对我们个人的成长和发展有哪些积极的因素.个人觉得,完全可以通过下面四个维度并结合自己的兴 ...
- Java并发:AbstractQueuedSynchronizer(AQS)
队列同步器 AbstractQueuedSynchronizer 是一个公共抽象类.提供一个同步器框架,用于实现依赖于先进先出(FIFO)等待队列的阻塞锁和相关同步器(信号量,事件等).使用一个 in ...
- HCNP Routing&Switching之BGP路由属性和优选规则
前文我们了解了BGP防环机制和路由聚合相关话题,回顾请参考https://www.cnblogs.com/qiuhom-1874/p/15458110.html:今天我们来聊一聊BGP路由属性和选路规 ...
- 第K个数 牛客网 程序员面试金典 C++ Python
第K个数 牛客网 程序员面试金典 C++ Python 题目描述 有一些数的素因子只有3.5.7,请设计一个算法,找出其中的第k个数. 给定一个数int k,请返回第k个数.保证k小于等于100. 测 ...
- 『学了就忘』Linux基础命令 — 18、Linux命令的基本格式
目录 1.命令提示符说明 2.命令的基本格式 (1)举例ls命令 (2)说明ls -l命令的 输出内容 1.命令提示符说明 [root@localhost ~] # []:这是提示符的分隔符号,没有特 ...
- scrapy 的response 的相关属性
Scrapy中response介绍.属性以及内容提取 解析response parse()方法的参数 response 是start_urls里面的链接爬取后的结果.所以在parse()方法中,我 ...
- 一、安装zabbix监控(源码编方式)
首先介绍一下zabbix的运行原理和运行条件. Zabbix监控原理 Zabbix 通过C/S 模式采集数据,通过B/S模式在web 端展示和配置. 被监控端:主机通过安装agent 方式采集数据, ...
- 【数据结构&算法】05-线性表之数组
目录 前言 线性结构与非线性结构 数组 数组的两个限制 数组的随机访问特性 数组的操作 插入操作 删除操作 数组越界 容器 数组下标 前言 本笔记主要记录数组的一些基础特性及操作. 顺便解答下为什么大 ...
- Django开发 X-Frame-Options to deny 报错处理
本博客已停更,请转自新博客查看 https://www.whbwiki.com/318.html 错误提示 Refused to display 'http://127.0.0.1:8000/inde ...