
编写python爬虫采集彩票网站数据,将数据写入mongodb数据库
1.准备工作:
1.1安装requests: cmd >> pip install requests
1.2 安装lxml: cmd >> pip install lxml
1.3安装wheel: cmd >> pip install wheel
1.4 安装xlwt: cmd >> pip install xlwt
1.5 安装pymongo: cmd >> pip install pymongo

完整代码
import requests

from lxml import etree

import xlwt

from pymongo import MongoClient

#设置浏览器的请求头,告诉服务器我们是从浏览器来的,作用是阻止被网站反爬

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36',

    'Accept-Encoding': 'gzip, deflate',

    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3',

    'Connection': 'keep-alive'

}

# 创建数据库

client = MongoClient()

database = client['Chapter6']

collection = database['webdata']

for i in range(1, 21):

    url = "http://kaijiang.zhcw.com/zhcw/html/3d/list_{}.html".format(i)

    #发送请求 得到数据

    response = requests.get(url=url,headers=headers)

    #print(response.text)

    #将数据改成xpath结构

    res_xpath = etree.HTML(response.text)

    trs = res_xpath.xpath('/html/body/table//tr')

    # 将数据写入MongoDB数据库

    for tr in trs[2:-1]:

        data = {

            '开奖日期': tr.xpath("./td[1]/text()")[0],

            '期号': tr.xpath("./td[2]/text()")[0],

            '中奖号码1': tr.xpath("./td[3]/em[1]/text()")[0],

            '中奖号码2': tr.xpath("./td[3]/em[2]/text()")[0],

            '中奖号码3': tr.xpath("./td[3]/em[3]/text()")[0],

            '销售额(元)': tr.xpath("./td[4]/text()")[0],

            '返奖比例': tr.xpath("./td[5]/text()")[0]

        }

        collection.insert_one(data);
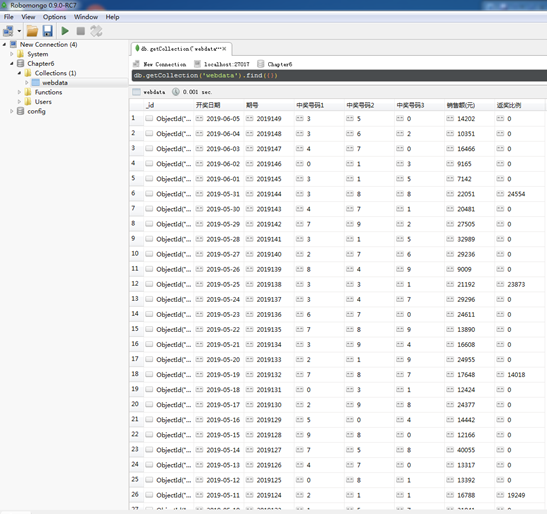
实现效果
编写python爬虫采集彩票网站数据,将数据写入mongodb数据库的更多相关文章
- python爬虫采集
python爬虫采集 最近有个项目需要采集一些网站网页,以前都是用php来做,但现在十分流行用python做采集,研究了一些做一下记录. 采集数据的根本是要获取一个网页的内容,再根据内容筛选出需要的数 ...
- python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式)
python爬虫之天气预报网站--查看最近(15天)的天气信息(正则表达式) 思路: 1.首先找到一个自己想要查看天气预报的网站,选择自己想查看的地方,查看天气(例:http://www.tianqi ...
- python爬虫之12306网站--火车票信息查询
python爬虫之12306网站--火车票信息查询 思路: 1.火车票信息查询是基于车站信息查询,先完成车站信息查询,然后根据车站信息查询生成的url地址去查询当前已知出发站和目的站的所有车次车票信息 ...
- python爬虫之小说网站--下载小说(正则表达式)
python爬虫之小说网站--下载小说(正则表达式) 思路: 1.找到要下载的小说首页,打开网页源代码进行分析(例:https://www.kanunu8.com/files/old/2011/244 ...
- Python爬虫教程-18-页面解析和数据提取
本篇针对的数据是已经存在在页面上的数据,不包括动态生成的数据,今天是对HTML中提取对我们有用的数据,去除无用的数据 Python爬虫教程-18-页面解析和数据提取 结构化数据:先有的结构,再谈数据 ...
- 一个月入门Python爬虫,轻松爬取大规模数据
Python爬虫为什么受欢迎 如果你仔细观察,就不难发现,懂爬虫.学习爬虫的人越来越多,一方面,互联网可以获取的数据越来越多,另一方面,像 Python这样的编程语言提供越来越多的优秀工具,让爬虫变得 ...
- Python爬虫某招聘网站的岗位信息
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:阿尔法游戏 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- Python爬虫(九)_非结构化数据与结构化数据
爬虫的一个重要步骤就是页面解析与数据提取.更多内容请参考:Python学习指南 页面解析与数据提取 实际上爬虫一共就四个主要步骤: 定(要知道你准备在哪个范围或者网站去搜索) 爬(将所有的网站的内容全 ...
- Python爬虫:用BeautifulSoup进行NBA数据爬取
爬虫主要就是要过滤掉网页中没用的信息.抓取网页中实用的信息 一般的爬虫架构为: 在python爬虫之前先要对网页的结构知识有一定的了解.如网页的标签,网页的语言等知识,推荐去W3School: W3s ...
随机推荐
- XSS这段时间的学习总结
0X01利用平台payload获取COOKIE 本机IP 192.168.1.100 靶机win7 192.168.1.102 我们先创建一个cookie的项目 然后在可以执行xss的地方插入我们的恶 ...
- sqli-labs(44)
第四十四关 本关是基于盲注的,这里盲注主要是要没有报错信息,所以要采用盲注.这关与42关的区别就在于没有报错信息 过滤点: $username = mysqli_real_escape_string( ...
- STS(Spring tool suite)集成配置jdk,maven和Tomcat
STS是spring官网的一个集成开发工具,最近在学springboot,所以用了. 在本文中将介绍如下内容: 搭建开发的 JDK(1.8) 环境. 配置 Maven 环境. 配置 Tomcat 环境 ...
- Excel导入导出工具(简单、好用且轻量级的海量Excel文件导入导出解决方案.)
Excel导入导出工具(简单.好用且轻量级的海量Excel文件导入导出解决方案.) 置顶 2019-09-07 16:47:10 $9420 阅读数 261更多 分类专栏: java 版权声明:本 ...
- React 开发中面临的九个重要抉择
抉择系列:在技术开发的过程中我们会面临着各种各样的抉择,我们在不同情境下该如何选择恰当的技术,这是本系列文章想要解决的问题. 在 React 开发的过程中我们常常会遇到一些抉择,下面我将选取其中一些个 ...
- C++入门经典-例5.18-通过引用交换数值
1:在C++中,函数参数的传递方式主要有两种,即值传递和引用传递.值传递是指在函数调用时,将实际参数的值赋值一份传递到调用函数中,这样如果在调用函数中修改了参数的值,其改变将不会影响到实际参数的值.而 ...
- 三、smarty--变量调节器(修改器)
变量调节器(修改器) 作用: 1. 从PHP中分配个模板的变量 2. 需要模板中对变量在输出前进行处理 3. 处理方式就是使用“函数” 4. 在smarty3中可以直接调用到PHP的函数 5. ...
- 【Spark机器学习速成宝典】模型篇06随机森林【Random Forests】(Python版)
目录 随机森林原理 随机森林代码(Spark Python) 随机森林原理 参考:http://www.cnblogs.com/itmorn/p/8269334.html 返回目录 随机森林代码(Sp ...
- Android 开源控件与常用开发框架开发工具类
Android的加载动画AVLoadingIndicatorView 项目地址: https://github.com/81813780/AVLoadingIndicatorView 首先,在 bui ...
- Ruby小白入门笔记之<个人记录档>
书写缘由 快两年的JAVA开发,因为来到一家新公司,产品需要用Ruby开发,故此才有了这从头开始,一入编程深似海啊...... 因为入门时是JAVA,所以理念跟规范早已形成,故此感觉突然采用Ruby编 ...