
Tesseract-OCR-v5.0中文识别,训练自定义字库,提高图片的识别效果
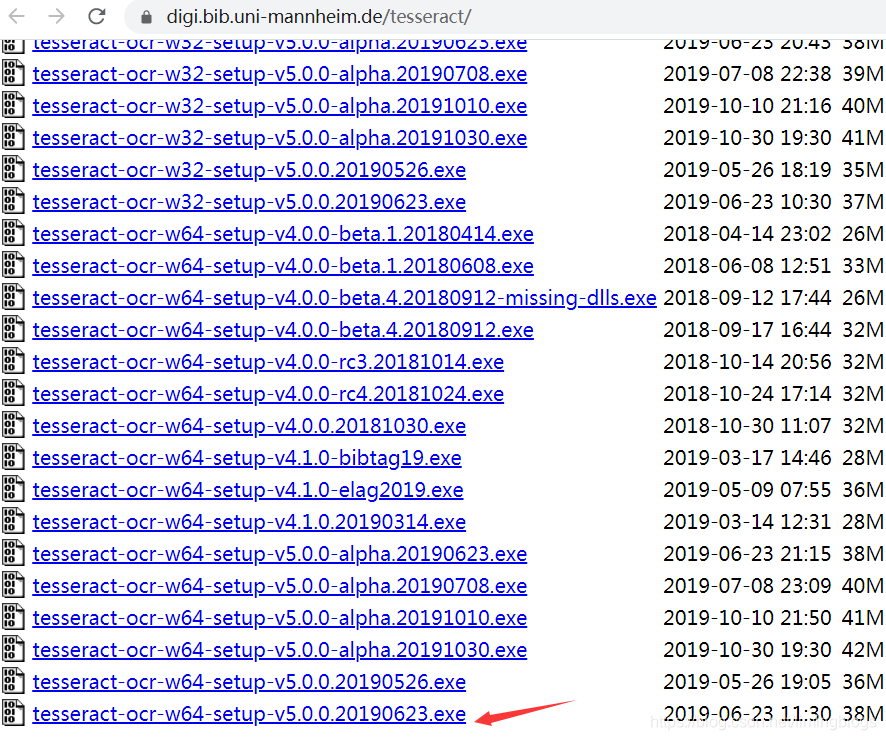
1,下载安装Tesseract-OCR 安装,链接地址https://digi.bib.uni-mannheim.de/tesseract/

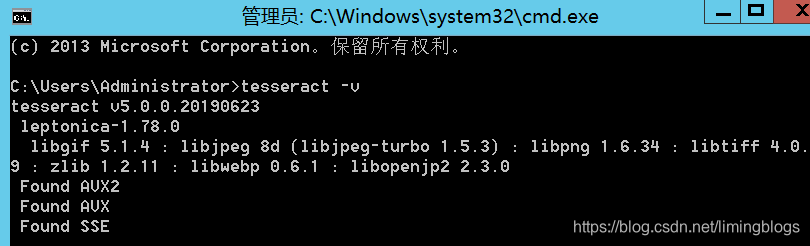
2,安装成功 tesseract -v
注意:安装后,要添加系统环境变量
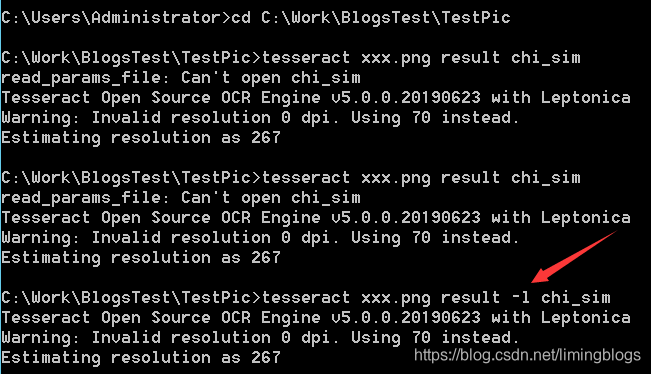
3,cmd指定目录到 cd C:\Work\BlogsTest\TestPic,要识别图片的文件夹 识别:tesseract test.png result -l chi_sim
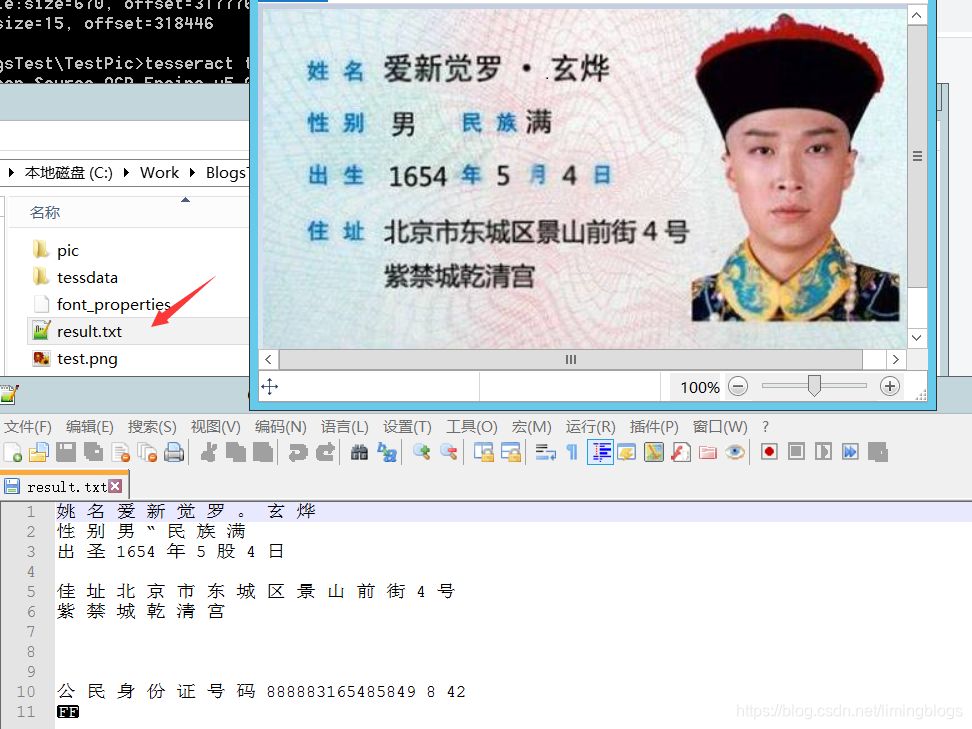
识别成功的效果,result.txt文件会自动生成
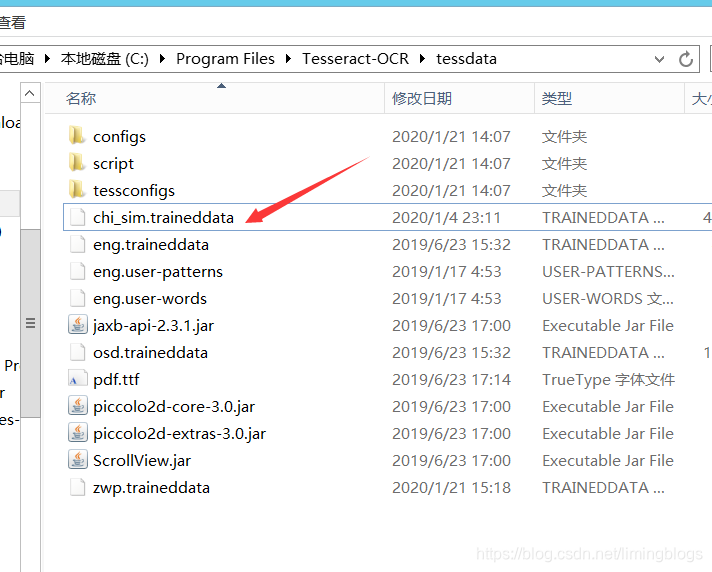
要注意:Tesseract-OCR的安装目录要包含识别中文的字符集chi_sim.traineddata,可以在GitHub下载https://github.com/tesseract-ocr/tessdata
4,可见第3步的识别效果不是很好,想到通过训练自定义字库,提高图片的识别效果
(0)下载安装jTessBoxEditor,https://sourceforge.net/projects/vietocr/files/jTessBoxEditor/
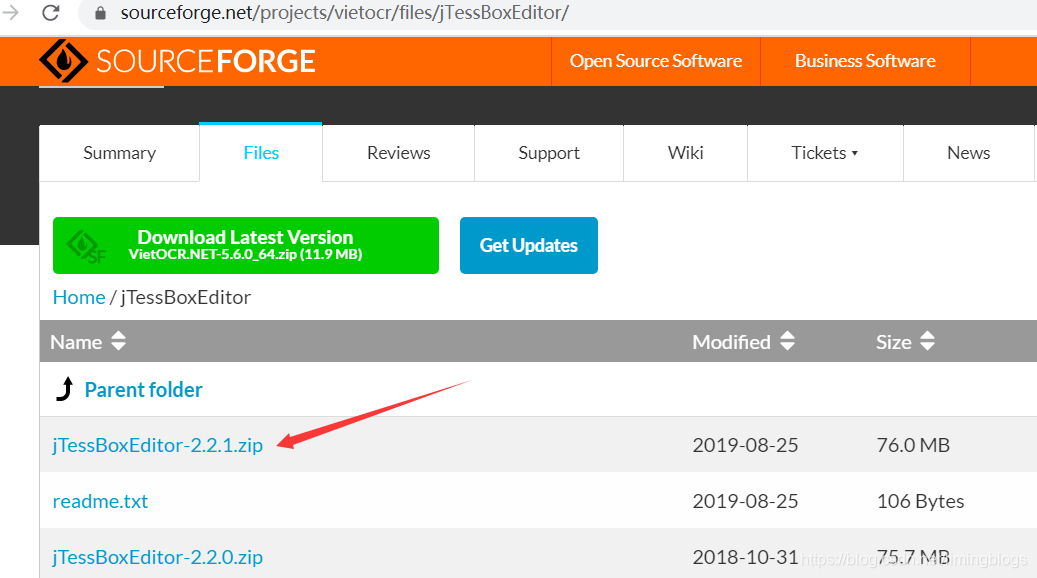
注意要安装JavaRuntime
(1)打开jTessBoxEditor,选择Tools->Merge TIFF,进入训练样本所在文件夹,选中要参与训练的样本图片:
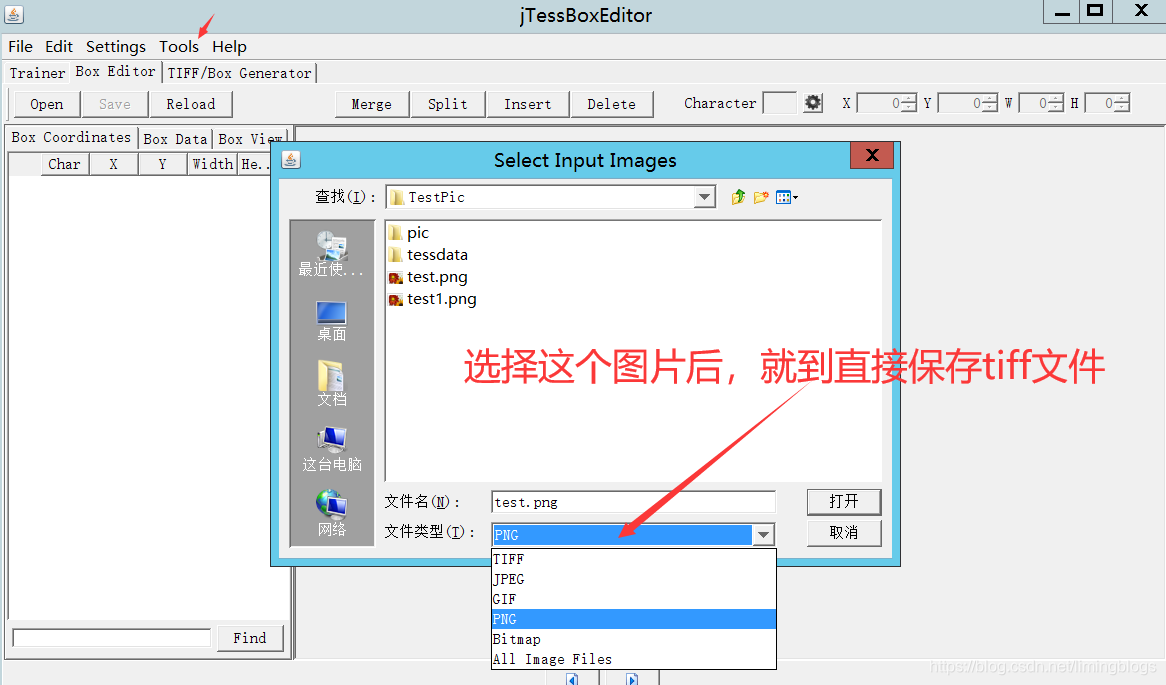
(2)点击 “打开” 后弹出保存对话框,选择保存在当前路径下,文件命名为 “qq66.test.exp0.tif” ,格式只有一种 “TIFF” 可选。
tif文面命名格式[lang].[fontname].exp[num].tif
lang是语言,fontname是字体,num为自定义数字。
比如我们要训练自定义字库 qq66,字体名test,那么我们把图片文件命名为 qq66.test.exp0.tif
(3)使用tesseract生成.box文件
tesseract qq66.test.exp0.tif qq66.test.exp0 -l chi_sim --psm 6 batch.nochop makebox
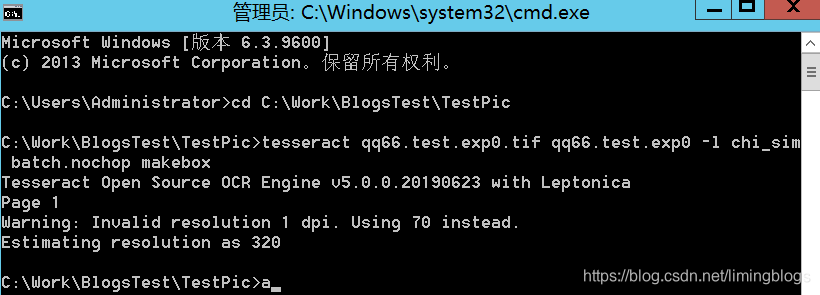
注意:--psm的语法,数字对应不同的 页面分割模式。
(4)使用jTessBoxEditor矫正.box文件的错误
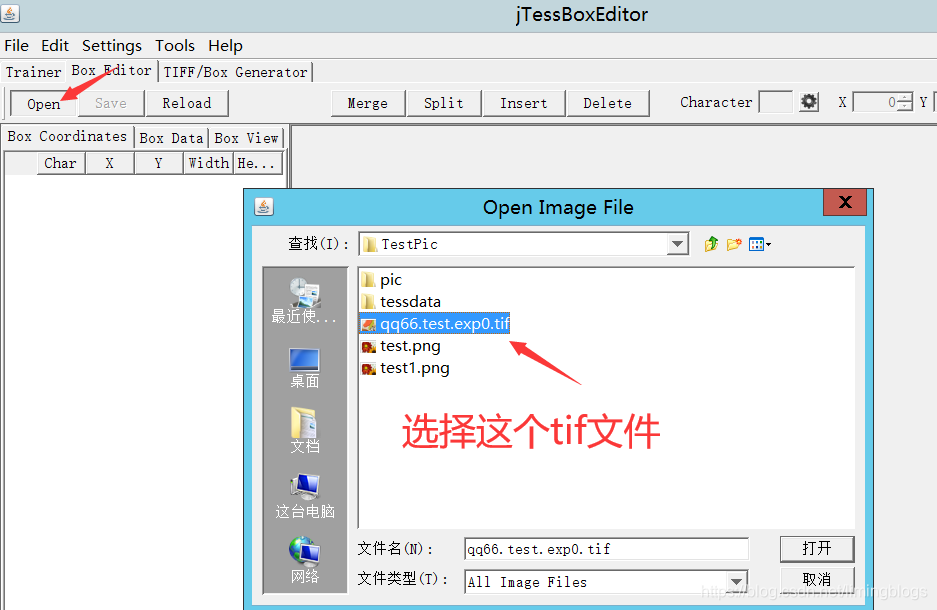
打开后矫正后,点击 save
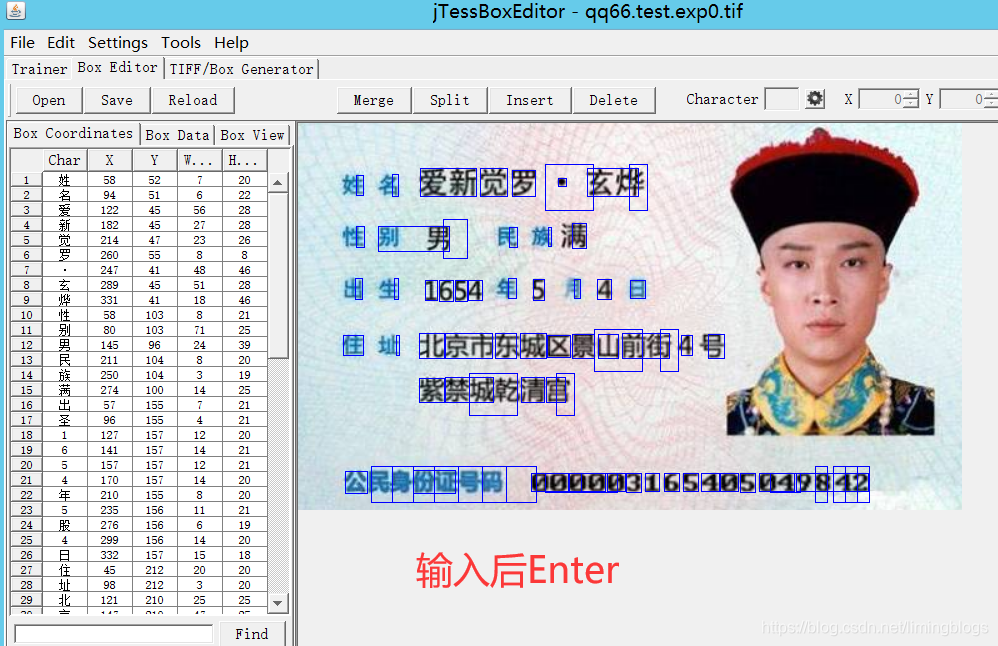
(5)生成font_properties文件:(该文件没有后缀名)
执行命令,执行完之后,会在当前目录生成font_properties文件
echo test 0 0 0 0 0 >font_properties
也可以手工新建一个名为font_properties的文本文件,输入内容 “test 0 0 0 0 0” 表示字体test的粗体、倾斜等共计5个属性。这里的“test”必须与“qq66.test.exp0.box”中的“test”名称一致。
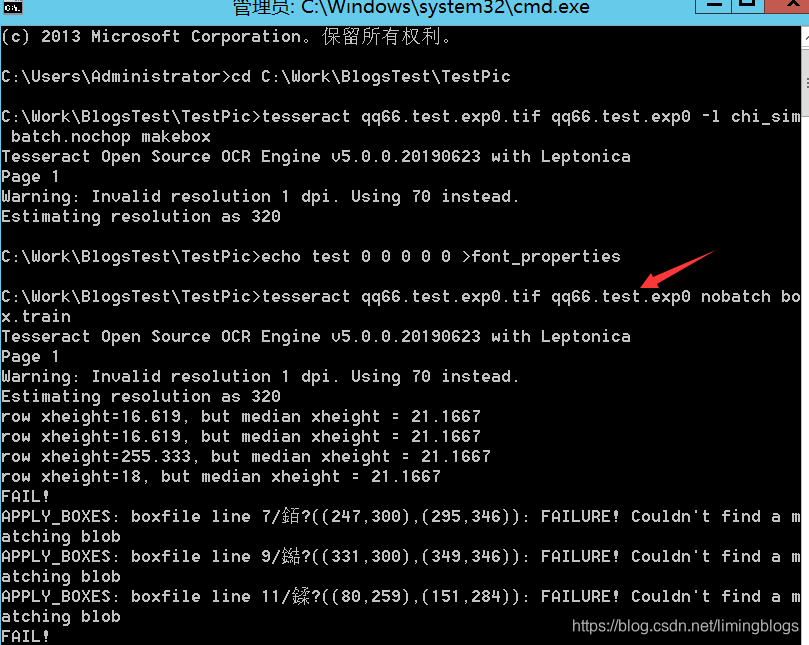
(6)使用tesseract生成.tr训练文件
执行下面命令,执行完之后,会在当前目录生成qq66.test.exp0.tr文件。
tesseract qq66.test.exp0.tif qq66.test.exp0 nobatch box.train
(7)生成字符集文件:
执行下面命令:执行完之后会在当前目录生成一个名为“unicharset”的文件。
unicharset_extractor qq66.test.exp0.box
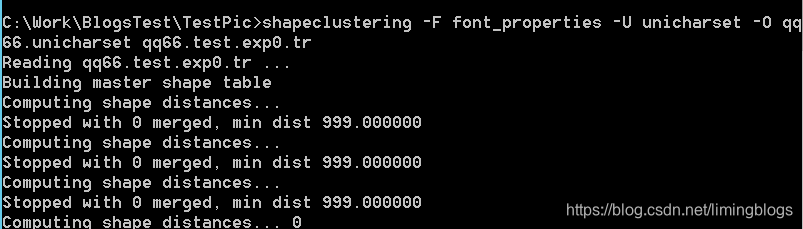
(8)生成shape文件:
执行下面命令,执行完之后,会生成 shapetable 和 zwp.unicharset 两个文件。
shapeclustering -F font_properties -U unicharset -O qq66.unicharset qq66.test.exp0.tr
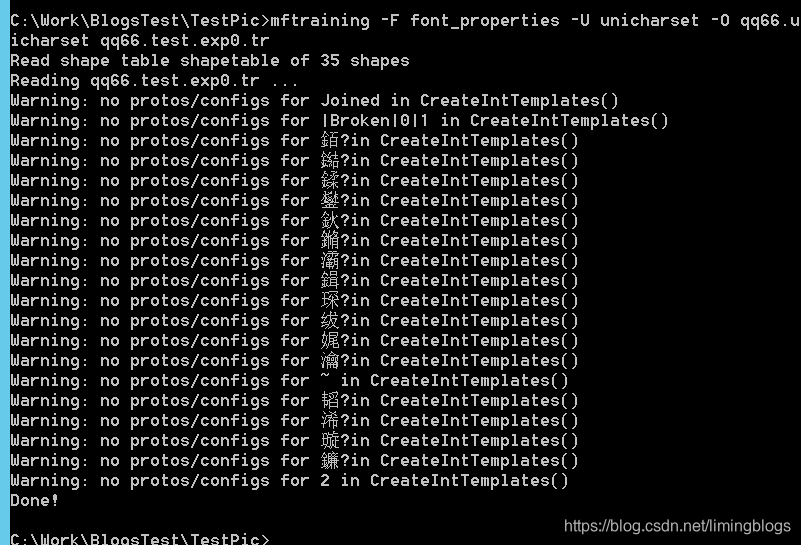
(8)生成聚字符特征文件
执行下面命令,会生成 inttemp、pffmtable、shapetable和zwp.unicharset四个文件。
mftraining -F font_properties -U unicharset -O qq66.unicharset qq66.test.exp0.tr
(9)生成字符正常化特征文件
执行下面命令,会生成 normproto 文件。
cntraining qq66.test.exp0.tr

(10)文件重命名
重新命名inttemp、pffmtable、shapetable和normproto这四个文件的名字为[lang].xxx。
这里修改为qq66.inttemp、qq66.pffmtable、qq66.shapetable和qq66.normproto
(11)合并训练文件
执行下面命令,会生成qq66.traineddata文件。
combine_tessdata qq66.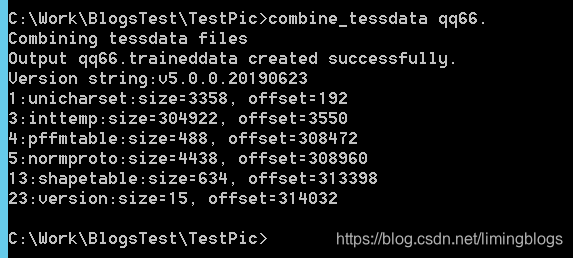
最后文件目录
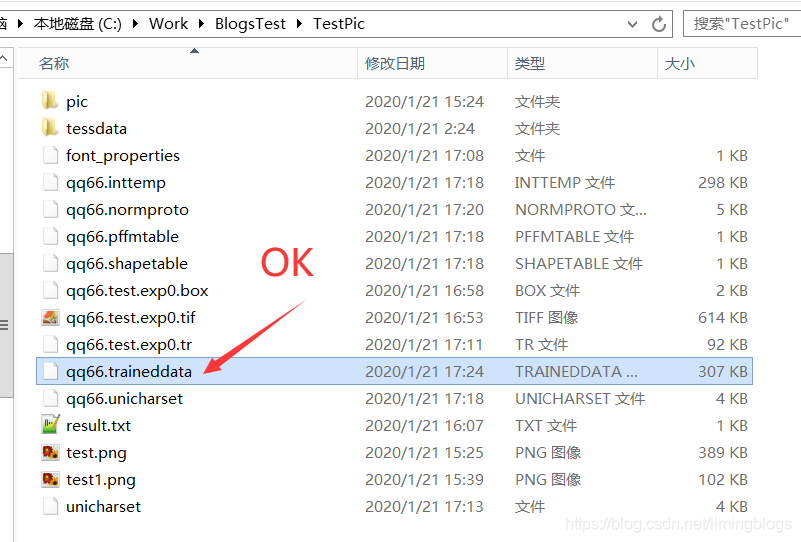
5,用新生成的qq66.traineddata字符集,重新识别身份证
6,可以同时选择多个不同的样本生成box文件

7,在原有训练数据的基础上,加入新的字符训练信息
经研究找到实用合并方法(红色部分为示例,实际应为你自己生成的文件名):
在新的训练数据生成.box 和.tr文件后,
生成字符集 unicharset_extractor add.font.exp0.box new.font.exp0.box
合并训练数据(.tr)
mftraining -F font_properties -U unicharset -O added.unicharset add.font.exp0.tr new.font.exp0.tr
聚合所有的tr文件:
cntraining add.font.exp0.tr new.font.exp0.tr
8,设置图片分割模式
Page segmentation modes:
0 = Orientation and script detection (OSD) only.
1 = Automatic page segmentation with OSD.
2 = Automatic page segmentation, but no OSD, or OCR
3 = Fully automatic page segmentation, but no OSD. (Default)
4 = Assume a single column of text of variable sizes.
5 = Assume a single uniform block of vertically aligned text.
6 = Assume a single uniform block of text.
7 = Treat the image as a single text line.
8 = Treat the image as a single word.
9 = Treat the image as a single word in a circle.
10 = Treat the image as a single character.
例如:
tesseract test.png result -l chi_sim -psm 7 nobatch
Tesseract-OCR-v5.0中文识别,训练自定义字库,提高图片的识别效果的更多相关文章
- 【Python项目】使用Face++的人脸识别detect API进行本地图片情绪识别并存入excel
准备工作 首先,需要在Face++的主页注册一个账号,在控制台去获取API Key和API Secret. 然后在本地文件夹准备好要进行情绪识别的图片/相片. 代码 介绍下所使用的第三方库 ——url ...
- Yii2.0中文开发向导——自定义日志文件写日志
头部引入log类use yii\log\FileTarget; $time = microtime(true);$log = new FileTarget();$log->logFile = Y ...
- 第二十三节:scrapy爬虫识别验证码(二)图片验证码识别
图片验证码基本上是有数字和字母或者数字或者字母组成的字符串,然后通过一些干扰线的绘制而形成图片验证码. 例如:知网的注册就有图片验证码 首先我们需要获取验证码图片,通过开发者工具我们可以得到验证码ur ...
- pytesseract在识别只有一个数字的图片时识别不出来
大家好,近期在做自动化测试时,遇到了一个问题需要通过识别图片来实现,遂用到了pytesseract模块和tesseract-ocr这个工具.在使用过程中发现,识别带有数字的图片时,如果这个图片上仅有一 ...
- Tesseract-OCR4.0识别中文与训练字库实例
关于中文的识别,效果比较好而且开源的应该就是Tesseract-OCR了,所以自己亲身试用一下,分享到博客让有同样兴趣的人少走弯路. 文中所用到的身份证图片资源是百度找的,如有侵权可联系我删除. 一. ...
- Tesseract-OCR识别中文与训练字库
转自:https://www.cnblogs.com/lcawen/articles/7040005.html 关于中文的识别,效果比较好而且开源的应该就是Tesseract-OCR了,所以自己亲身试 ...
- Tesseract-OCR识别中文与训练字库实例
关于中文的识别,效果比较好而且开源的应该就是Tesseract-OCR了,所以自己亲身试用一下,分享到博客让有同样兴趣的人少走弯路. 文中所用到的身份证图片资源是百度找的,如有侵权可联系我删除. 一. ...
- 开源图片文字识别引擎——Tesseract OCR
Tessseract为一款开源.免费的OCR引擎,能够支持中文十分难得.虽然其识别效果不是很理想,但是对于要求不高的中小型项目来说,已经足够用了. 文字识别可应用于许多领域,如阅读.翻译.文献资料的检 ...
- 深入学习Tesseract-ocr识别中文并训练字库的方法
上篇文章简单的学习了tesseract-ocr识别图片中的英文(链接地址如下:https://www.cnblogs.com/wj-1314/p/9428909.html),看起来效果还不错,所以这篇 ...
随机推荐
- H3C 根据子网掩码计算子网数
- vue 使用webpack打包后路径报错以及 alias 的使用
一.vue 使用webpack打包后路径报错(两步解决) 1. config文件夹 ==> index.js ==> 把assetsPublicPath的 '/ '改为 './' 2. b ...
- vue-learning:32 - component - 异步组件和工厂函数
异步组件 只有在这个组件需要使用的时候才从服务器加载这一个组件模块,用于渲染,并且会把结果缓存起来供未来复用. 实现方法: 组件定义的时候,以一个工厂函数的形式传入,在需要组件的执行这个函数,然后将组 ...
- ASP.NET MVC4.0+EF+LINQ+bui+bootstrap+网站+角色权限管理系统(开篇)
系统预览: 源码下载:http://www.yealuo.com/Home/Detail?KeyValue=2f926407-f80b-4bff-a729-949a53efed7b 创建项目,新手按步 ...
- 记一次奇葩事——html5可能不支持window.onscroll函数
只在html5里遇到,html4没事:拿出来聊聊,路过帮忙解答下!!! 不正常的 <!doctype html><html><head><meta chars ...
- Java零散记录
接口不能被实例化,所以其成员变量必须为不可修改的,就是常量.
- apply call 用法
1.对象转数组 tips 先看怎么用 再研究方法原理 var obj = { 0: 'qian', 1: 'long', 2: 'chu', 3: 'tian', ...
- Qt4与Qt3的主要不同
Qt4与Qt3的主要不同 1)QT4 中提供了大量新控件,虽然它也保持了旧的控件,并命名为Qt3XXX,但是这样的控件没准在今后的哪个QT版本中就不被支持了,所以还是换吧,控件替换的 工作是巨大的,这 ...
- 盘一盘 Thread源码
线程是操作系统能够进行运算调度的最小单位.它被包含在进程之中,是进程中的实际运作单位.一条线程指的是进程中一个单一顺序的控制流,一个进程中可以并发多个线程,每条线程并行执行不同的任务. 继承关系图 线 ...
- 利用Aspose.cells 将查询出的数据导出为excel,并在浏览器中下载。
正题前的唠叨 本人是才出来工作不久的小白菜一颗,技术很一般,总是会有遇到一些很简单的问题却不知道怎么做,这些问题可能是之前解决过的.发现这个问题,想着提升一下自己的技术水平,将一些学的新的‘好’东西记 ...