
Tesseract-OCR4.0识别中文与训练字库实例
关于中文的识别,效果比较好而且开源的应该就是Tesseract-OCR了,所以自己亲身试用一下,分享到博客让有同样兴趣的人少走弯路。
文中所用到的身份证图片资源是百度找的,如有侵权可联系我删除。
一、准备工作
1、下载Tesseract-OCR引擎,注意要3.0以上才支持中文哦,按照提示安装就行。
最后下载4.0版本
2、下载chi_sim.traindata字库。要有这个才能识别中文。下好后,放到Tesseract-OCR项目的tessdata文件夹里面。
https://github.com/tesseract-ocr/tessdata/blob/master/chi_sim.traineddata
3、下载jTessBoxEditor,这个是用来训练字库的。
https://sourceforge.net/projects/vietocr/files/jTessBoxEditor/jTessBoxEditor-1.7.3.zip/download
- 为了识别方便建议放到环境变量中.
二、识别
1、进入cmd,进入到要识别的图片的路径下。
-解决bug
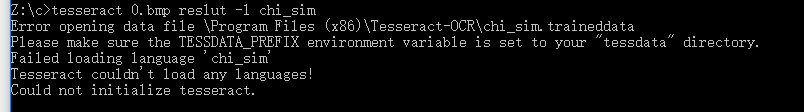
出现了这个错误. 下面的意思就是说不能加载’eng’语言包。请将tessdata的父文件夹路径设置为TESSDATA_PREFIX环境变量值,这个就是说在环境变量中新建一个系统变量,变量名称为TESSDATA_PREFIX,tessdata是放置语言包的文件夹,一般在你安装tesseract的目录下,即tesseract的安装目录就是tessdata的父目录,把TESSDATA_PREFIX的值设置为它就行了
2、输入命令
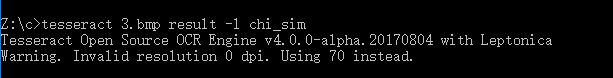
tesseract 图片名称 生成的结果文件的名称 字库
例如我的图片识别就是:
tesseract test.jpg result -l chi_sim
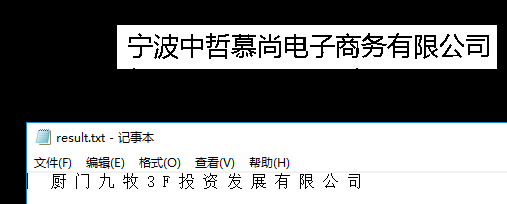
识别完后会生成result.txt文件
三、训练
1、将图片转换成tif格式,用于后面生成box文件。可以通过画图,然后另存为tif即可。
更改图片名字,这个是有要求的=。=
tif文面命名格式[lang].[fontname].exp[num].tif
lang是语言 fontname是字体
比如我们要训练自定义字库 mjorcen字体名normal
那么我们把图片文件重命名 mjorcen.normal.exp0.jpg在转tif。
2、生成box文件。
tesseract mjorcen.normal.exp0.jpg mjorcen.normal.exp0 -l chi_sim batch.nochop makebox
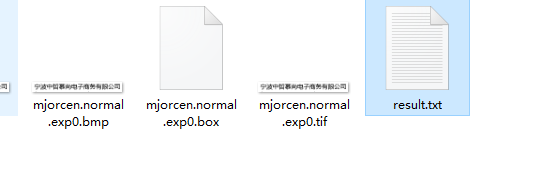
box文件和对应的tif一定要在相同的目录下,不然后面打不开。
3、打开jTessBoxEditor矫正错误并训练
打开train.bat

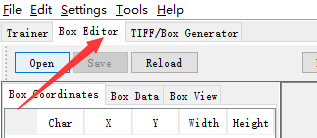
找到tif图,打开,并校正。切换到图片所指的路径
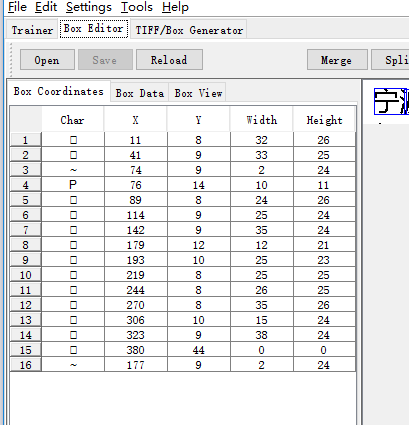
出现乱码 这是因为你软件设置字体的问题
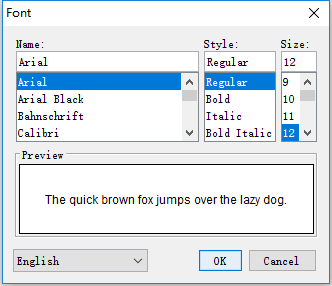
在setting>font 设置中文字体
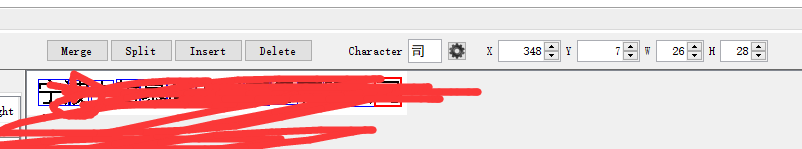
进行矫正 主要就是坐标 位置的调整,注意 添加需要选择上一个文字才能分离
Tesseract-OCR4.0识别中文与训练字库实例的更多相关文章
- Tesseract-OCR识别中文与训练字库实例
关于中文的识别,效果比较好而且开源的应该就是Tesseract-OCR了,所以自己亲身试用一下,分享到博客让有同样兴趣的人少走弯路. 文中所用到的身份证图片资源是百度找的,如有侵权可联系我删除. 一. ...
- 深入学习Tesseract-ocr识别中文并训练字库的方法
上篇文章简单的学习了tesseract-ocr识别图片中的英文(链接地址如下:https://www.cnblogs.com/wj-1314/p/9428909.html),看起来效果还不错,所以这篇 ...
- Tesseract-OCR识别中文与训练字库
转自:https://www.cnblogs.com/lcawen/articles/7040005.html 关于中文的识别,效果比较好而且开源的应该就是Tesseract-OCR了,所以自己亲身试 ...
- Tesseract识别图片提取文字&字库训练
文中测试了3.0和4.0两个版本.发现3.0识别效率不准确,需要训练词库.4.0识别效率就比较高了,而且支持结果生成pdf.txt等格式.所以推荐使用4.0版本. 这个工具可以用在爬虫的时候获取验证码 ...
- Tesseract5.0训练字库,提高OCR特殊场景识别率(一)
0.目标 很多特殊场景,原生的字库识别率不高,这时候就需要根据需求自己训练字库生成traineddata文件. 一.前期准备工作 1.安装jdk 用于运行jTessBoxEditor 2.安装jT ...
- Windows下Tesseract4.0识别与中文手写字体训练
一 . tesseract 4.0 安装及使用 1. tesseract 4.0 安装 安装包下载地址: http://digi.bib.uni-mannheim.de/tesseract/tesse ...
- tesseract-ocr如何训练Tesseract 4.0
引自:https://blog.csdn.net/huobanjishijian/article/details/76212214 原文:https://github.com/tesseract-oc ...
- 【OpenCV】opencv3.0中的SVM训练 mnist 手写字体识别
前言: SVM(支持向量机)一种训练分类器的学习方法 mnist 是一个手写字体图像数据库,训练样本有60000个,测试样本有10000个 LibSVM 一个常用的SVM框架 OpenCV3.0 中的 ...
- tesseract 4.0 ocr图像识别利器,可识别文字。图片越高清越准确
//总地址 https://github.com/tesseract-ocr/tesseract/wiki //windows exe tesseract 4.0下载: https://github. ...
随机推荐
- 设计模式——单例设计模式(C++实现)
#ifndef SINGLETONHOLDER_INC #define SINGLETONHOLDER_INC template<class T> class SingletonHolde ...
- Python 3.6.4 / win10 使用pip安装keras时遇到依赖的PyYAML安装出错
PS C:\Users\myjac\Desktop\simple-chinese-ocr> pip install keras Collecting keras Downloading http ...
- ABAP调试
ABAP 开发系列(02): ABAP Development Workbench 介绍(下)- ABAP 调试器 8. Debugger – ABAP 调试器 开发程序,调试器是必不可少的工具,而A ...
- IPFS网络是如何运行的(p2p网络)
IPFS是一个p2p网络,先来看看BitTorrent的p2p网络是如何工作的? 想要bt下载一个文件,首先你需要一个种子文件torrent,种子文件包含至少一个 Tracker(一台服务器地址)信息 ...
- business expressions(二)
1,to give someone a heads up = to inform someone about something important ("heads up") be ...
- javap -c命令关键字的含义
jdk提供了javap命令用于查看字节码来查看程序执行赋值的顺序,看懂这些关键字可以很好的理解程序执行的过程 转自:http://www.cnblogs.com/duanxz/archive/2014 ...
- poj-1131-(大数)八进制转化成十进制
Description Fractions in octal (base 8) notation can be expressed exactly in decimal notation. For e ...
- centos下mongodb备份(dump)与还原(restore)
数据服务器,数据库采用mongodb数据库 安装:通过增加配置安装mongodb-org,版本为3.0.7,yum安装 yum install mongodb-org 数据备份与 ...
- (转)关于 awk 的 pattern(模式)
本文转自chinaunix http://bbs.chinaunix.net/thread-4246512-1-1.html 作者reyleon 我们知道, awk程序由一系列 pattern 以 ...
- bug单的生命周期
测试工程师发现了软件的缺陷(bug),那修复bug的整个流程是怎么样的呢? 1.发现bug 2.和开发确认是否是bug 3.如果是bug则提bug单到测试经理,如果不是则放过 4.测试经理把bug单走 ...